สารบัญ
Embedding คืออะไร ตัวเลขที่ AI ใช้แทนความหมาย
ฮัลโหล แมวส้มเองครับ เคยสงสัยไหมครับ ว่า AI รู้ได้ยังไงว่า “ร้านกาแฟปลั๊กเยอะ” กับ “co-working cafe มีเต้ารับ” คือเรื่องเดียวกัน ทั้งที่แทบไม่มีคำซ้ำกัน ความลับอยู่ที่ AI เก็บ “ความหมาย” ไว้เป็นตัวเลข อ่านจบคุณจะเข้าใจผ่านรหัสสี และได้โค้ดสั้น ๆ ไว้ลองเอง
Embedding คือชุดตัวเลขยาวๆ ที่ AI ใช้แทนความหมายของข้อความ รูป หรือข้อมูลอื่น ของที่ความหมายใกล้กันจะได้ตัวเลขที่อยู่ใกล้กัน ภาษาไทยมักเรียกว่า “เอ็มเบดดิง” หรือ “เวกเตอร์แทนความหมาย”
หรือจะพูดแบบภาษาบ้าน ๆ ก็คือ “พิกัดของความหมาย” นั่นเอง แยกคำดู Embed แปลว่า ฝังลงไป จำง่าย ๆ ว่าเป็นความหมายที่ถูกฝังลงในชุดตัวเลข
เอกสารของ OpenAI (บริษัทผู้ทำ ChatGPT) นิยามสั้นๆ ว่า embedding คือ vector หรือรายการตัวเลขทศนิยมที่เรียงกัน ถ้าสอง vector อยู่ห่างกันน้อย แปลว่าสองสิ่งนั้นเกี่ยวข้องกันมาก ไปดูภาพเปรียบเทียบกันก่อน
Embedding เปรียบง่ายๆ เหมือนอะไร
นึกถึงรหัสสีในโปรแกรมแต่งรูป สีส้มแมวส้มอาจเป็น R 255 G 140 B 0 ส่วนสีส้มอิฐอาจเป็น R 230 G 120 B 40 ตัวเลขใกล้กัน สีก็คล้ายกัน
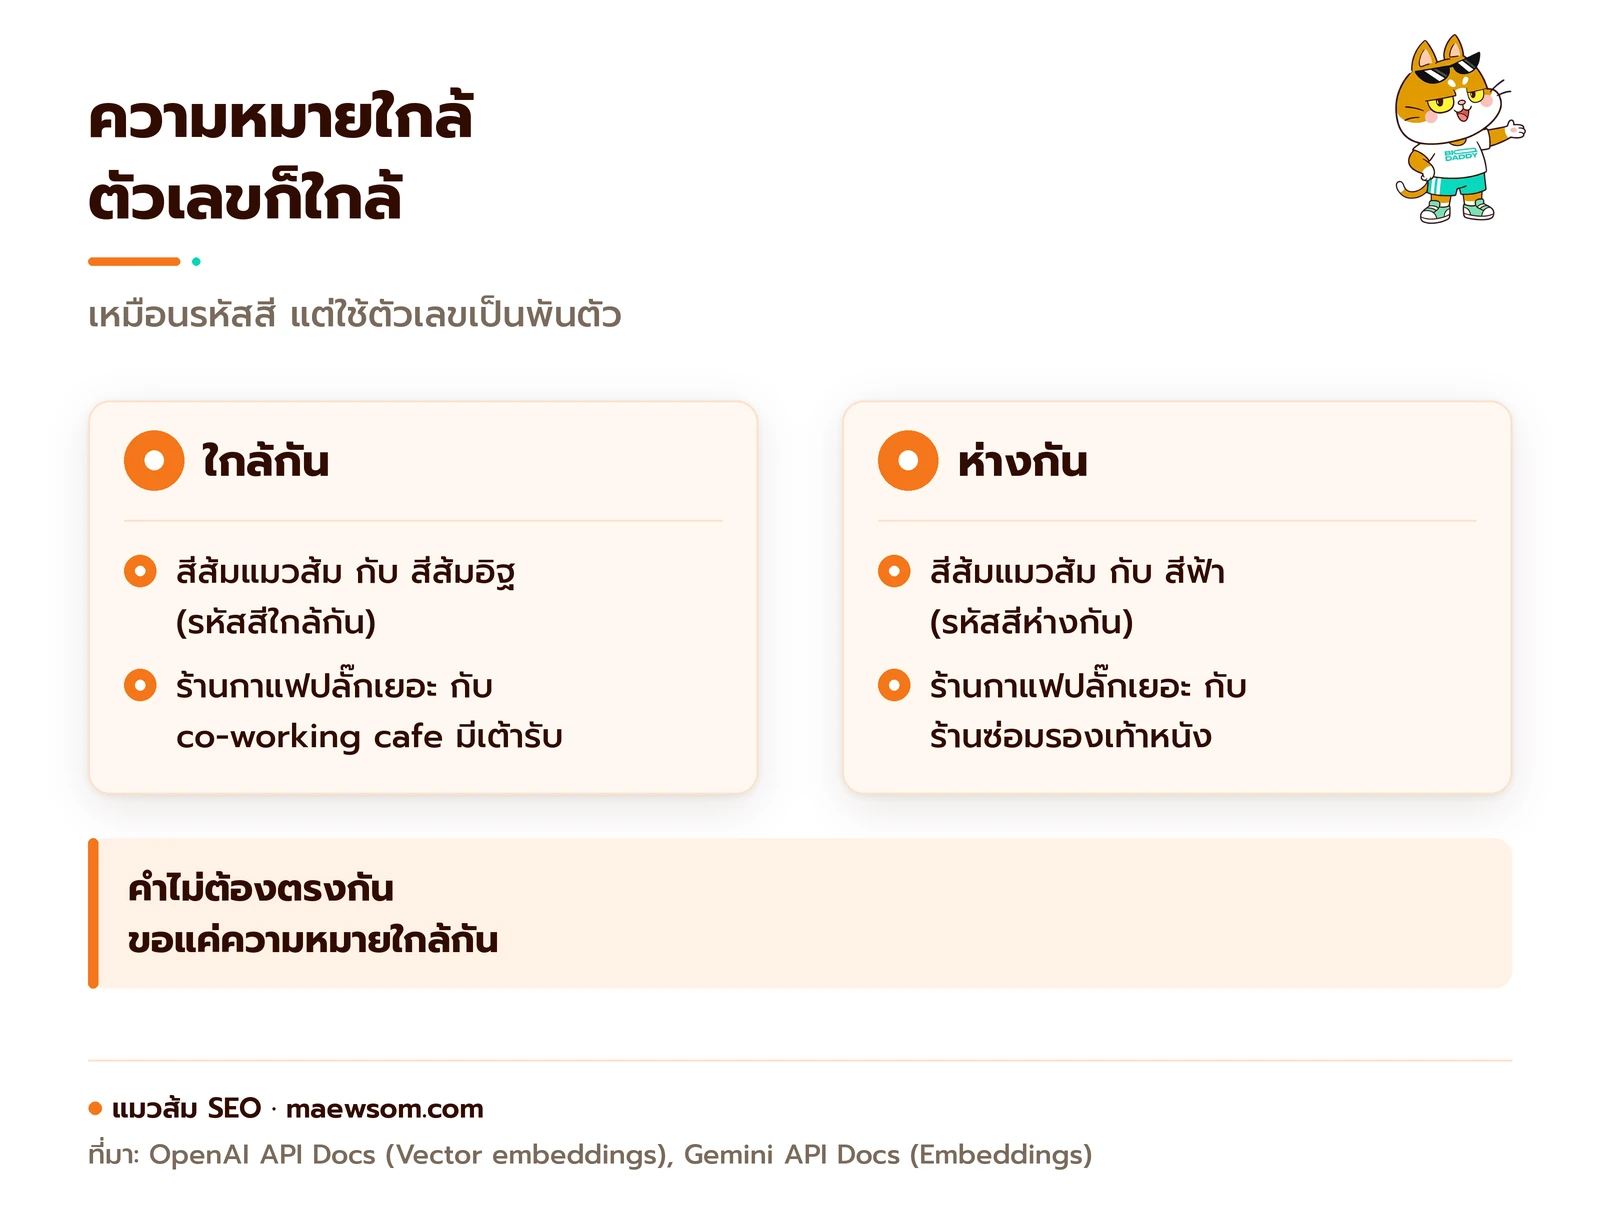
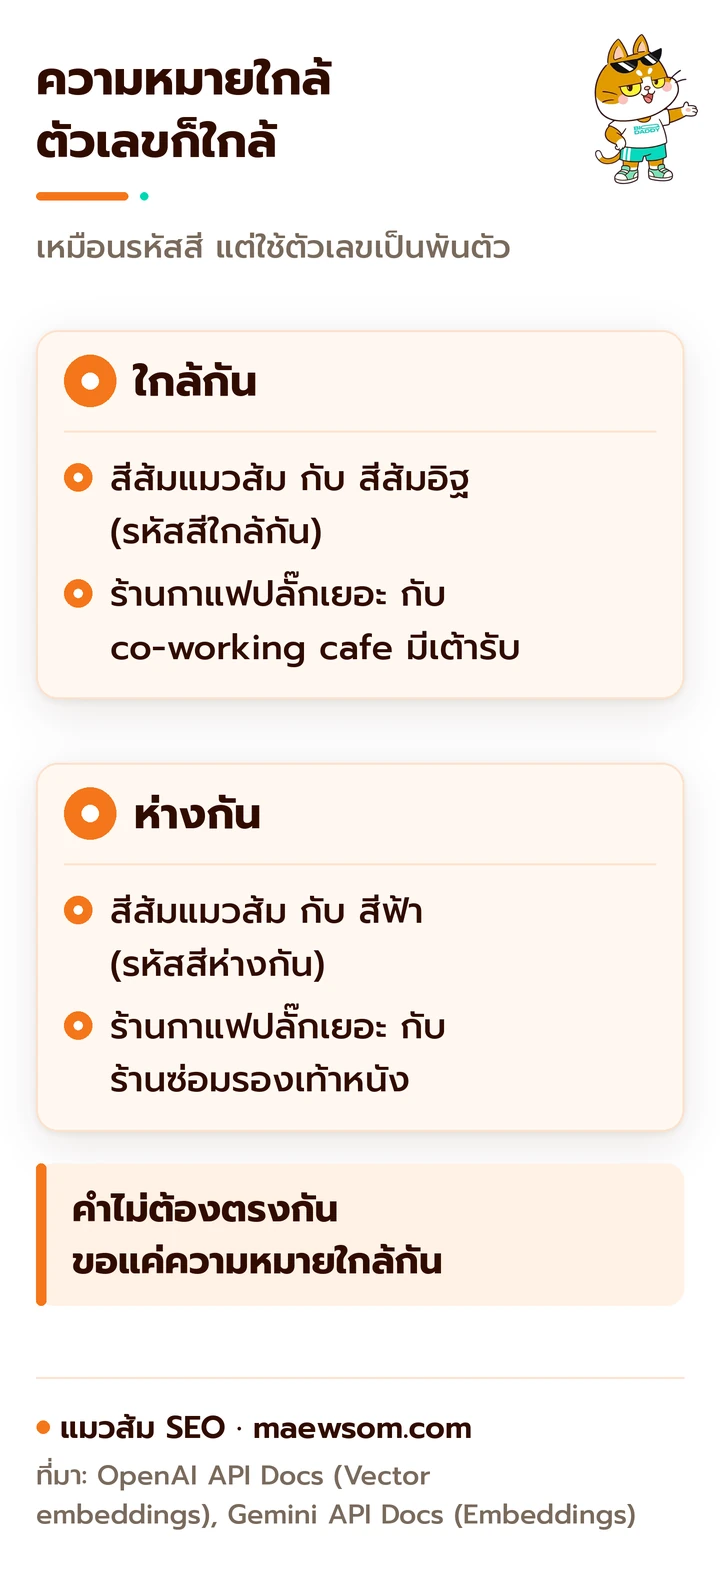
ทีนี้ลองดูสีฟ้า R 0 G 120 B 255 ตัวเลขห่างไปเยอะ สีก็ต่างกันเยอะ
embedding ก็ทำแบบเดียวกันเป๊ะ แต่ทำกับความหมาย ต่างกันแค่ใช้ตัวเลขเป็นพันตัวแทนสามตัว เพราะภาษาซับซ้อนกว่าสีมาก พอนึกภาพนี้ออก เรื่องที่ฟังดูยากก็เหลือแค่ “ตัวเลขใกล้ ความหมายใกล้” เท่านั้นเอง
แมวส้มชอบภาพรหัสสีนี้ เพราะมันบอกจุดที่น่าทึ่งที่สุดในบรรทัดเดียว คือคำไม่ต้องตรงกัน ขอแค่ความหมายใกล้กัน แล้วถามว่า.. ตัวเลขเป็นพันตัวนี่ยาวแค่ไหนกันแน่
Embedding ยาวแค่ไหน และใช้ทำอะไรได้
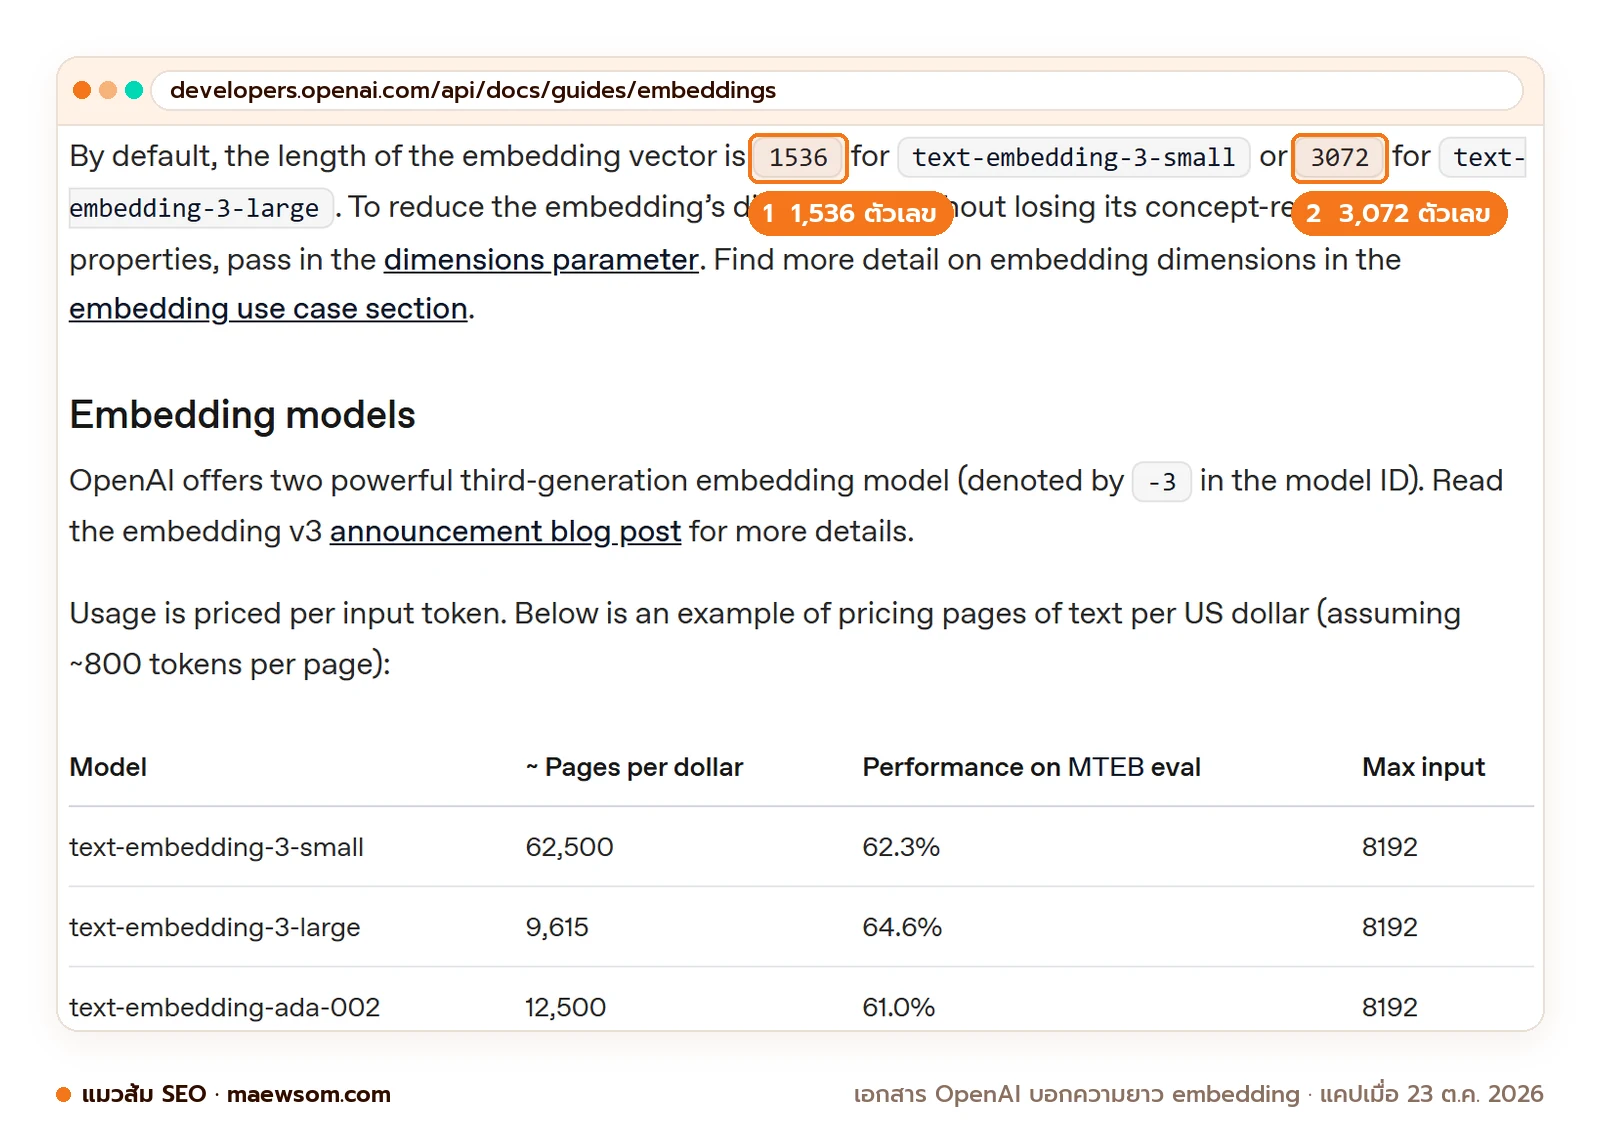
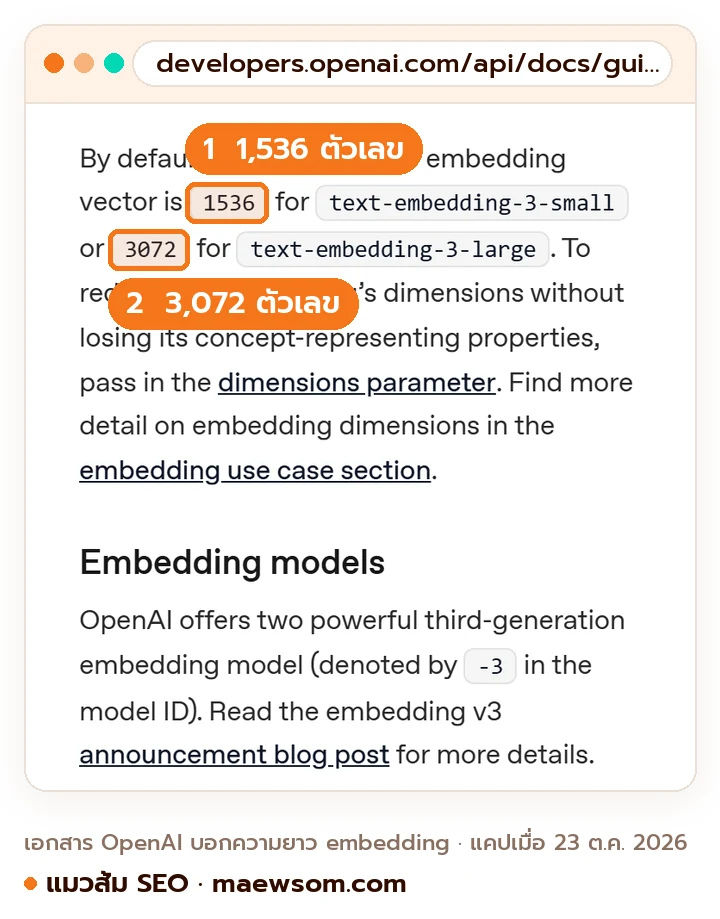
embedding หนึ่งชิ้นตอนนี้นิยมยาวราว 768 ถึง 3,072 ตัวเลข ตัวอย่างจากเอกสารทางการที่เช็กล่าสุดเมื่อ 31 ต.ค. 2026 มีสองเจ้า
- OpenAI โมเดล text-embedding-3-small ให้ 1,536 ตัวเลข ส่วน text-embedding-3-large ให้ 3,072 ตัวเลข ใช้ทำการค้นหา จัดกลุ่ม แนะนำสินค้า หาข้อมูลที่ผิดแปลกจากพวก และจัดหมวดหมู่
- Google โมเดล gemini-embedding-2 รับได้ทั้งข้อความ รูป วิดีโอ เสียง และ PDF แล้ววางทุกอย่างไว้ใน “แผนที่ความหมาย” เดียวกัน รองรับมากกว่า 100 ภาษา ค่าเริ่มต้น 3,072 ตัวเลข ปรับได้ตั้งแต่ 128 ถึง 3,072 (เอกสาร Gemini API อัปเดต 29 ต.ค. 2026)
สิ่งที่แมวส้มชอบคือ gemini-embedding-2 วางรูปกับข้อความไว้ในแผนที่ความหมายเดียวกัน จึงเทียบความหมายกันได้ตรง ๆ แล้วตัวเลขพวกนี้เกี่ยวกับงาน SEO ตรงไหน ไปดูกัน
ทำไม Embedding สำคัญกับ SEO, AEO และ GEO
Embedding สำคัญเพราะเป็นวัตถุดิบของการค้นหาตามความหมาย ทั้ง vector search (การหาข้อความที่ตัวเลขใกล้กับคำถามที่สุด) และขั้น “ค้น” ในระบบ RAG ที่ AI ใช้หาข้อมูลก่อนตอบ จึงโยงตรงกับ SEO (การติดอันดับ Google) AEO (การถูกหยิบไปเป็นคำตอบ) และ GEO (การถูก AI ยกไปอ้าง)
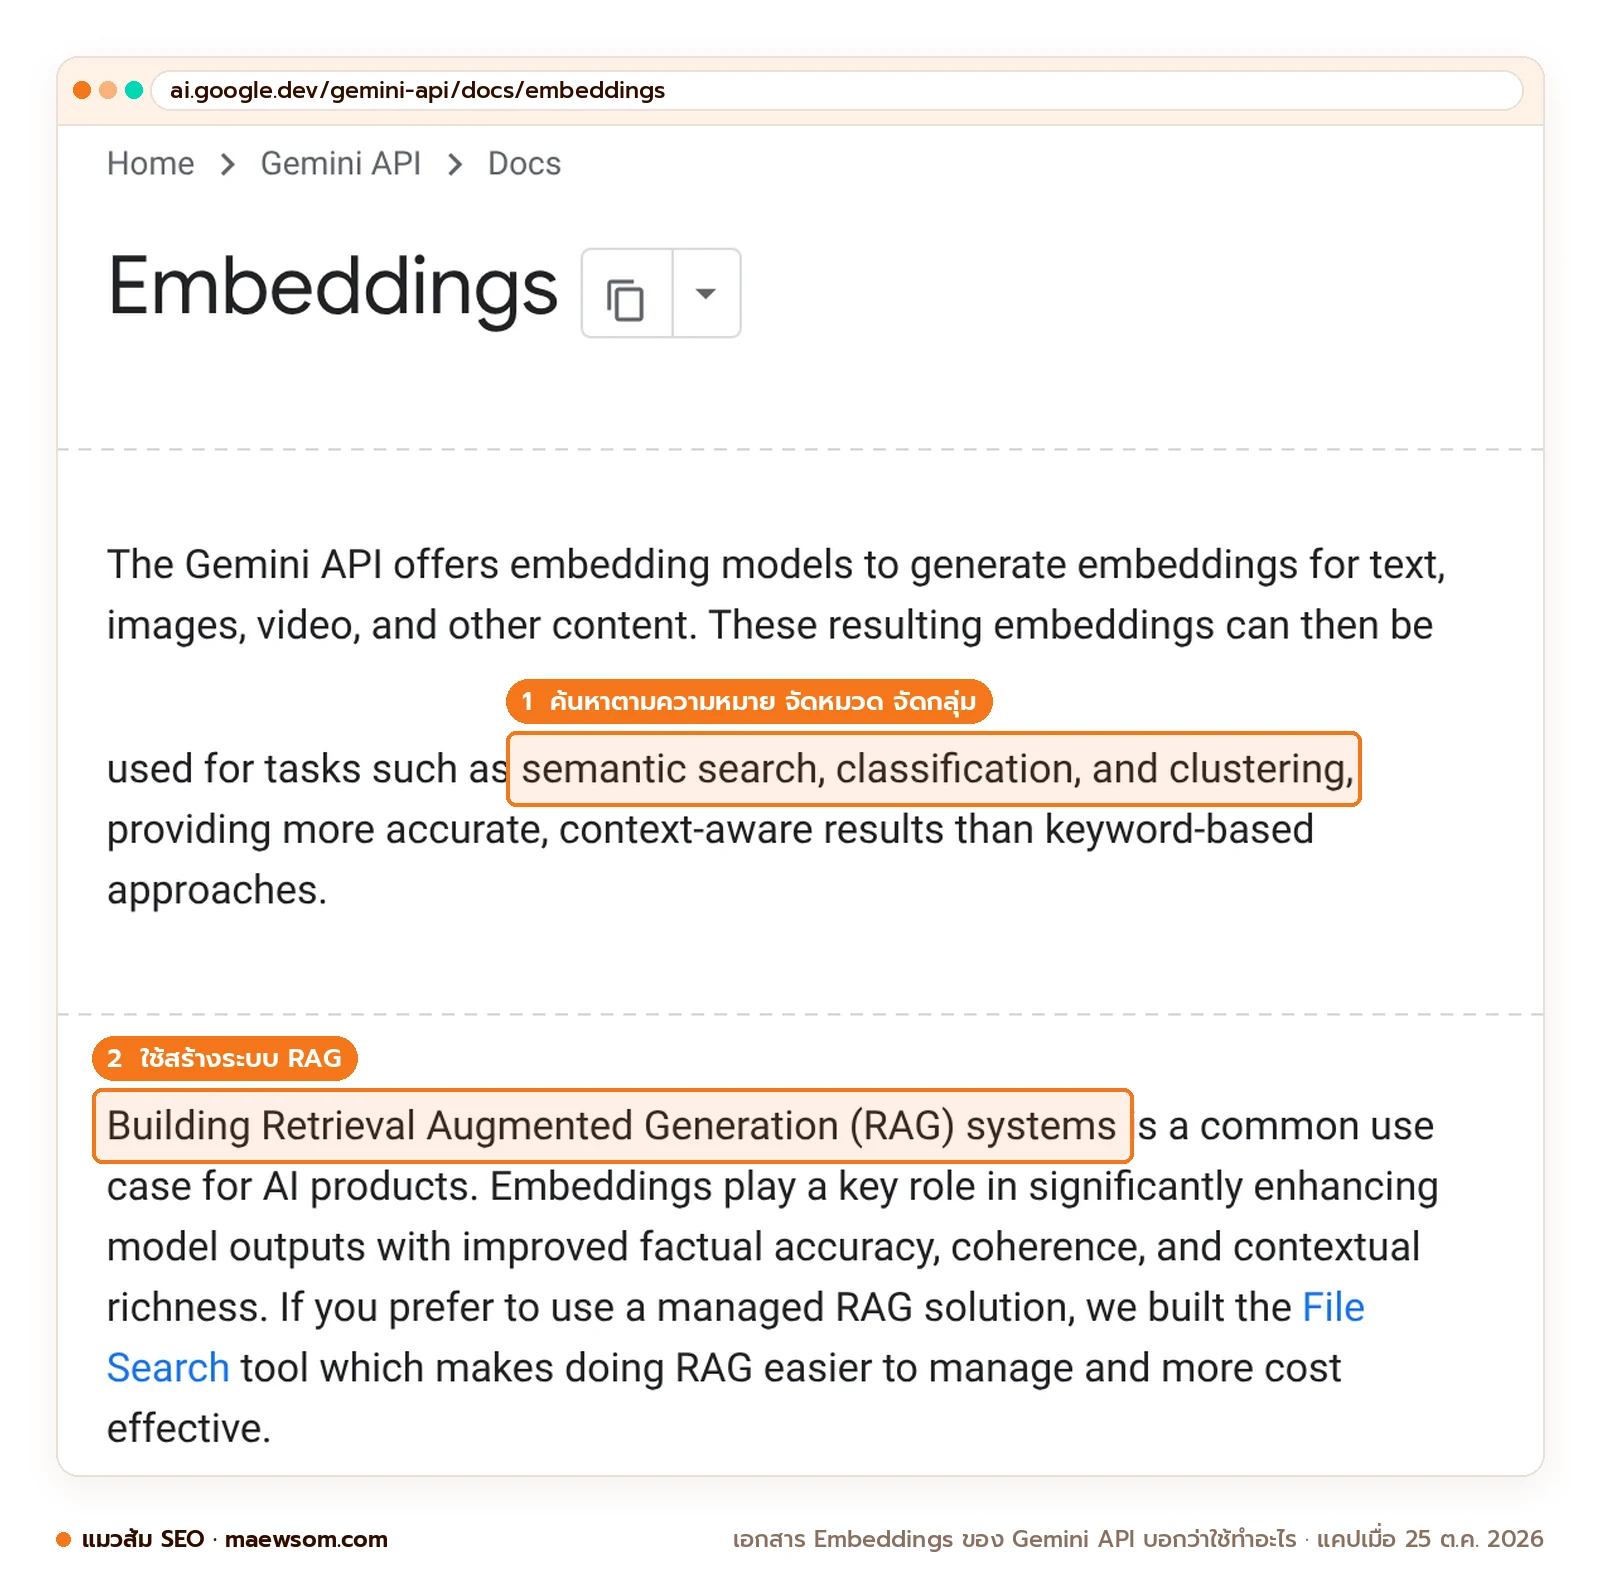
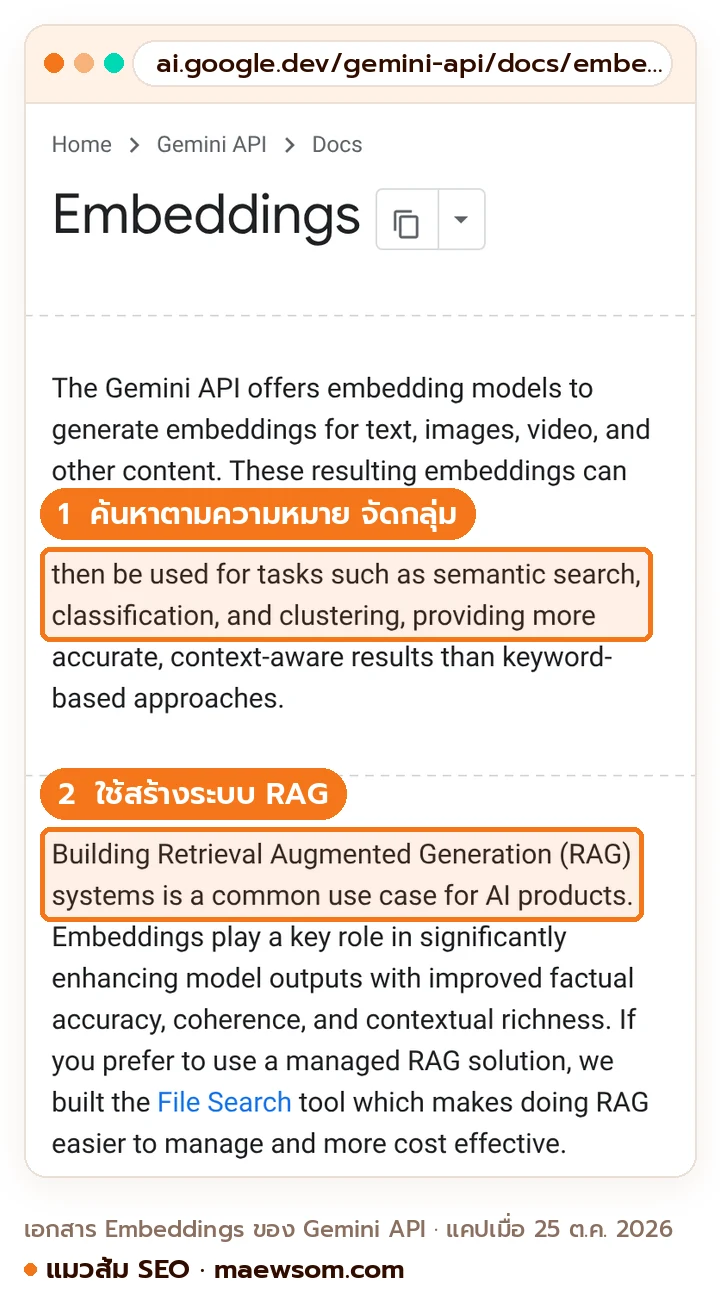
เพราะแบบนี้ ประโยคที่ตอบเรื่องเดียวชัดๆ จะได้ embedding ที่ชี้ไปทางเดียว จับคู่กับคำถามที่ตรงเรื่องได้ง่าย ส่วนย่อหน้าที่ยำหลายเรื่องรวมกัน ตัวเลขมักออกมากลางๆ ไม่ใกล้คำถามไหนเลย
ข่าวดีคือ คนทำเว็บเอา embedding มาใช้เองได้ด้วย เช่น จับคีย์เวิร์ด (คำที่คนพิมพ์ค้น) ที่ความหมายใกล้กันมารวมเป็นหัวข้อ หาหน้าในเว็บที่เขียนซ้อนกันจนแย่งอันดับกันเอง หรือหาหน้าที่ควรลิงก์หากัน เหตุผลง่ายๆ คือหน้าที่ embedding ใกล้กันก็คือหน้าที่พูดเรื่องใกล้กัน
ถ้าให้แมวส้มเลือกงานแรก แมวส้มเลือกหาหน้าที่เขียนซ้อนกันจนแย่งอันดับกันเอง เพราะใช้แค่หน้าในเว็บของคุณเอง อยากเห็นกับตาว่าตัวเลขใกล้กันจริงไหม ลองโค้ดข้างล่างเลย
ลองดู embedding ทำงานด้วยโค้ด 10 บรรทัด
ไม่ต้องกลัวโค้ดนะ ถ้ามี API key ของ OpenAI อยู่แล้ว (รหัสลับที่ให้โปรแกรมเราเรียกใช้ AI ของเขาได้) ลองรันโค้ดภาษา Python ข้างล่าง มันจะเทียบว่าประโยคแรกใกล้กับประโยคไหนมากกว่า ตัวเลขที่ได้ยิ่งใกล้ 1 ความหมายยิ่งใกล้กัน
from openai import OpenAI
import numpy as np

client = OpenAI()
texts = ["ร้านกาแฟนั่งทำงานได้ทั้งวัน ปลั๊กเยอะ",
         "co-working cafe มีเต้ารับทุกโต๊ะ",
         "ร้านซ่อมรองเท้าหนัง"]
r = client.embeddings.create(model="text-embedding-3-small", input=texts)
v = [np.array(d.embedding) for d in r.data]
cos = lambda a, b: a @ b / (np.linalg.norm(a) * np.linalg.norm(b))
print(cos(v[0], v[1]), cos(v[0], v[2]))
ถ้ารันผ่าน ควรเห็นว่าตัวเลขแรกสูงกว่าตัวที่สอง ตรงนี้แหละที่น่าทึ่ง เพราะร้านกาแฟปลั๊กเยอะกับ co-working cafe ความหมายใกล้กัน ทั้งที่แทบไม่มีคำซ้ำกันเลย ส่วนร้านซ่อมรองเท้าอยู่คนละเรื่อง
สิ่งที่แมวส้มเอาไปใช้จริงจากการทดลองนี้คือ ในระบบที่ค้นด้วย embedding ไม่ต้องใช้คำเดียวกับที่คนพิมพ์เป๊ะ ๆ สิ่งที่คุมได้คือเขียนให้ชัดว่าพูดเรื่องอะไร
แต่ embedding ยังมีญาติชื่อคล้ายกันอีกสองคำ ไปแยกให้ขาดกัน
Embedding ต่างจาก Token และ Vector Search ยังไง
Token คือชิ้นข้อความ embedding คือตัวเลขแทนความหมาย ส่วน vector search คือวิธีหาตัวเลขที่ใกล้กันที่สุด ตารางนี้สรุปให้
| คำ | คืออะไร | เปรียบเหมือน |
|---|---|---|
| Token | ชิ้นข้อความเล็กๆ ที่ AI หั่นออกมาก่อนอ่าน เช่น คำหรือเศษคำ | ตัวต่อเลโก้ |
| Embedding | ชุดตัวเลขแทนความหมายของข้อความทั้งชิ้น | พิกัดบนแผนที่ความหมาย |
| Vector search | วิธีหา embedding ที่อยู่ใกล้กันที่สุด | การหาร้านที่ใกล้พิกัดคุณที่สุด |
แมวส้มมองว่าช่องเปรียบเหมือนช่วยจำได้ดีที่สุด เลโก้คือชิ้นส่วน พิกัดคือที่อยู่ของความหมาย ยังสงสัยตรงไหน ไปดูคำถามที่พบบ่อยกัน
คำถามที่พบบ่อย
คำที่เกี่ยวข้อง
ถ้าให้แมวส้มเลือกอ่านต่อคำเดียว แมวส้มเลือก Vector Search เพราะเป็นขั้นที่เอา embedding ไปหาข้อความที่ใกล้คำถามที่สุด
- Vector Search การค้นด้วยตัวเลขแทนความหมาย
- Semantic Search การค้นหาตามความหมาย
- Token ชิ้นข้อความที่ AI อ่าน
- Chunking การแบ่งเอกสารก่อนทำ embedding
- RAG ระบบที่ใช้ embedding ค้นข้อมูลก่อนตอบ
- อ่านต่อแบบเต็ม AI Search ทำงานยังไง LLM, RAG และ Query Fan-out
แหล่งอ้างอิง
- Vector embeddings (OpenAI API Docs, ตรวจ 31 ต.ค. 2026)
- Embeddings (Gemini API Docs, อัปเดต 29 ต.ค. 2026)
เขียนโดย
แมวส้มคือมาสคอตของทีม BIQDADDY เอเจนซี SEO และ AISO ในไทย เล่าเรื่อง AI SEO, GEO และ AEO แบบเข้าใจง่าย บทความเขียนด้วยระบบ AI ตามมาตรฐานของทีม ตรวจข้อเท็จจริงกับแหล่งต้นทาง และผ่านผู้ตรวจ AI อิสระก่อนเผยแพร่ ทีม BIQDADDY เป็นผู้ดูแลเว็บและแก้ไขเมื่อมีผู้แจ้งข้อผิดพลาด อ่านนโยบายการเขียน
เรียบเรียงเนื้อหาโดย วุฒิภัทร อุณหะกะ Co-Founder และ COO ของ BIQDADDY
อ่านต่อกับแมวส้ม
ChatGPT แปลภาษา และ AI ตัวอื่น แปลบทความเว็บยังไงไม่ให้เสีย SEO พร้อมเช็กลิสต์ hreflang และ 5 prompt
ChatGPT API (OpenAI API) คืออะไร ขอ API key ราคาแต่ละโมเดล และสคริปต์ทำ SEO
Gemini สร้างรูปยังไง วิธีใช้และแต่งรูปทีละขั้น ฟรีได้แค่ไหน ลายน้ำ SynthID และสิทธิ์ภาพ