สารบัญ
AI Crawlability คืออะไร ทำให้บอท AI อ่านเว็บได้ครบ ไม่ใช่แค่ตั้ง robots.txt
สวัสดีครับ วันนี้แมวส้มชวนคุณลองสวมแว่นของบอท AI ดูสักวัน แล้วคุณจะตกใจว่าเว็บสวยๆ ของเรา ในสายตาบอทอาจเป็นแค่หน้ากระดาษเปล่า AI crawlability คือความสามารถของเว็บที่ทำให้บอท AI อย่าง OAI-SearchBot, ClaudeBot และ PerplexityBot เข้าถึงหน้าเว็บ ได้ status 200 ทันเวลา และอ่านเนื้อหาหลักได้จาก HTML ที่เซิร์ฟเวอร์ส่งมาตรงๆ เปิด robots.txt อย่างเดียวไม่พอ เพราะบอท AI ส่วนใหญ่ไม่รัน JavaScript และ firewall อาจบล็อกบอทไปเงียบๆ
- บอทของ OpenAI, Anthropic และ Perplexity ไม่รัน JavaScript ตามการวัดของ Vercel กับ MERJ (ธ.ค. 2024) และการทดสอบที่ Advanced Web Ranking สรุปไว้ (ส.ค. 2026) เนื้อหาสำคัญจึงต้องอยู่ใน HTML แรก
- เว็บ React หรือ Vue ที่เรนเดอร์ฝั่งเบราว์เซอร์ล้วน ควรเปลี่ยนเป็น SSR หรือ static rendering ซึ่ง Google เองก็แนะนำแทน dynamic rendering
- robots.txt อนุญาตแล้ว แต่ WAF หรือ Bot Fight Mode ของ Cloudflare ยังตอบ 403 หรือหน้า challenge ได้ ต้องเช็กที่ AI Crawl Control และ Security Events
- บอท AI เจอ 404 สูงกว่า Googlebot ราว 4 เท่าในข้อมูลของ Vercel ดูแล redirect 301 ให้ครบ ใส่ lastmod ใน sitemap และใช้ IndexNow ให้ Bing รู้ทันที
AI crawlability คืออะไร ต่างจากการตั้ง robots.txt ยังไง
AI crawlability คือการที่บอท AI เดินจากจุดค้นพบ URL ไปจนถึงอ่านเนื้อหาได้สำเร็จ โดยไม่ติดด่านไหนเลย ส่วน robots.txt เป็นแค่ด่านเดียวในหลายด่าน เปรียบง่ายๆ robots.txt คือป้ายหน้าบ้านที่เขียนว่า “เชิญเข้ามาได้” แต่ถ้าประตูรั้วล็อก (firewall) หรือในบ้านมืดสนิท (เนื้อหาโหลดด้วย JavaScript) แขกก็ยังไม่เห็นอะไรอยู่ดี
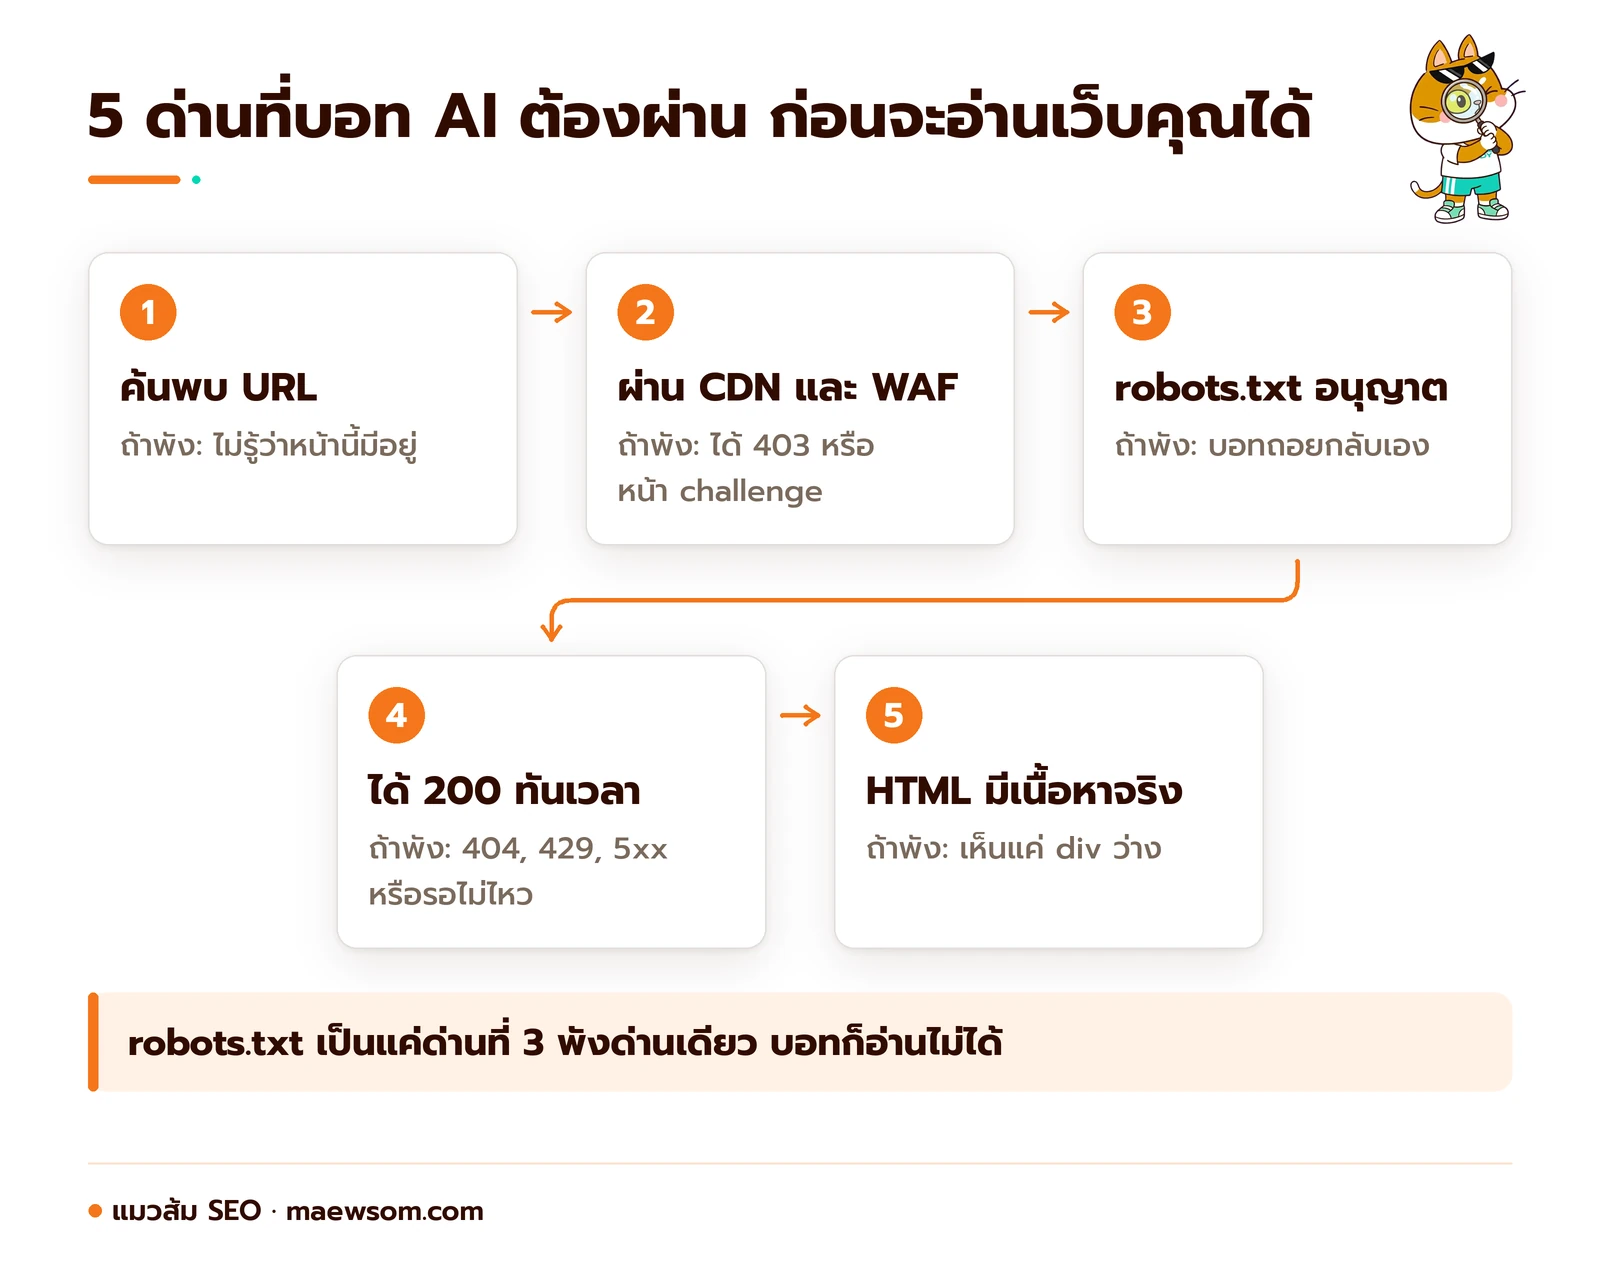
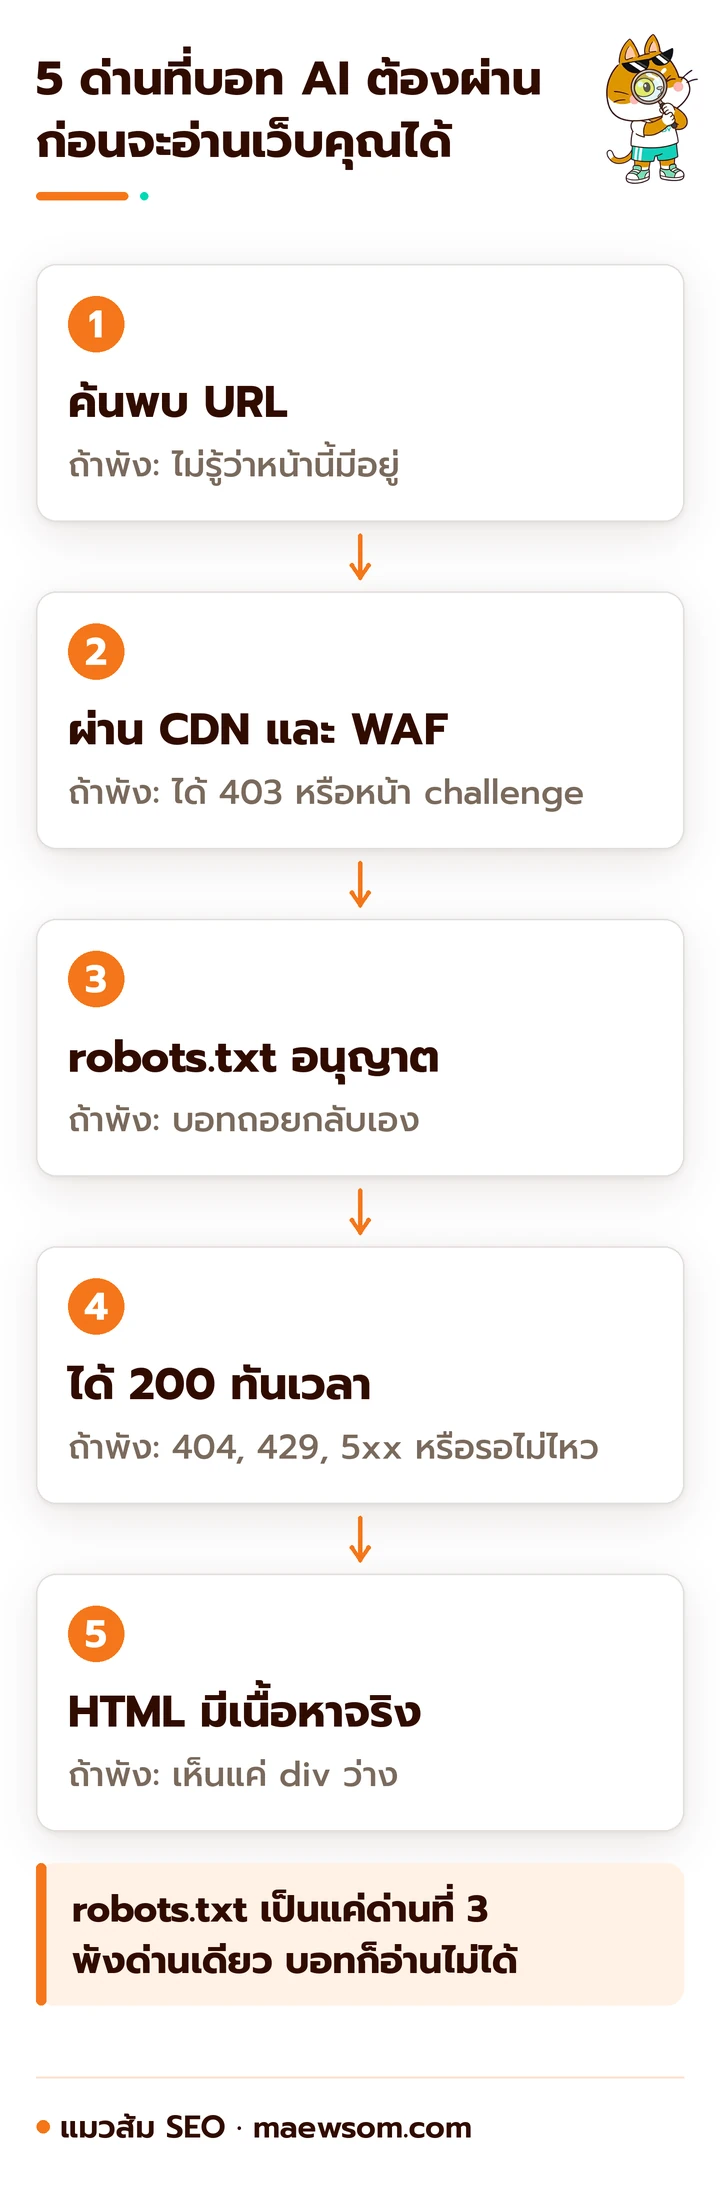
ใครตั้ง robots.txt ถูกเป๊ะแล้วยังงงว่าทำไม ChatGPT ไม่เคยยกเว็บเราไปตอบ ไม่แปลกเลยครับ ปัญหามักซ่อนอยู่ในด่านอื่น ซึ่งมี 5 ด่านเรียงตามที่บอทต้องผ่านจริง
- ค้นพบ URL บอทต้องรู้ก่อนว่าหน้านี้มีอยู่ ผ่าน sitemap, ลิงก์ภายใน หรือ IndexNow
- ผ่าน CDN และ WAF WAF (Web Application Firewall) คือ รปภ. หน้าเว็บที่คัดกรองคนเข้า ถ้ามองบอทว่าน่าสงสัย จะได้ 403 หรือหน้า challenge แทนเนื้อหา
- ได้รับอนุญาตใน robots.txt รายละเอียดเรื่องนี้แมวส้มแยกไว้ใน AI crawler คืออะไร ควรบล็อก GPTBot ไหม
- เซิร์ฟเวอร์ตอบ status ถูกและทันเวลา ต้องได้ 200 ไม่ใช่ 404, 429 หรือ 5xx และไม่ช้าจนบอทเลิกรอ
- HTML มีเนื้อหาจริง บอทที่ไม่รัน JavaScript จะเห็นเฉพาะสิ่งที่อยู่ใน HTML ตัวแรก ถ้าในนั้นมีแค่
<div id="root"></div>บอทก็อ่านได้ศูนย์คำ
ด่านไหนพังด่านเดียว ด่านที่เหลือดีแค่ไหนก็ไม่ช่วย เหมือนสอบผ่านทุกวิชาแต่ลืมเขียนชื่อในกระดาษคำตอบ ภาพรวมว่า crawlability อยู่ตรงไหนของงาน AI SEO ทั้งหมด ดูได้ที่ คู่มือ AI SEO
บอท AI ตัวไหนรัน JavaScript ได้บ้าง
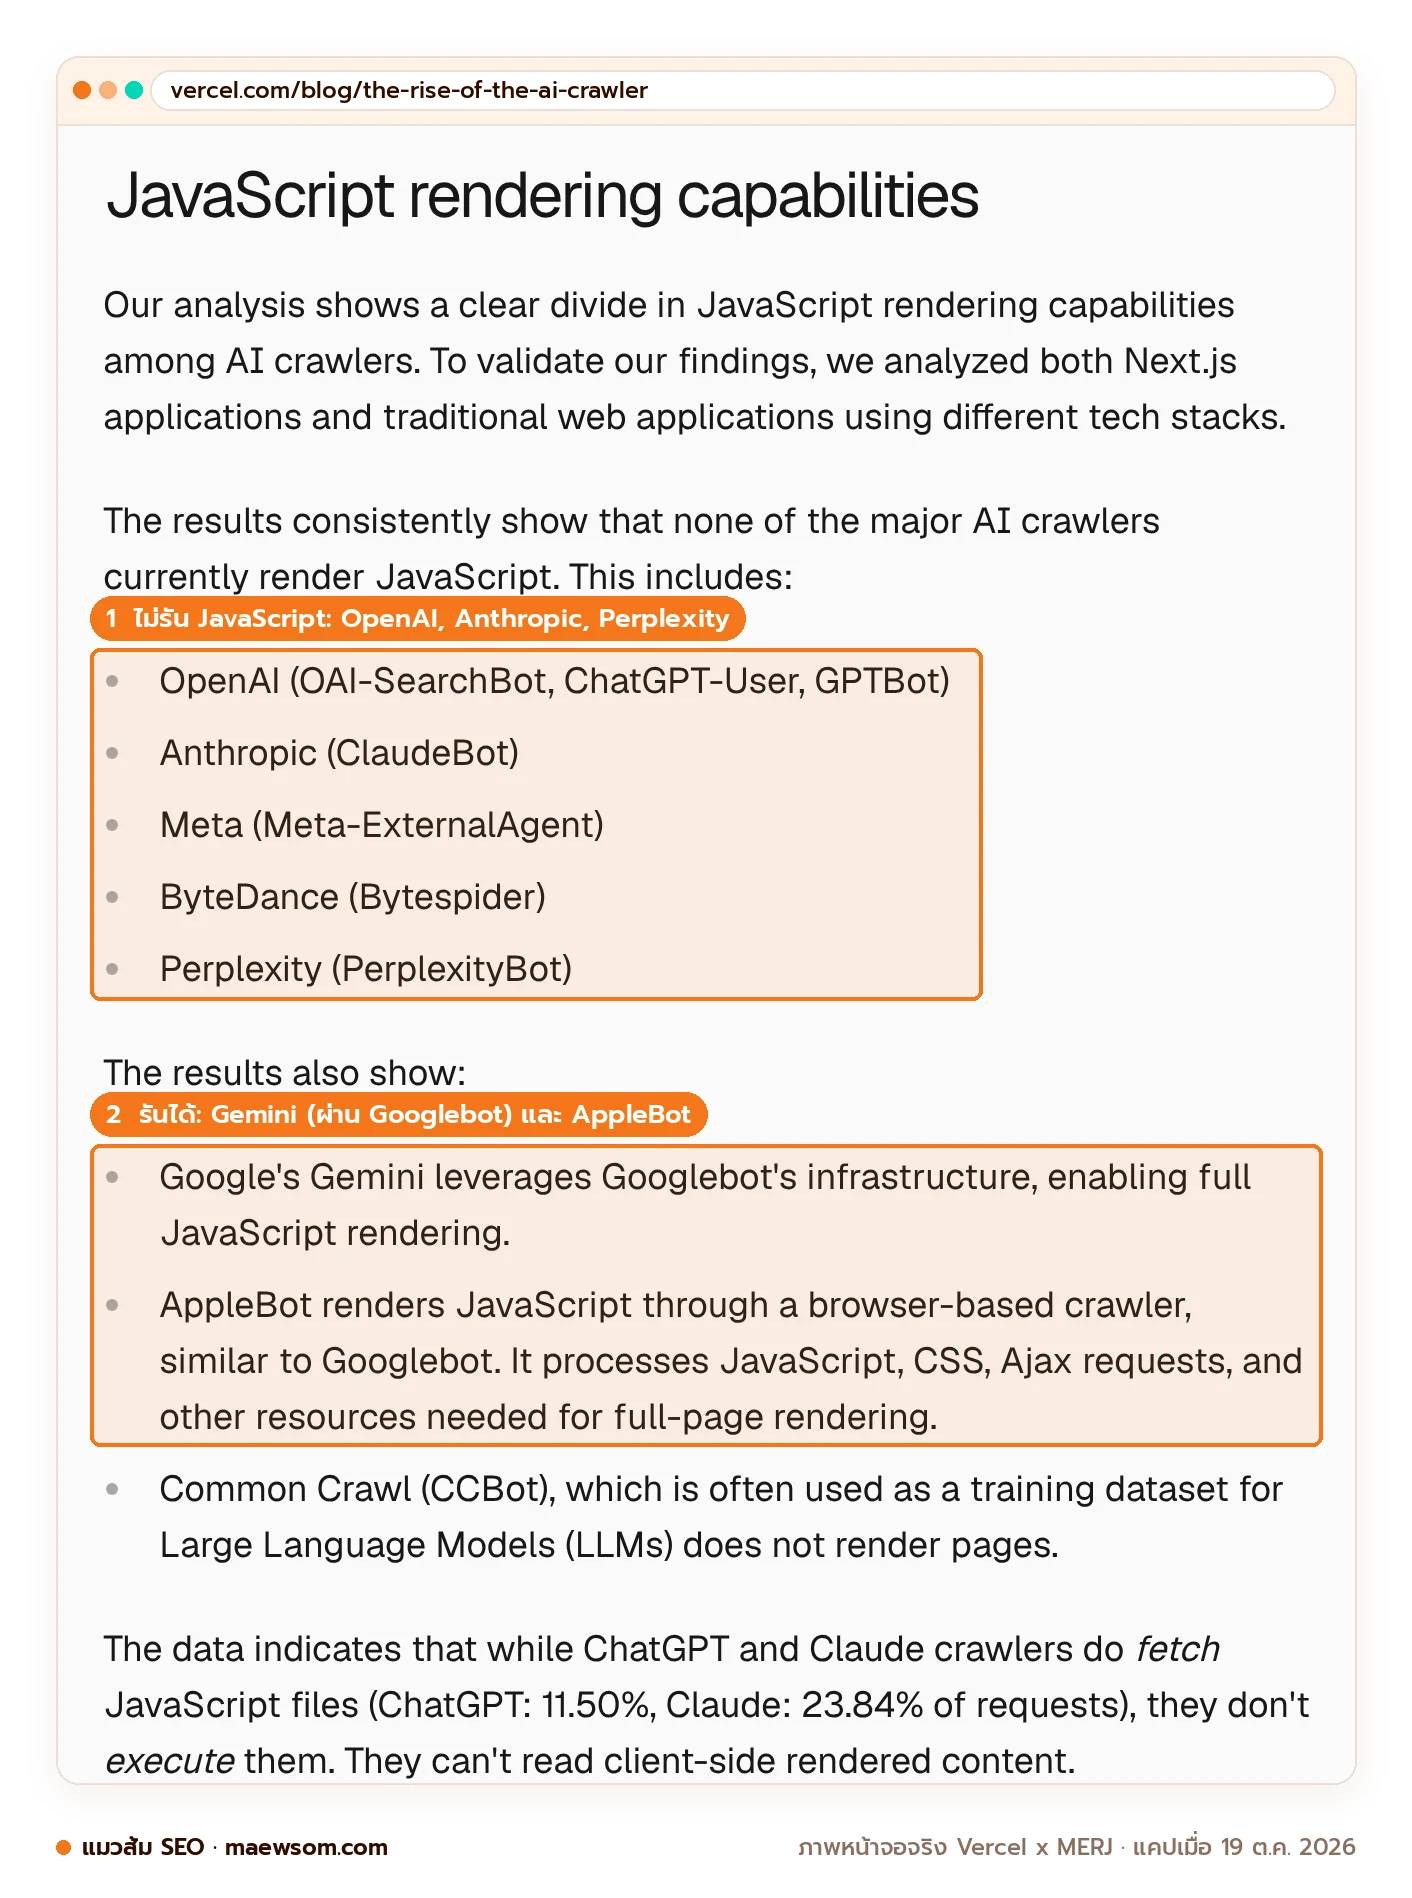
คำตอบสั้นที่สุดคือ ณ ตุลาคม 2026 หลักฐานที่มีชี้ว่าบอทของ OpenAI, Anthropic, Perplexity, Meta, ByteDance และ Common Crawl ไม่รัน JavaScript ส่วนฝั่ง Google (Googlebot ที่ป้อน AI Overviews และ AI Mode) กับ Applebot รันได้ บริษัท AI ส่วนใหญ่ไม่ได้เขียนเรื่องนี้ไว้ในเอกสารทางการ ข้อมูลทั้งหมดจึงมาจากการวัดและทดสอบของคนนอก
JavaScript rendering คือการที่บอทเปิดหน้าแบบเบราว์เซอร์จริง รันสคริปต์ แล้วค่อยอ่านผลลัพธ์ เปรียบเหมือนสั่งชุดประกอบเฟอร์นิเจอร์ บอทที่ไม่รัน JavaScript จะเห็นแค่กล่องกับคู่มือ ไม่เคยเห็นโต๊ะที่ประกอบเสร็จ
| บอท / แพลตฟอร์ม | รัน JavaScript ไหม | หลักฐาน |
|---|---|---|
| Googlebot (Search, AI Overviews, AI Mode) | รันได้ | Google ระบุในคู่มือ AI ว่าประมวลผล JavaScript ได้ถ้าไม่ถูกบล็อก |
| Gemini | รันได้ในระบบ index แต่ตอนดึงสดยังไม่แน่ | Vercel/MERJ (ธ.ค. 2024) ระบุว่าใช้ระบบของ Googlebot แต่การทดสอบของ Andre Alpar (AWR, ส.ค. 2026) ตอบจาก HTML ดิบเมื่อเจอ URL ใหม่ ขณะที่ searchVIU (ต.ค. 2025) พบว่า Gemini อ่านราคาที่ JavaScript ใส่ได้ตอนดึงสด ผลยังขัดกันอยู่ |
| GPTBot, OAI-SearchBot, ChatGPT-User | ไม่รัน | Vercel/MERJ (ธ.ค. 2024), Glenn Gabe (ส.ค. 2025), การทดสอบ decoy ของ Alpar |
| ClaudeBot | ไม่รัน | Vercel/MERJ พบว่าดึงไฟล์ JS ถึง 23.84% ของ request แต่ไม่รัน |
| PerplexityBot | ไม่รัน | Vercel/MERJ และ Glenn Gabe |
| Applebot | รันได้ | Vercel/MERJ ระบุว่าเป็น crawler แบบเบราว์เซอร์ |
| Copilot (Microsoft) | ยังไม่ชัด | Vercel ไม่ได้วัดเพราะไม่มี user agent แยก การทดสอบของ Alpar พบว่า Copilot ดึงสคริปต์แต่ไม่รัน |
ตัวเลขที่ทำให้แมวส้มตาโตคือ ในเดือนที่ Vercel วัด GPTBot ส่ง request 569 ล้านครั้ง และ Claude 370 ล้านครั้ง แต่ไม่รันโค้ดที่โหลดไปเลยสักครั้ง ข้อจำกัดคือข้อมูลนี้เก็บปลายปี 2024 จากเครือข่ายเดียว จึงอาจไม่ตรงกับวันนี้ทั้งหมด
การทดสอบของ Andre Alpar ที่ Advanced Web Ranking สรุปไว้ (ส.ค. 2026 บทความไม่ได้บอกวันที่ทดสอบ) ออกแบบน่ารักมาก เขาใส่ตัวเลขหลอกไว้ใน HTML ดิบ แล้วให้ JavaScript โหลดตัวเลขจริงมาแทน จากผู้ช่วย AI 12 ตัว ฝั่งอเมริกาทั้ง 7 ตัว (ChatGPT, Claude, Gemini, Perplexity, Meta AI, Copilot, Grok) ตอบตัวเลขหลอก แปลว่าอ่านแค่ HTML ดิบ ส่วน DeepSeek, ERNIE, Qwen, Kimi และ Mistral ตอบตัวเลขจริง แปลว่ารัน JavaScript ได้ เป็นการทดสอบรอบเดียว จึงใช้เป็นสัญญาณ ไม่ใช่คำตัดสินถาวร
SSR, SSG หรือ CSR แบบไหนที่บอท AI อ่านเนื้อหาได้ครบ
ถ้าอยากให้บอท AI อ่านได้ครบ ให้ใช้ SSR (server-side rendering) หรือ SSG (static site generation) กับหน้าที่มีเนื้อหาสำคัญ และเลี่ยง CSR (client-side rendering) ล้วน เพราะ CSR ส่ง HTML เปล่าแล้วให้เบราว์เซอร์ประกอบเนื้อหาเอง ซึ่งบอทที่ไม่รัน JavaScript ทำไม่ได้
เปรียบกับร้านข้าวมันไก่ SSR คือทำจานใหม่ทุกครั้งที่ลูกค้าสั่ง SSG คือจัดจานรอไว้ล่วงหน้า ส่วน CSR คือยื่นไก่ ข้าว น้ำจิ้ม แยกถุงแล้วบอกว่า “ไปประกอบเองนะ” คนทำได้ แต่บอทไม่ทำ
| วิธีเรนเดอร์ | บอทที่ไม่รัน JS เห็นอะไร | เหมาะกับ | ตัวอย่างเครื่องมือ |
|---|---|---|---|
| SSR | เนื้อหาครบใน HTML แรก | หน้าที่ข้อมูลเปลี่ยนบ่อย เช่น ราคา สต็อก | Next.js, Nuxt, WordPress (PHP เรนเดอร์ฝั่งเซิร์ฟเวอร์อยู่แล้ว) |
| SSG / static rendering | เนื้อหาครบ และมักโหลดเร็วที่สุด | บทความ คู่มือ หน้าบริการ | Astro, Hugo, Next.js แบบ static export |
| CSR ล้วน | มักเห็นแค่ div ว่างกับไฟล์สคริปต์ | หน้าหลังล็อกอิน แดชบอร์ด ที่ไม่ต้องการให้ค้นเจอ | React หรือ Vue แบบ SPA ที่ไม่มี SSR |
| Dynamic rendering | เห็นเนื้อหา ถ้าระบบส่งเวอร์ชันเรนเดอร์ให้บอทถูกตัว | ทางแก้ชั่วคราวของเว็บเก่า | บริการ prerender ภายนอก |
ส่วน dynamic rendering นั้น Google เขียนเองว่าเป็น “a workaround and not a recommended solution” ใช้แค่ระหว่างรอย้ายระบบพอ
ก่อนแก้และหลังแก้ ใน HTML ดิบหน้าตาเป็นแบบนี้
ก่อนแก้ (CSR ล้วน) บอทเห็นแค่นี้
หลังแก้ (SSR) บอทเห็นเนื้อหาจริง ลิงก์จริง ตั้งแต่ request แรก
อะไรบ้างที่ต้องอยู่ใน HTML แรก
หลักง่ายๆ คืออะไรที่อยากให้ AI ยกไปตอบ ต้องอยู่ใน HTML แรก ทั้งเนื้อหาหลัก หัวข้อ title, meta description, canonical, ลิงก์ภายในแบบ <a href> ราคา และคำตอบ FAQ ปุ่มที่เปลี่ยนหน้าด้วย onclick โดยไม่มี href บอทตามไปไม่ได้ เพราะมันไม่กดปุ่มให้คุณ
อีกจุดที่หลายคนไม่รู้ การทดสอบของ searchVIU (ต.ค. 2025) ที่ AWR อ้างถึง พบว่าราคาที่อยู่ใน JSON-LD อย่างเดียว ไม่มีระบบ AI ตัวไหนในห้าตัวหาเจอตอนดึงหน้าสด schema ยังมีประโยชน์ตามที่อธิบายใน Schema สำหรับ AI Search แต่ราคาหรือเวลาเปิดปิดควรเขียนเป็นข้อความที่คนเห็นด้วย
Cloudflare และ WAF บล็อกบอท AI โดยไม่รู้ตัว เช็กยังไง
firewall บล็อกบอท AI ได้แม้ robots.txt จะอนุญาต เพราะ firewall ตัดสินก่อนบอทจะได้อ่าน robots.txt ด้วยซ้ำ วิธีเช็กคือดูสถิติ status code ของบอท AI ใน Cloudflare AI Crawl Control และดู Security Events ว่ามี request ของบอทที่ถูก block หรือ challenge หรือไม่
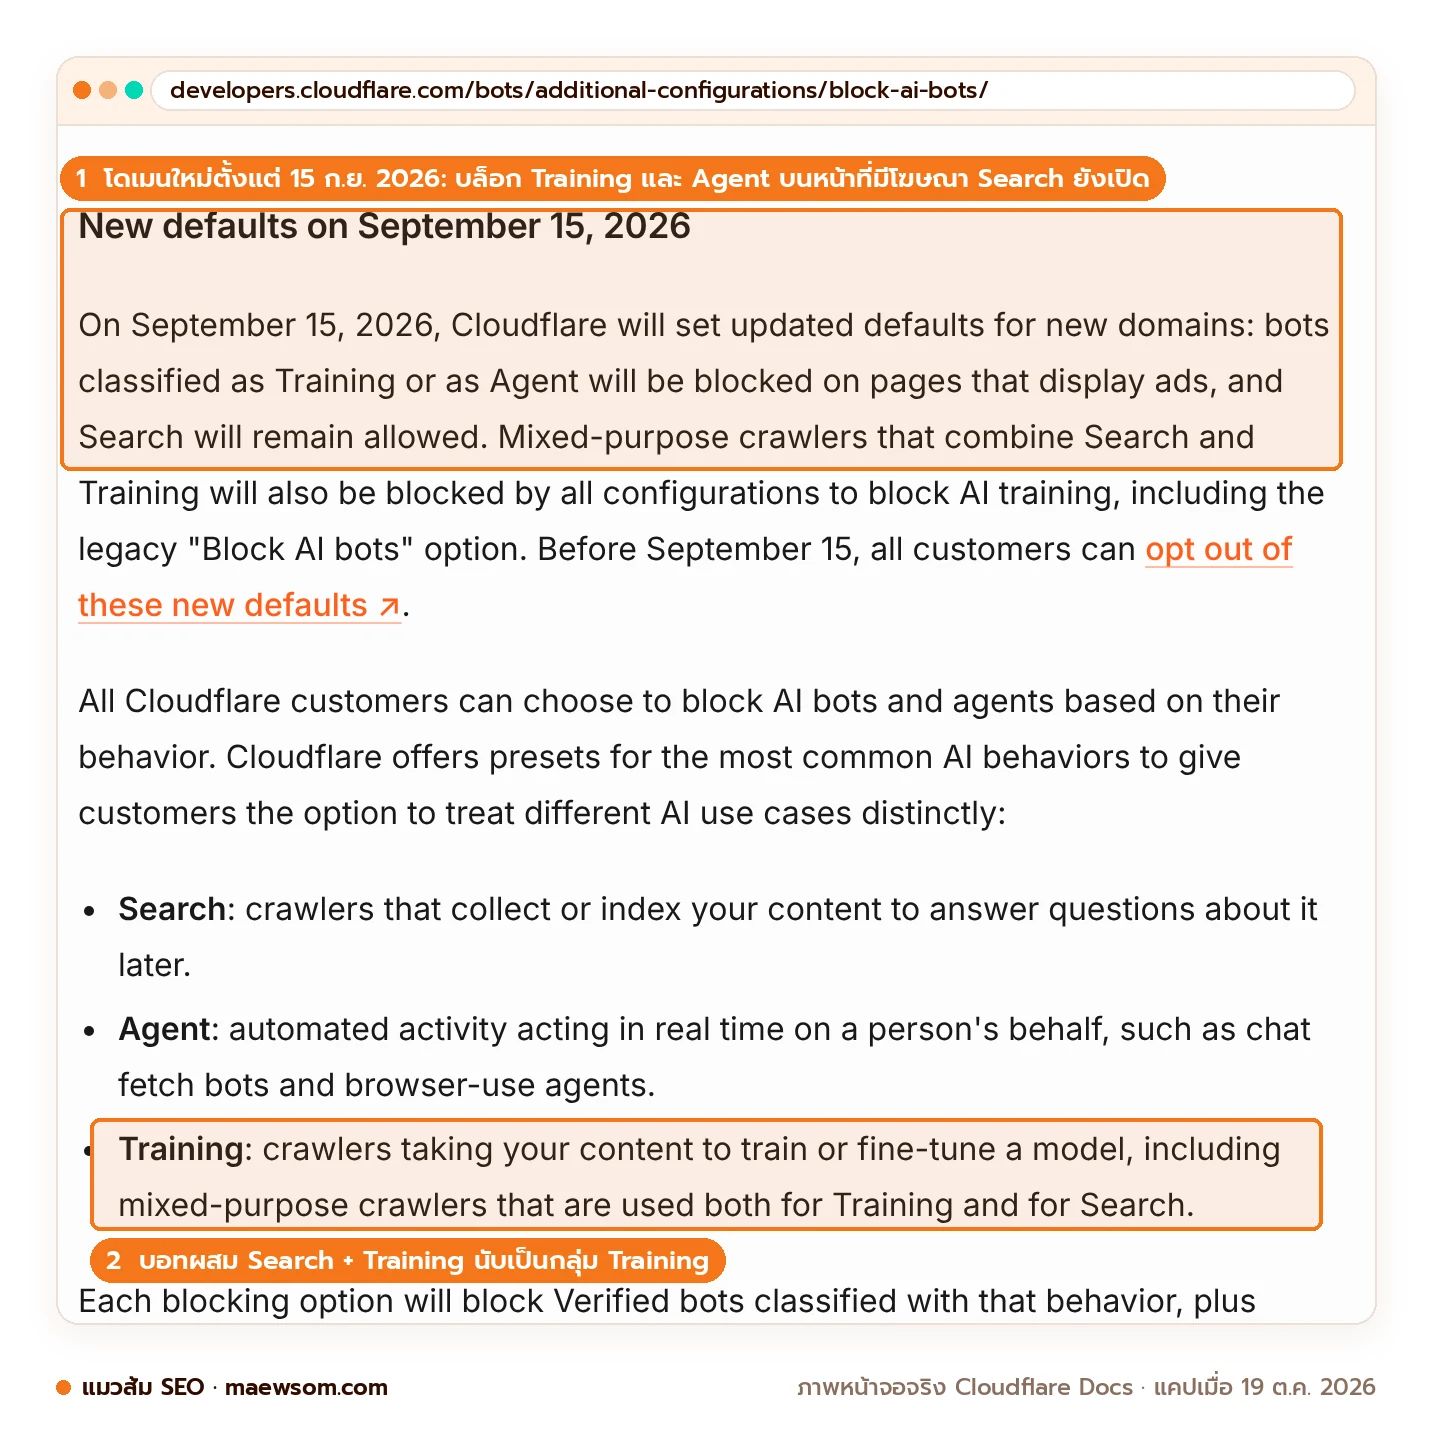
ตรงนี้พลาดแล้วเจ็บนะครับ เพราะมันเงียบมาก ลูกค้าเข้าเว็บได้ปกติ แต่บอทค้นหาของ AI โดนไล่กลับทุกครั้ง บน Cloudflare มี 3 จุดที่ต้องรู้
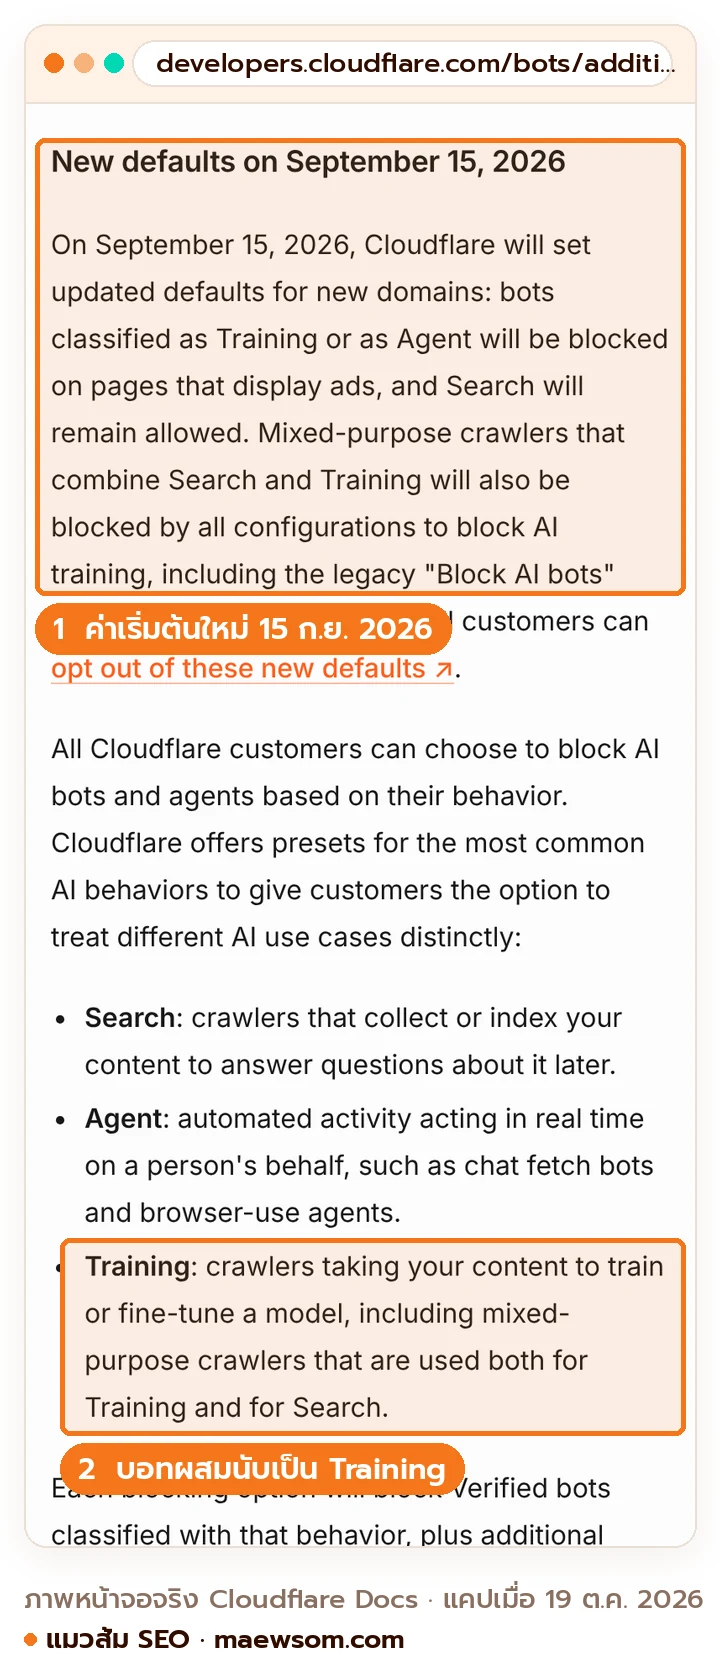
- ค่าเริ่มต้นใหม่ตั้งแต่ 15 ก.ย. 2026 เอกสาร Cloudflare ระบุว่าโดเมนใหม่จะบล็อกบอทกลุ่ม Training และ Agent บนหน้าที่มีโฆษณา ส่วน Search ยังเปิด และบอทที่ทำทั้ง Search และ Training ในตัวเดียวจะโดนบล็อกในทุกการตั้งค่าที่บล็อกการเทรน ถ้าคุณอยากให้บอทผสมแบบนี้เข้า ต้องไปตั้งเอง
- Bot Fight Mode ข้ามด้วย WAF rule ไม่ได้ Cloudflare เขียนชัดว่า “You cannot bypass or skip Bot Fight Mode using WAF custom rules or Page Rules” ถ้าโหมดนี้ไปกันบอทที่คุณอยากให้เข้า ต้องปิดมัน หรือย้ายไปใช้ Super Bot Fight Mode ที่ตั้ง Skip rule ได้
- หน้า challenge ต้องรัน JavaScript Cloudflare อธิบายว่า challenge แบบไม่ต้องโต้ตอบจะฉีด JavaScript ให้เบราว์เซอร์รัน บอทที่ไม่รัน JavaScript จึงผ่านไม่ได้ และได้หน้า “กำลังตรวจสอบ” ไปแทนเนื้อหาของคุณ ดูได้จาก header
cf-mitigated: challengeที่ Cloudflare ระบุว่าใช้บอกว่าคำตอบนี้เป็นหน้า challenge
รู้จุดเสี่ยงแล้ว มาเช็กของจริงกัน ใช้เวลาไม่ถึง 5 นาที ทำตาม 5 ขั้นข้างล่างนี้ได้เลย
- เข้า Cloudflare dashboard เลือกโดเมน แล้วไปที่ AI Crawl Control
- เปิดแท็บ Metrics ดูกราฟ Status code distribution ถ้าบอทค้นหาอย่าง OAI-SearchBot มี 403 หรือ 429 เยอะ แปลว่ามีด่านกันอยู่ (นับเฉพาะ 200-299 เป็น Allowed requests)
- ดู Most popular paths ว่าบอทเข้าหน้าที่คุณอยากให้อ่านจริงไหม หรือวนอยู่กับไฟล์
/static/ - ไปที่ Security Events กรองตาม user agent ของบอท ดูว่ากฎตัวไหนเป็นคนบล็อก
- ถ้าจะสร้างกฎยกเว้น ให้จับทั้ง user agent และ IP ของเจ้าของบอท อย่างที่ Perplexity แนะนำในเอกสารของตัวเอง เพราะ user agent อย่างเดียวปลอมกันง่าย
ไม่ได้ใช้ Cloudflare ก็ยังมีด่านคล้ายกัน เช่น ปลั๊กอินความปลอดภัยของ WordPress หรือ rate limit ของโฮสติ้ง วิธีอ่าน server log อยู่ในบทความ AI crawler
Status code และ 404 ที่ทำให้บอท AI เสียเที่ยว
บอท AI ต้องได้ status 200 พร้อมเนื้อหาจริง ทุกอย่างที่ไม่ใช่ 200 คือเที่ยวเสีย และบอท AI เสียเที่ยวบ่อยกว่า Google มาก ข้อมูลของ Vercel/MERJ พบว่า 34.82% ของการดึงหน้าของ ChatGPT และ 34.16% ของ Claude ไปเจอหน้า 404 เทียบกับ Googlebot ที่ 8.22% และ ChatGPT ยังต้องตาม redirect อีก 14.36%
เปรียบเหมือนไรเดอร์ส่งของที่ใช้แผนที่เก่า ถ้าบ้านเก่ามีป้าย “ย้ายไปบ้านเลขที่ใหม่” (redirect 301) ของยังถึง ถ้าไม่มีป้าย ของก็ตีกลับ ตารางนี้สรุปว่าแต่ละ status แปลว่าอะไรและควรทำอะไร
| Status | บอทเข้าใจว่า | ควรทำอะไร |
|---|---|---|
| 200 | เจอเนื้อหา อ่านได้ | เช็กว่า 200 นั้นมีเนื้อหาจริง ไม่ใช่หน้าว่างหรือหน้า “ไม่พบ” ที่ JS วาดขึ้น (soft 404) |
| 301 / 308 | ย้ายถาวร ให้ไปที่ใหม่ | ชี้ตรงไปปลายทางสุดท้ายในหนึ่ง hop อย่าต่อเป็นทอดๆ |
| 404 / 410 | ไม่มีหน้านี้ | ถ้าหน้ามีคนลิงก์ถึงหรือมีคนเข้า ให้ 301 ไปหน้าที่ใกล้เคียงที่สุด |
| 403 | ไม่อนุญาต | ถ้าไม่ได้ตั้งใจบล็อก ไปไล่หากฎใน WAF หรือปลั๊กอินความปลอดภัย |
| 429 | ส่งถี่ไป เซิร์ฟเวอร์รับไม่ไหว | Google จัด 429 เป็นกลุ่มเดียวกับ server error ปรับ rate limit ให้บอทที่อยากให้เข้า |
| 5xx | เซิร์ฟเวอร์พัง | Google จะลดความถี่การ crawl และถ้าพังต่อเนื่องจะเอา URL ออกจาก index |
soft 404 คือตัวร้ายเงียบของเว็บ SPA เซิร์ฟเวอร์ตอบ 200 ทุก URL แล้วให้ JavaScript ตัดสินทีหลังว่า “ไม่พบหน้านี้” บอทที่ไม่รัน JS จึงเห็นหน้า 200 ว่างๆ เป็นพันหน้า ทางแก้คือให้เซิร์ฟเวอร์ตอบ 404 ของจริง
Sitemap และ IndexNow ช่วยบอท AI เจอหน้าใหม่เร็วขึ้นไหม
ช่วยได้ชัดกับ Bing และ Copilot เพราะ Bing เขียนเองว่า lastmod ใน sitemap เป็น “a key signal” ในการเลือกหน้าไป crawl ซ้ำ และแนะนำ IndexNow สำหรับแจ้ง URL ใหม่ทันที ส่วน OpenAI, Anthropic และ Perplexity ไม่ได้ประกาศว่าใช้ IndexNow อย่าเพิ่งหวังเกินจริง
IndexNow คือการกดกริ่งบอกเครื่องมือค้นหาว่า “หน้านี้เพิ่งเปลี่ยนนะ” แทนการรอบุรุษไปรษณีย์ผ่านมาเอง หน้า FAQ ของ indexnow.org ระบุผู้ร่วมโครงการคือ Amazon, Bing, Naver, Seznam.cz, Yandex และ Yep โดยไม่มี Google ส่งครั้งเดียว ทุกเจ้าที่ร่วมได้ข้อมูลเหมือนกัน
ลองส่ง URL แรกด้วยตัวเองได้เลย ขั้นแรกสร้างไฟล์คีย์ (ยาว 8-128 ตัวอักษร) ไว้ที่ root เช่น https://example.co.th/a1b2c3d4e5f6.txt ข้างในมีแค่ตัวคีย์ จากนั้นเรียก URL นี้
ถ้ามีหลาย URL ส่งแบบ POST เป็น JSON ได้ครั้งละไม่เกิน 10,000 URL ฝั่ง sitemap ให้แน่ใจว่า lastmod เปลี่ยนเฉพาะตอนเนื้อหาเปลี่ยนจริง Bing ระบุว่า changefreq กับ priority ถูกเมิน ไม่ต้องเสียเวลาปรับ
ความเร็วหน้าเว็บและ timeout มีผลกับบอท AI แค่ไหน
ยังไม่มีบริษัท AI รายไหนประกาศตัวเลข timeout ของบอท ที่ยืนยันได้คือ Googlebot อ่านแค่ 2MB แรกของไฟล์ HTML (นับแบบไม่บีบอัด) และคู่มือ AI ของ Google แนะนำให้ลด latency ส่วนบอทที่ผู้ใช้สั่งอย่าง ChatGPT-User ดึงหน้าตอนที่ผู้ใช้นั่งรอคำตอบ หน้าที่ตอบช้าจึงเสี่ยงกว่าแน่ๆ
สิ่งที่ทำได้จริงคือวัด TTFB (เวลาที่ไบต์แรกกลับมา เหมือนเวลาที่พนักงานทักว่า “รับอะไรดีครับ” หลังคุณเดินเข้าร้าน) ใช้ cache หน้า HTML และวางเนื้อหาหลักไว้ต้น HTML เพราะถ้าโดนตัดที่ 2MB ส่วนต้นคือส่วนที่รอด คำสั่งนี้วัดได้ทั้งสองค่า
วิธีทดสอบว่าบอท AI เห็นอะไรบนเว็บคุณ (ทำได้วันนี้)
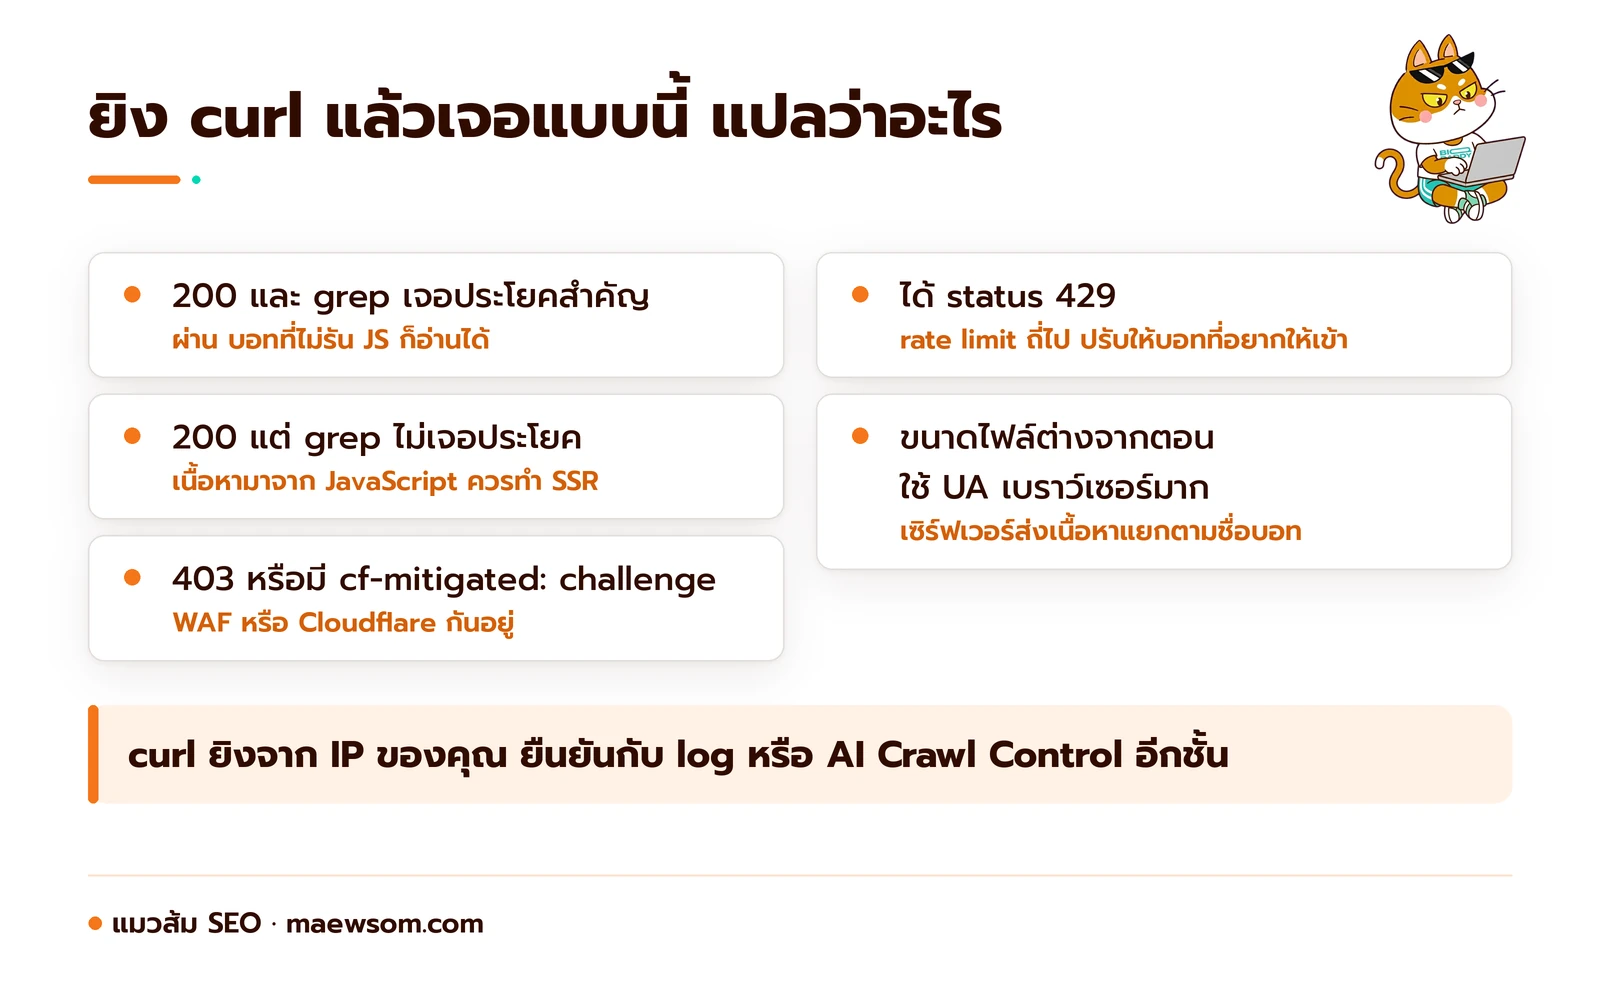
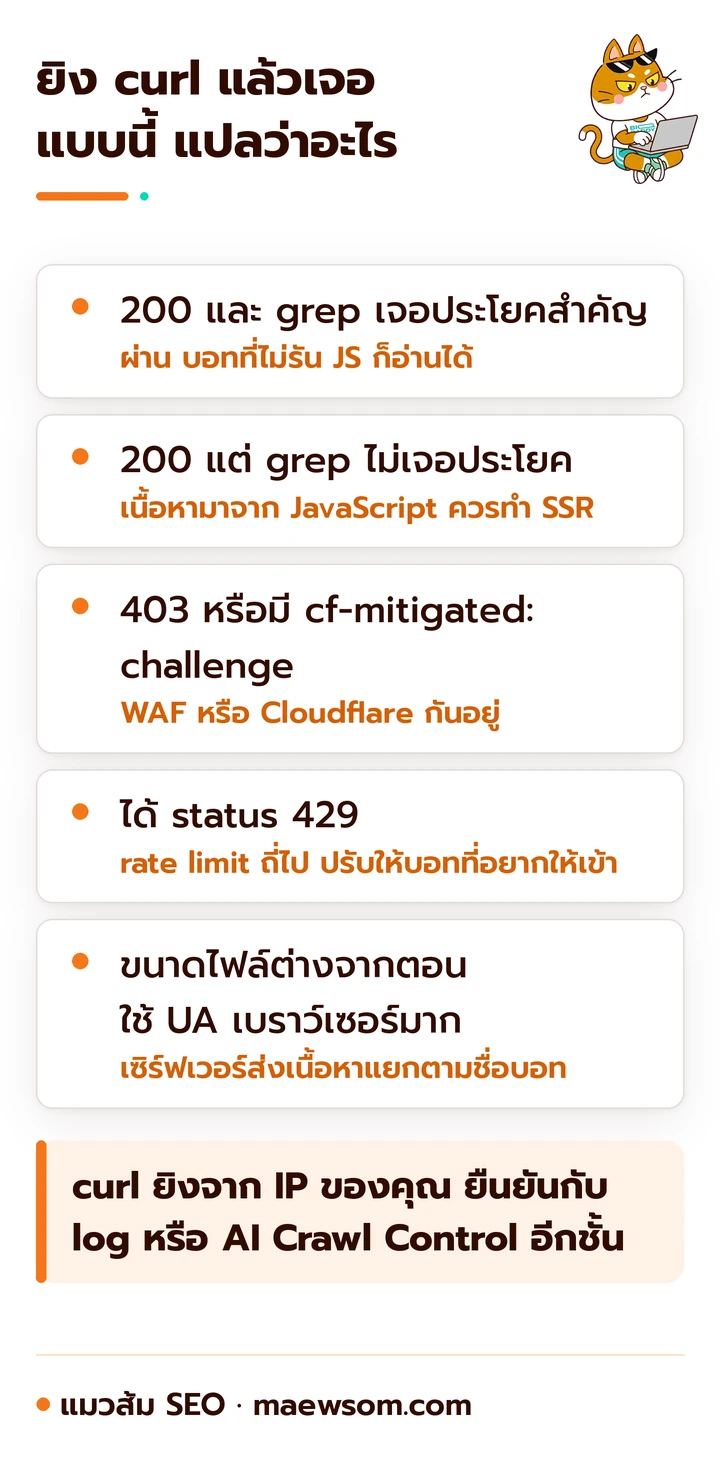
วิธีที่ตรงที่สุดคือดึงหน้าด้วย curl โดยใส่ user agent ของบอท แล้วค้นหาประโยคสำคัญของหน้าใน HTML ดิบ ถ้าเจอ แปลว่าบอทที่ไม่รัน JavaScript ก็เห็น ถ้าไม่เจอ แปลว่าประโยคนั้นถูก JavaScript ใส่เข้ามาทีหลัง อันนี้แหละที่แมวส้มชอบที่สุด เพราะใช้เวลาไม่ถึง 10 นาที และคุณได้เห็นเว็บตัวเองด้วยสายตาบอทจริงๆ
- เลือก 1 หน้าและ 1 ประโยค เช่น หน้าบริการหลัก กับประโยค “คอร์ส 8 ครั้ง ราคา 3,200 บาท” ที่คุณอยากให้ AI ยกไปตอบ
- ดึงหน้าแบบเบราว์เซอร์ทั่วไปก่อน เพื่อเอาไว้เทียบ บน Mac หรือ Linux เปิด Terminal ส่วน Windows ใช้ PowerShell โดยพิมพ์
curl.exeแทนcurlคัดลอก - ดึงซ้ำด้วย user agent ของบอท ใช้สตริงตามเอกสารของ OpenAI และ Perplexityคัดลอก
- ค้นหาประโยคใน HTML ดิบ ด้วย
grep -c "3,200 บาท" gptbot.html(Windows ใช้Select-String "3,200 บาท" gptbot.html) ได้เลข 1 ขึ้นไปแปลว่าเจอ ได้ 0 แปลว่าไม่เจอ - เช็ก header ว่าโดน challenge ไหม ใช้
curl -sI -A "GPTBot/1.4" https://example.co.th/kids-swim/แล้วดูว่ามีcf-mitigated: challengeหรือ status 403 หรือเปล่า - เทียบ view-source กับหน้าที่เรนเดอร์แล้ว ใน Chrome กด Ctrl+U (Mac: Cmd+Option+U) จะเห็น HTML ดิบแบบเดียวกับที่บอทได้ แล้วเปิด DevTools กด Ctrl+Shift+P พิมพ์ Disable JavaScript แล้วรีเฟรช สิ่งที่หายไปจากจอคือสิ่งที่บอท AI ส่วนใหญ่มองไม่เห็น
- ดูฝั่ง Google ใน Search Console ใช้ URL Inspection แล้วกด View crawled page จะเห็น HTML ที่ Google เรนเดอร์แล้ว ใช้ยืนยันฝั่ง AI Overviews และ AI Mode
ผลจริงที่แมวส้มลองกับ maewsom.com เองเมื่อ 19 ต.ค. 2026 คือหน้า /ai-seo/ai-crawlers/ ตอบ 200 ทั้งสามแบบ ขนาดเท่ากันเป๊ะ 179,324 bytes แปลว่าเว็บนี้ไม่ได้แยกเนื้อหาตาม user agent และไม่มีกฎที่ดักชื่อบอท ถ้าของคุณขนาดต่างกันมาก หรือบอทได้ 403 ให้ย้อนกลับไปไล่ที่ WAF
จะลองแบบ Glenn Gabe ก็ได้ ให้ ChatGPT หรือ Perplexity เปิด URL แล้วบอกย่อหน้าแรกกับย่อหน้าสุดท้าย เทียบกับหน้าที่ไม่ใช้ JavaScript แต่แชตบอตอาจตอบจาก cache หรือเดาเอา เชื่อ log มากกว่าคำพูดของบอทเสมอ
คำถามที่พบบ่อย
แหล่งอ้างอิง
- The rise of the AI crawler โดย Vercel และ MERJ (ธ.ค. 2024)
- Trust the Log, Not the Chatbot: What AI Search Crawlers Actually Read โดย Gianluca Fiorelli, Advanced Web Ranking (ส.ค. 2026)
- AI Search and JavaScript Rendering โดย Glenn Gabe, GSQi (ส.ค. 2025)
- Optimizing your website for generative AI features on Google Search โดย Google Search Central (อัปเดต ก.ค. 2026)
- Dynamic rendering as a workaround โดย Google Search Central (อัปเดต ธ.ค. 2025)
- How HTTP status codes affect Google’s crawlers โดย Google for Developers (อัปเดต ก.พ. 2026)
- Googlebot (file size limits) โดย Google Search Central (อัปเดต ก.พ. 2026)
- Block AI Bots โดย Cloudflare Docs (อัปเดต ก.ค. 2026)
- Bot Fight Mode โดย Cloudflare Docs (อัปเดต ส.ค. 2026)
- Analyze AI traffic โดย Cloudflare Docs (อัปเดต เม.ย. 2026)
- Challenge Pages และ Detect a Challenge Page response โดย Cloudflare Docs (ตรวจเมื่อ ต.ค. 2026)
- Keeping Content Discoverable with Sitemaps in AI Powered Search โดย Microsoft Bing (ก.ค. 2025)
- IndexNow FAQ โดย IndexNow.org (ตรวจเมื่อ ต.ค. 2026)
- Overview of OpenAI Crawlers โดย OpenAI (ตรวจเมื่อ ต.ค. 2026)
- Perplexity Crawlers โดย Perplexity (ตรวจเมื่อ ต.ค. 2026)
เขียนโดย
แมวส้มคือมาสคอตของทีม BIQDADDY เอเจนซี SEO และ AISO ในไทย เล่าเรื่อง AI SEO, GEO และ AEO แบบเข้าใจง่าย บทความเขียนด้วยระบบ AI ตามมาตรฐานของทีม ตรวจข้อเท็จจริงกับแหล่งต้นทาง และผ่านผู้ตรวจ AI อิสระก่อนเผยแพร่ ทีม BIQDADDY เป็นผู้ดูแลเว็บและแก้ไขเมื่อมีผู้แจ้งข้อผิดพลาด อ่านนโยบายการเขียน
เรียบเรียงเนื้อหาโดย วุฒิภัทร อุณหะกะ Co-Founder และ COO ของ BIQDADDY
อ่านต่อกับแมวส้ม
Zero-Click Search คืออะไร เมื่อคนค้นแล้วไม่คลิกเข้าเว็บ ต้องวัดผลยังไง
Vector Search คืออะไร การค้นหาด้วยความหมายที่อยู่เบื้องหลัง AI Search
Transformer Model คืออะไร ตัว T ใน GPT ที่ทำให้ AI เข้าใจภาษา