สารบัญ
AI Crawler คืออะไร ควรบล็อก GPTBot ไหม พร้อมตาราง User Agent และ robots.txt ที่ก็อปไปใช้ได้
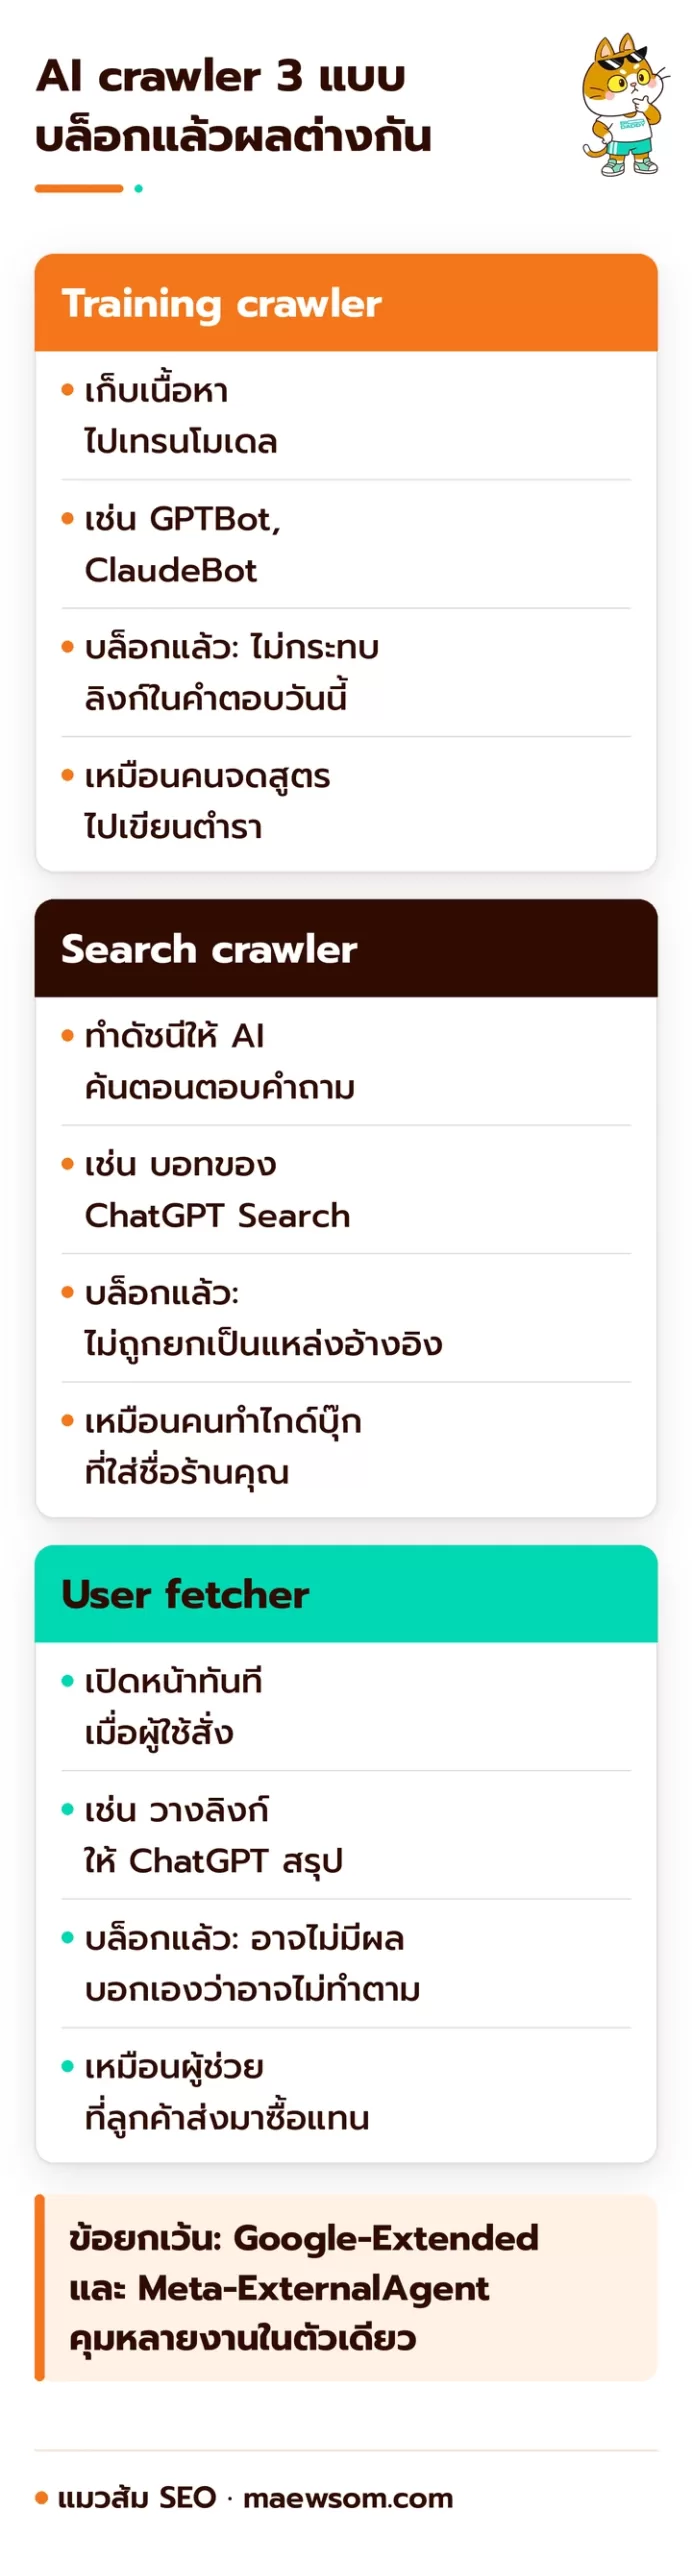
สวัสดีครับ ใครแอบมาเดินในเว็บคุณตอนตีสาม วันนี้แมวส้มจะพาไปดูหน้าตาทีละตัว AI crawler คือบอทที่บริษัท AI ส่งมาอ่านเว็บ แบ่งได้ 3 แบบ คือบอทเก็บข้อมูลไปเทรนโมเดล บอททำดัชนีให้ AI Search และบอทที่เปิดหน้าเว็บตอนผู้ใช้สั่ง ส่วนคำถามว่าควรบล็อก GPTBot ไหม คำตอบคือบล็อกได้โดยไม่หลุดจาก ChatGPT Search ตราบใดที่ยังเปิด OAI-SearchBot เพราะ OpenAI แยกสองตัวนี้ออกจากกันใน robots.txt
- บอทเทรนล้วน (GPTBot, ClaudeBot, Applebot-Extended, CCBot) บล็อกแล้วไม่กระทบการถูกค้นเจอใน AI Search ของค่ายนั้น
- บอทผสมต้องระวัง: Google-Extended คุมทั้งการเทรน Gemini และ grounding ใน Gemini Apps / Vertex AI (ไม่กระทบ Google Search, AI Overviews, AI Mode) ส่วน Meta-ExternalAgent ใช้ทั้งเทรนและทำดัชนี บล็อกสองตัวนี้แล้วอาจหายจากคำตอบของ Gemini หรือ Meta AI
- บอทค้นหา (OAI-SearchBot, Claude-SearchBot, PerplexityBot) ถ้าบล็อก คุณจะหายจากคำตอบของแพลตฟอร์มนั้น ส่วนใหญ่ควรเปิด
- บอทที่ผู้ใช้สั่ง (ChatGPT-User, Perplexity-User, Meta-ExternalFetcher) เจ้าของบอทเขียนเองว่าอาจไม่ทำตาม robots.txt ส่วน Claude-User ของ Anthropic ระบุว่าทำตาม
- robots.txt เป็นแค่ "คำขอ" ถ้าอยากบังคับจริงต้องบล็อกที่ firewall หรือ Cloudflare AI Crawl Control
AI crawler คืออะไร มีกี่แบบ
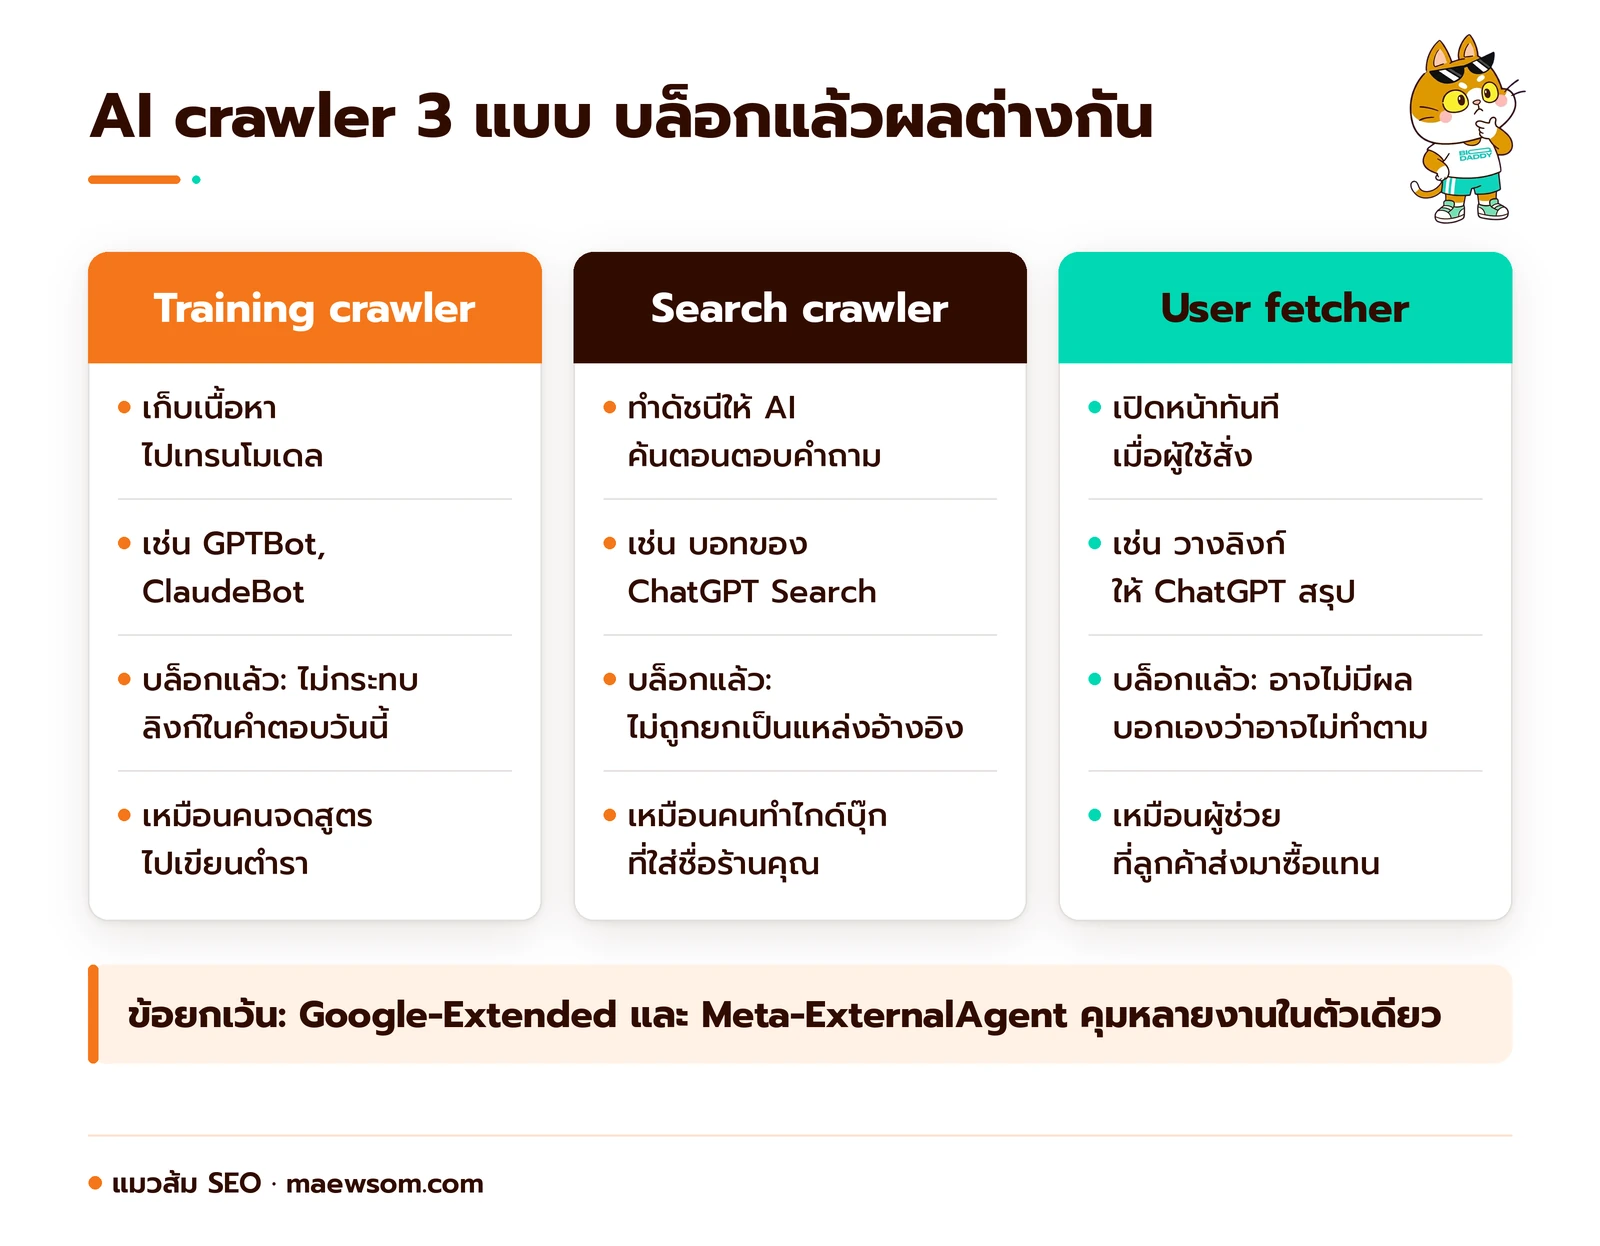
AI crawler คือโปรแกรมอัตโนมัติของบริษัท AI ที่ส่ง request มาอ่านหน้าเว็บ แล้วระบุตัวเองผ่าน user agent เช่น GPTBot หรือ ClaudeBot ชื่อบอทจำไม่ได้ไม่เป็นไร ใครเห็นรายชื่อยาวเหยียดแล้วมึน แมวส้มเข้าใจเลย ที่ต้องจำคือ “มันเอาเนื้อหาไปทำอะไร” เพราะการบล็อกแต่ละแบบให้ผลต่างกันมาก (user agent คือป้ายชื่อที่บอทติดหน้าอกมาตอนเคาะประตูเว็บ)
- Training crawler เก็บเนื้อหาไปเทรนโมเดลรุ่นถัดไป ถ้าเป็นบอทเทรนล้วนอย่าง GPTBot หรือ ClaudeBot บล็อกแล้วไม่มีผลกับการแสดงลิงก์ในคำตอบวันนี้ ยกเว้นตัวที่คุมหลายงาน คือ Google-Extended (เทรน + grounding ของ Gemini) และ Meta-ExternalAgent (เทรน + ทำดัชนี)
- Search crawler ทำดัชนีไว้ให้ AI ค้นตอนตอบคำถาม เช่น ChatGPT Search หรือ Perplexity บล็อกแล้วเว็บคุณจะไม่ถูกยกเป็นแหล่งอ้างอิง
- User fetcher เปิดหน้าเว็บทันทีเมื่อผู้ใช้สั่ง เช่น วางลิงก์ให้ ChatGPT สรุป ไม่ได้ไล่เก็บทั้งเว็บ และหลายเจ้าบอกว่าอาจไม่ทำตาม robots.txt
เปรียบให้เห็นภาพ training crawler คือคนมาจดสูตรอาหารไปเขียนตำรา search crawler คือคนทำไกด์บุ๊กที่ใส่ชื่อร้านคุณ ส่วน user fetcher คือผู้ช่วยที่ลูกค้าส่งมาซื้อของแทนตอนนั้นเลย เจ้าของบอทเลยมองว่าเป็นการกระทำแทนคน ไม่ใช่การเก็บข้อมูล ปิดประตูใส่คนทำไกด์บุ๊กเมื่อไร ร้านคุณก็หายจากไกด์บุ๊กเล่มนั้นทันที ส่วนคนจดสูตร จะไล่หรือไม่ไล่ ไกด์บุ๊กก็ยังพิมพ์ชื่อร้านคุณเหมือนเดิม
ตารางรายชื่อ AI crawler และ user agent ปี 2026
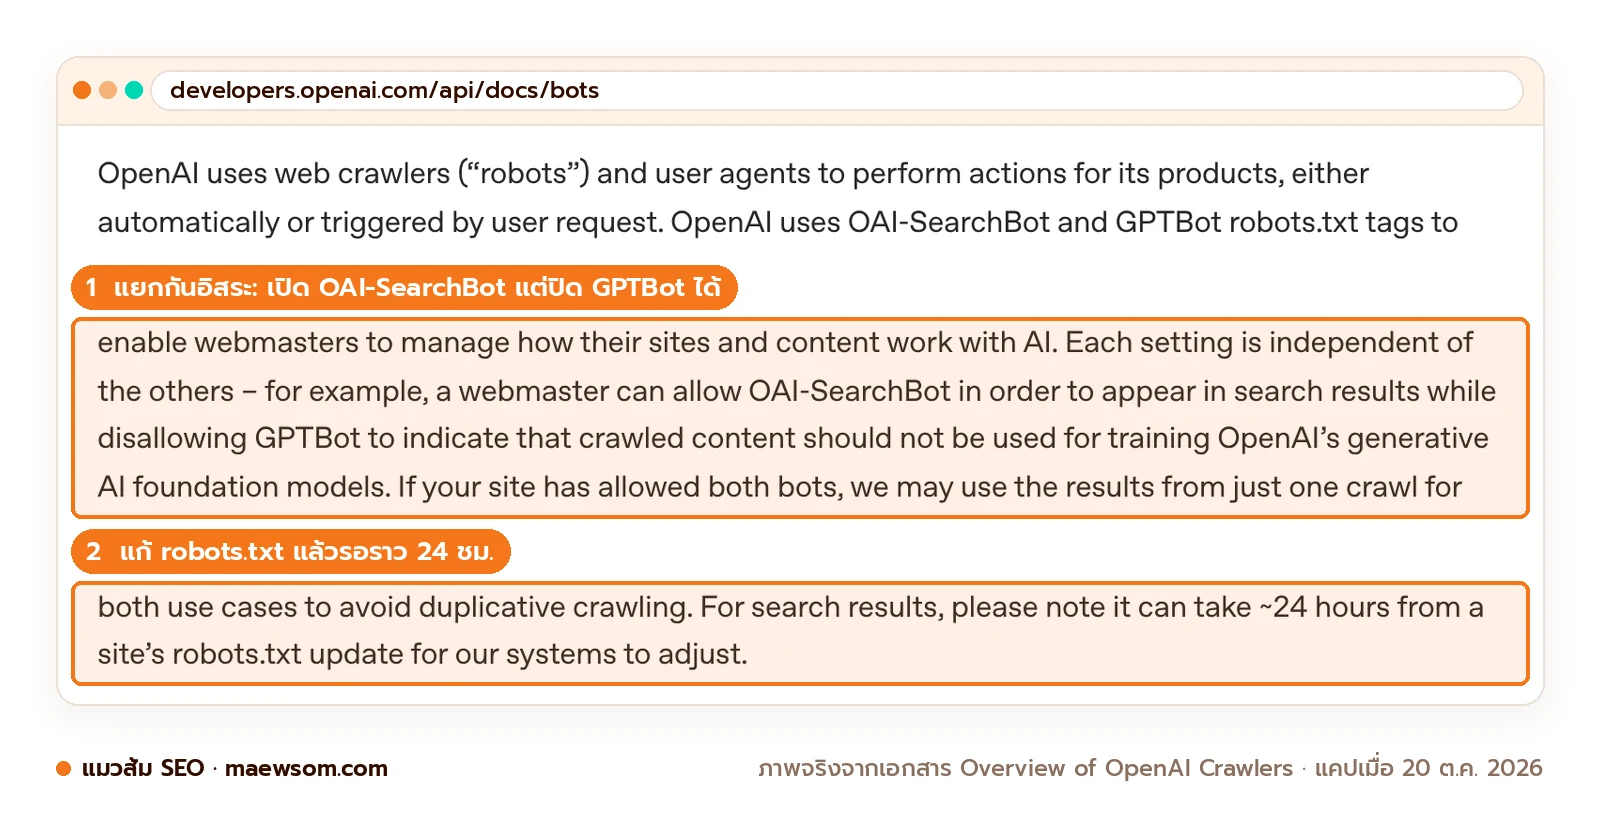
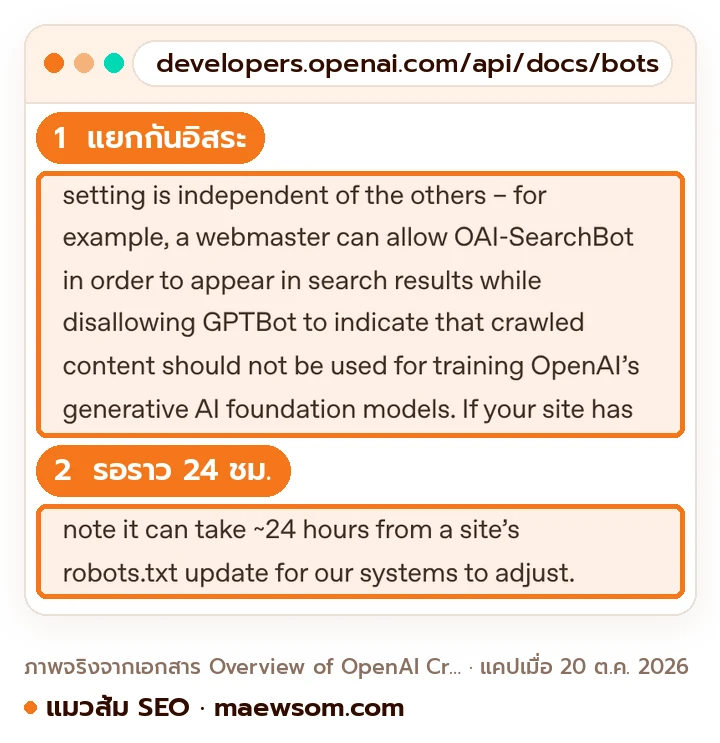
ตารางนี้รวมบอท AI หลักที่มีเอกสารทางการ (ยกเว้น Bytespider ที่ใส่ไว้เพราะคนถามถึงบ่อย) ตรวจจากเอกสารของแต่ละบริษัท ณ 19 ตุลาคม 2026 ช่อง “ทำตาม robots.txt” อ้างตามที่เจ้าของบอทประกาศ ไม่ได้แปลว่าพฤติกรรมจริงตรงกับคำประกาศเสมอ วิธีอ่านเร็วๆ คือดูคอลัมน์ “ประเภท” ก่อน แล้วค่อยดูว่าบล็อกแล้วเสียอะไร ตัวอย่างที่ชัดที่สุดคือเอกสารของ OpenAI ที่เขียนตรงๆ ว่า GPTBot กับ OAI-SearchBot ตั้งค่าแยกกันได้อิสระ
| User agent (token ใน robots.txt) | บริษัท | ประเภท | ถ้าบล็อกจะเกิดอะไร | ทำตาม robots.txt |
|---|---|---|---|---|
| GPTBot | OpenAI | Training | เนื้อหาไม่ถูกใช้เทรน foundation model ของ OpenAI | ใช่ |
| OAI-SearchBot | OpenAI | Search | ไม่ถูกแสดงในคำตอบ ChatGPT Search (ยังอาจโผล่เป็นลิงก์นำทาง) | ใช่ ปรับผลภายในราว 24 ชม. |
| ChatGPT-User | OpenAI | User fetch | OpenAI ระบุว่าไม่ได้ใช้ตัดสินการแสดงใน Search | OpenAI ระบุว่ากฎ robots.txt อาจไม่มีผล เพราะผู้ใช้เป็นคนสั่ง |
| OAI-AdsBot | OpenAI | ตรวจหน้า landing page ของโฆษณาใน ChatGPT | เข้าเฉพาะหน้าที่ส่งเป็นโฆษณา ข้อมูลไม่ถูกใช้เทรน | เอกสารไม่ระบุ |
| ClaudeBot | Anthropic | Training | เนื้อหาใหม่ถูกตัดออกจากชุดข้อมูลเทรน | ใช่ รองรับ Crawl-delay |
| Claude-SearchBot | Anthropic | Search | ไม่ถูกทำดัชนีเพื่อการค้นหา อาจเห็นน้อยลงในผลค้นหาของ Claude | ใช่ |
| Claude-User | Anthropic | User fetch | Claude ดึงหน้าคุณไปตอบผู้ใช้ไม่ได้ | ใช่ (Anthropic ระบุว่าบอททุกตัวทำตาม) |
| PerplexityBot | Perplexity | Search | ไม่ถูกแสดงและลิงก์ในผลค้นหา Perplexity | ใช่ (ตามประกาศ) |
| Perplexity-User | Perplexity | User fetch | ผู้ใช้สั่งให้เปิดหน้าคุณไม่ได้ | Perplexity ระบุว่าโดยทั่วไปไม่ทำตาม |
| Google-Extended | Training + grounding ของ Gemini | ไม่ถูกใช้เทรน Gemini และไม่ถูกใช้ grounding คำตอบใน Gemini Apps / Grounding with Google Search บน Vertex AI ไม่กระทบ Google Search | ใช่ (เป็น token ควบคุม ไม่มีบอทแยก) | |
| Google-CloudVertexBot | Crawl ตามที่เจ้าของเว็บขอ เพื่อสร้าง Vertex AI Agents | crawl สำหรับ Vertex AI Agents ของคุณไม่ทำงาน ไม่กระทบ Google Search | ใช่ (Google ระบุว่า common crawlers ทำตามเสมอ) | |
| Applebot-Extended | Apple | Training | ไม่ถูกใช้เทรน foundation model ของ Apple ยังอยู่ใน Spotlight, Siri, Safari | ใช่ (เป็น token ควบคุม ไม่ได้ crawl เอง) |
| CCBot | Common Crawl | คลังข้อมูลเปิด (ถูกนำไปเทรน AI หลายเจ้า) | ไม่อยู่ในคลัง Common Crawl รอบใหม่ | ใช่ (ตามประกาศ) |
| Meta-ExternalAgent | Meta | Training + ทำดัชนี | ไม่ถูกใช้เทรนโมเดล AI ของ Meta และไม่ถูกทำดัชนีโดยตรง อาจเห็นน้อยลงในคำตอบของ Meta AI | ใช่ (ตามประกาศ) |
| Meta-ExternalFetcher | Meta | User fetch | ผู้ใช้สั่ง AI ของ Meta เปิดหน้าคุณไม่ได้ | Meta ระบุว่าอาจข้าม robots.txt |
| Bytespider | ByteDance | รายงานว่าเป็น Training | ไม่มีเอกสารทางการให้ตรวจ | ไม่มีคำประกาศทางการ |
จุดที่คนเข้าใจผิดบ่อยในตารางนี้
Google-Extended ไม่ใช่สวิตช์ AI Overviews Google-Extended ไม่กระทบ Google Search และไม่ใช่ ranking signal ถ้าอยากออกจาก AI Overviews, AI Mode และฟีเจอร์ AI ใน Discover ให้ใช้ Search Console > Settings > Search generative AI แล้วเลือก Exclude ซึ่งเปิดให้ทุกเว็บทั่วโลกตั้งแต่ 31 สิงหาคม 2026 ตัวนี้ไม่กระทบอันดับปกติ โดยทั่วไปเอาออกภายใน 1-2 วัน แต่ไม่คุมการเทรน (ยังต้องใช้ Google-Extended) ถ้าแค่อยากจำกัดข้อความบางส่วน ใช้ nosnippet หรือ max-snippet รายละเอียดอยู่ใน AI Overview คืออะไร
Google-Extended และ Applebot-Extended จะไม่โผล่ใน log สองตัวนี้เป็นแค่ token ใน robots.txt การ crawl จริงทำด้วย Googlebot และ Applebot ใครค้น log หา Google-Extended แล้วไม่เจอ ไม่ต้องตกใจ มันไม่ได้หนี มันไม่เคยมีตัวตนเป็นบอทแยกตั้งแต่แรก เหมือนหาคนชื่อ “ห้ามถ่ายรูป” ในร้าน ซึ่งที่จริงเป็นแค่ป้าย
เลขเวอร์ชันเปลี่ยนได้ หลายคนค้น “gptbot 1.3” แต่เอกสาร OpenAI ปัจจุบันยกตัวอย่าง GPTBot/1.4 และบอกว่าเลขเวอร์ชันอาจเปลี่ยน เวลาเขียนกฎ firewall หรือค้น log ให้จับแค่ชื่อบอท อย่าจับเลขเวอร์ชัน
Bytespider แมวส้มไม่พบเอกสารทางการจาก ByteDance ข้อมูลที่มีมาจากบุคคลที่สาม Cloudflare เคยรายงานเมื่อกรกฎาคม 2024 ว่า Bytespider เป็นบอท AI ที่ส่ง request มากที่สุดบนเครือข่ายของตน และถูกบล็อกบ่อยที่สุด แต่ ข้อมูลชุดใหม่ของ Cloudflare (สิงหาคม 2025) พบว่าส่วนแบ่งของ Bytespider ในทราฟฟิกบอท AI ลดจาก 37.3% (กรกฎาคม 2024) เหลือ 5.8% (กรกฎาคม 2025) ส่วนอันดับหนึ่งกลายเป็น GPTBot ที่ 28.1%
ควรบล็อก GPTBot ไหม ใช้ตัดสินใจยังไง
ตัดสินจากคำถามเดียว เนื้อหาของคุณเป็น “สินค้า” หรือเป็น “ช่องทางหาลูกค้า” ถ้าเนื้อหาคือสินค้า เช่น ข่าว คอร์ส งานวิจัย การบล็อก GPTBot และบอทเทรนล้วนตัวอื่นสมเหตุสมผล ถ้าเนื้อหามีไว้ดึงลูกค้า การเปิดไว้ให้ AI รู้จักแบรนด์มากที่สุดก็มีเหตุผล ไม่มีคำตอบเดียวที่ถูกสำหรับทุกเว็บ และไม่ต้องรู้สึกผิดไม่ว่าจะเลือกทางไหน
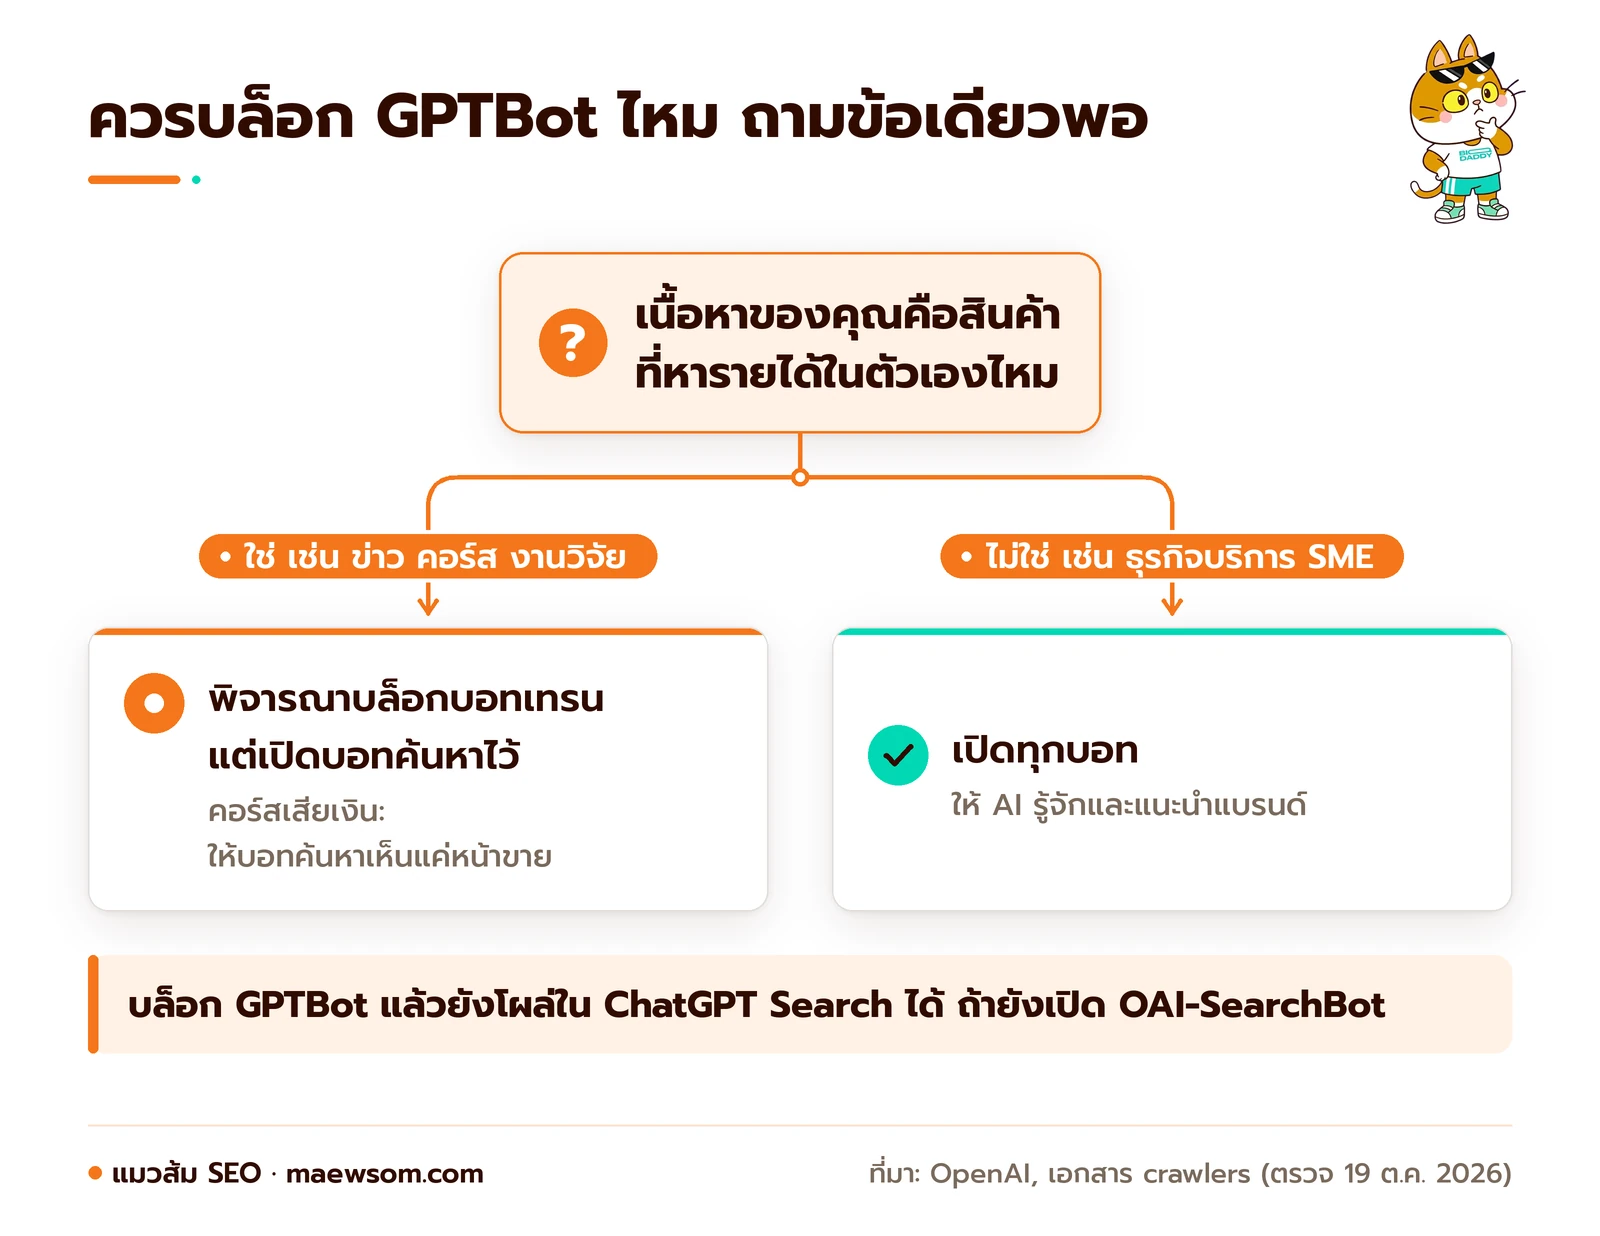
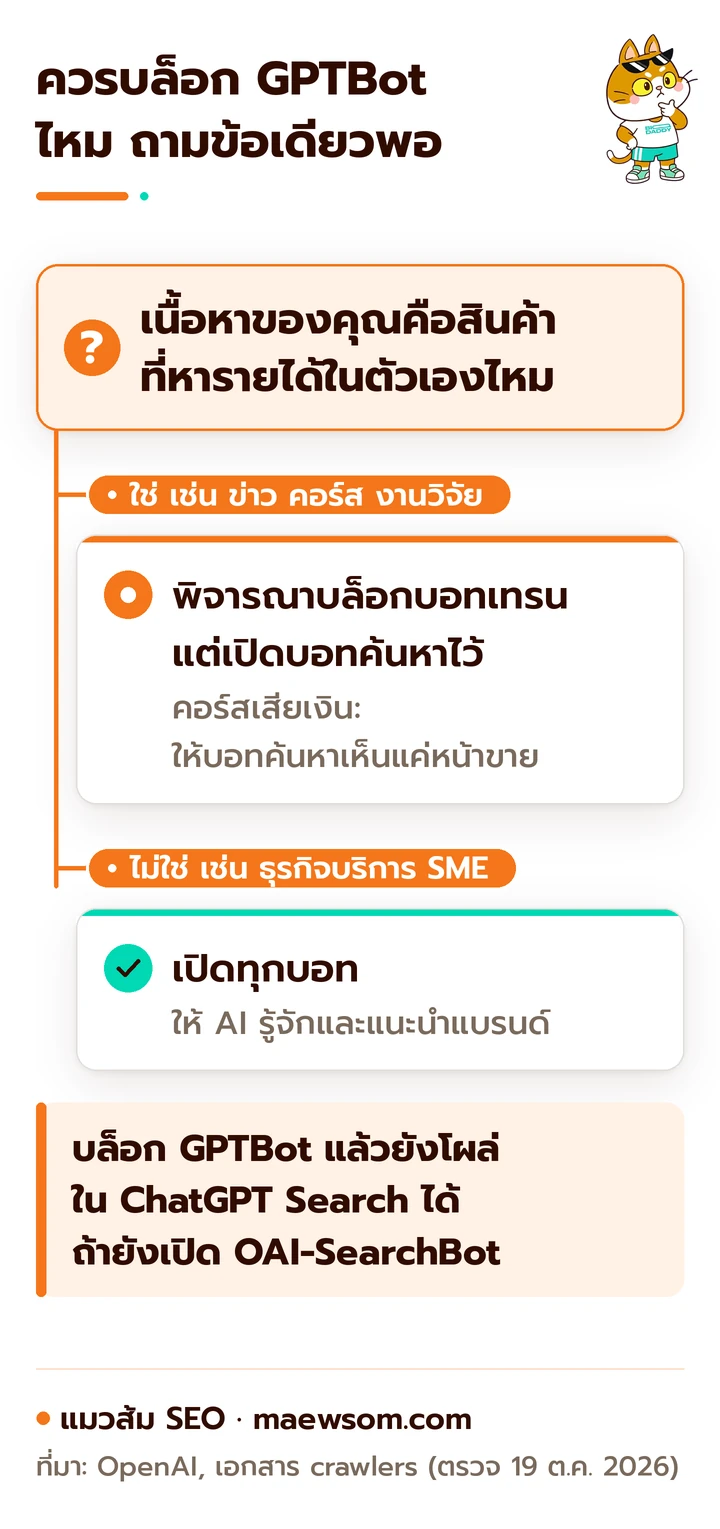
ลองเทียบสองเว็บสมมติ โฮมสเตย์เล็กๆ ในเชียงคานมีบทความ “เที่ยวเชียงคาน 2 วัน 1 คืน” ไว้ดึงแขกเข้าที่พัก ถ้า AI เอาไปเรียนแล้วจำชื่อที่พักได้ เจ้าของก็แทบไม่เสียอะไร ส่วนเว็บคอร์สทำอาหารที่ขายคลิปสอนสูตรน้ำจิ้ม ตัวสูตรคือของที่เก็บเงิน ปล่อยให้บอทเทรนเก็บไปฟรีก็เหมือนยกสูตรลับประจำบ้านให้คู่แข่ง เจ็บนะ
| ประเภทเว็บ | บอทเทรน | บอทค้นหา | บอทผู้ใช้สั่ง | เหตุผล |
|---|---|---|---|---|
| ธุรกิจบริการ คลินิก ร้านค้า SME | เปิด | เปิด | เปิด | อยากให้ AI รู้จักและแนะนำแบรนด์ ไม่มีเนื้อหาที่ขายได้ในตัวเอง |
| สื่อ สำนักข่าว คอนเทนต์ที่หารายได้จากเนื้อหา | พิจารณาบล็อก | เปิด | เปิด | อยากได้ทราฟฟิกจากการอ้างอิง แต่ไม่อยากให้เนื้อหาเป็นวัตถุดิบเทรนฟรี |
| คอร์สออนไลน์ งานวิจัยแบบเสียเงิน | บล็อก | เปิดเฉพาะหน้าขาย | ตามความเหมาะสม | เนื้อหาคือสินค้า ให้ AI เห็นแค่หน้าแนะนำคอร์ส |
คำถามที่ช่วยตัดสินใจเร็วที่สุดคือ “ถ้าลูกค้าถาม ChatGPT ถึงธุรกิจแบบเรา เราอยากให้ชื่อเราโผล่ไหม” ถ้าตอบว่าอยาก ห้ามแตะบอทค้นหาเด็ดขาด ปิดบอทค้นหาแล้วหวังให้ AI แนะนำร้าน ก็เหมือนปิดร้านแล้วรอรีวิวห้าดาว รายละเอียดเรื่องให้ ChatGPT แนะนำแบรนด์อยู่ใน ChatGPT SEO
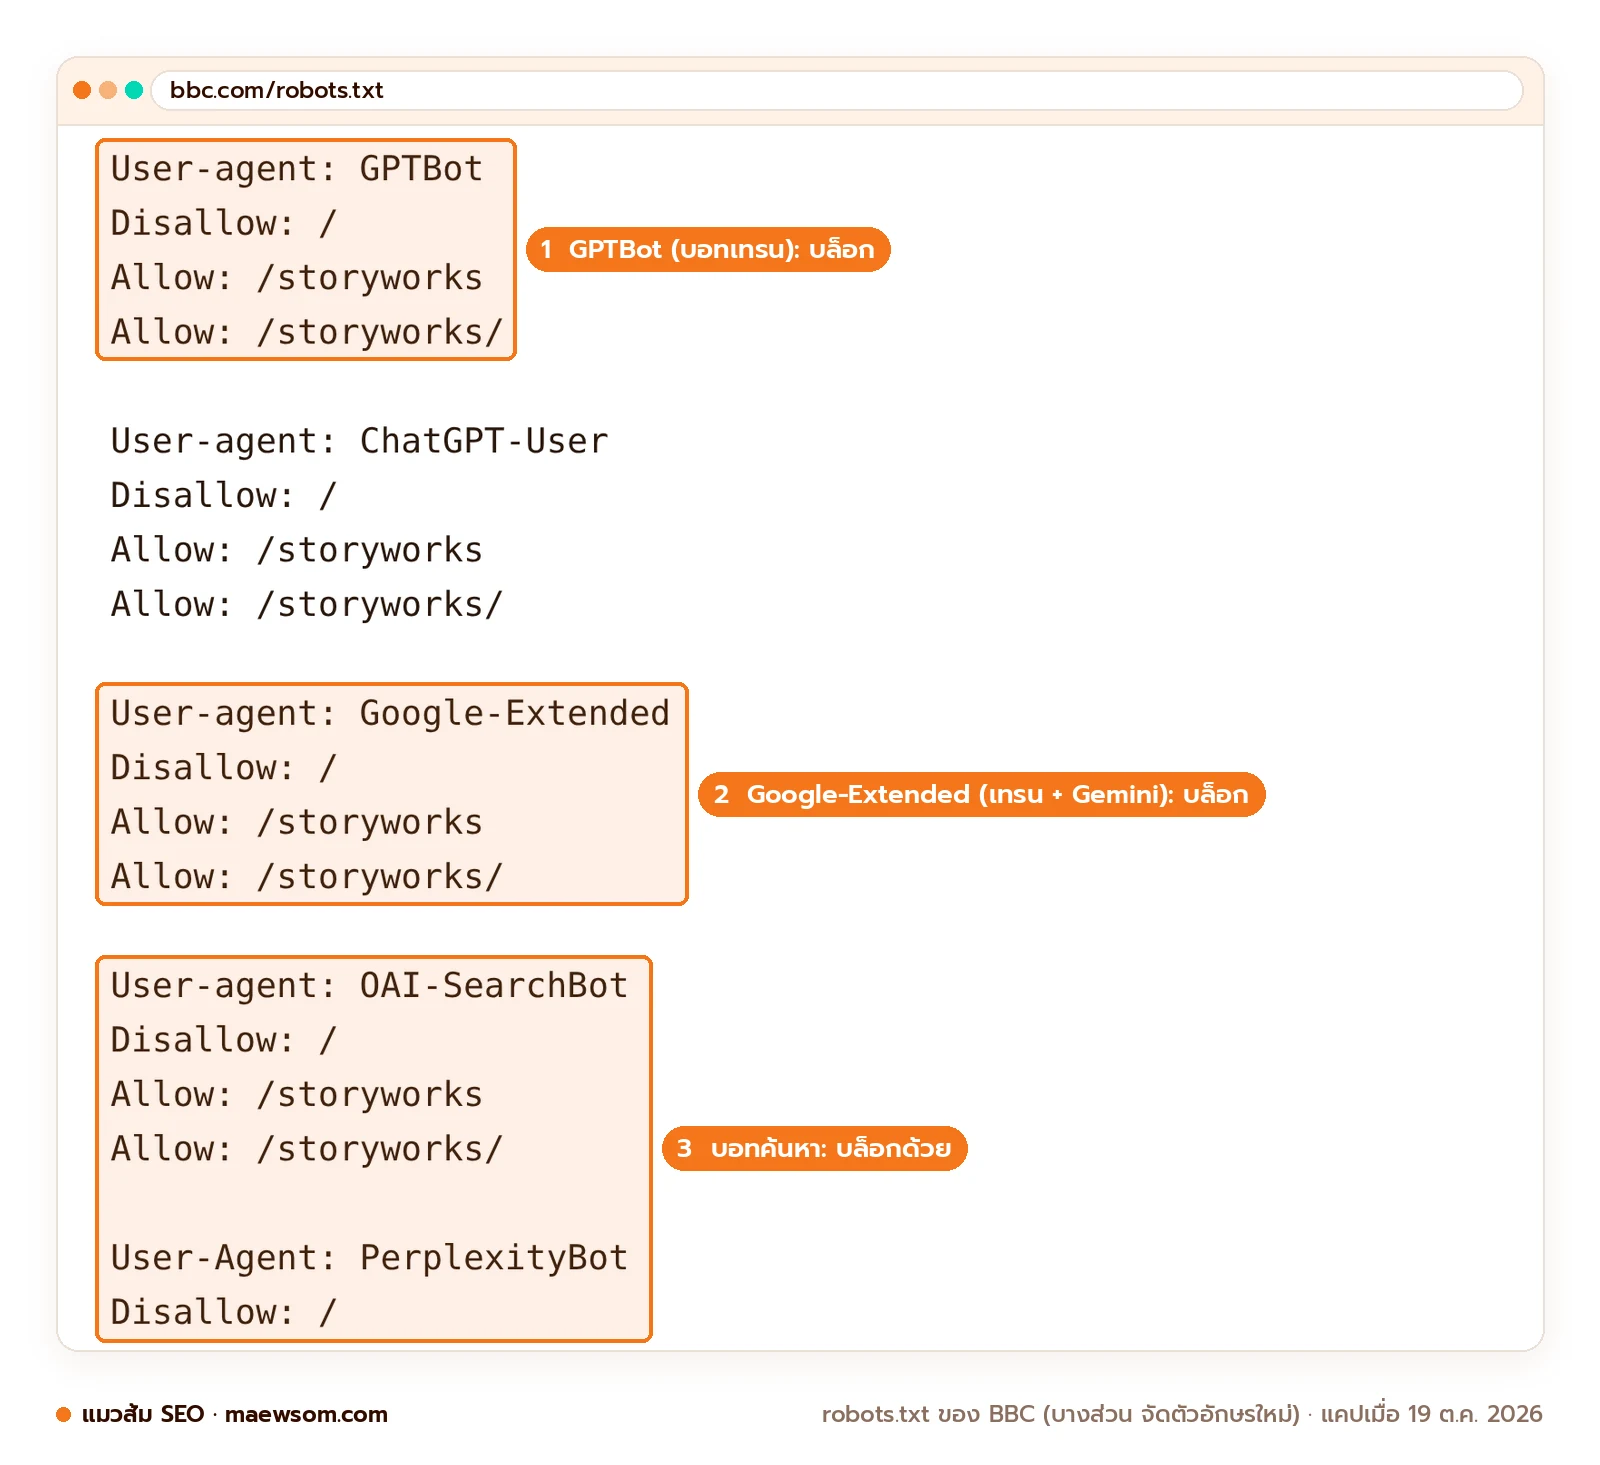
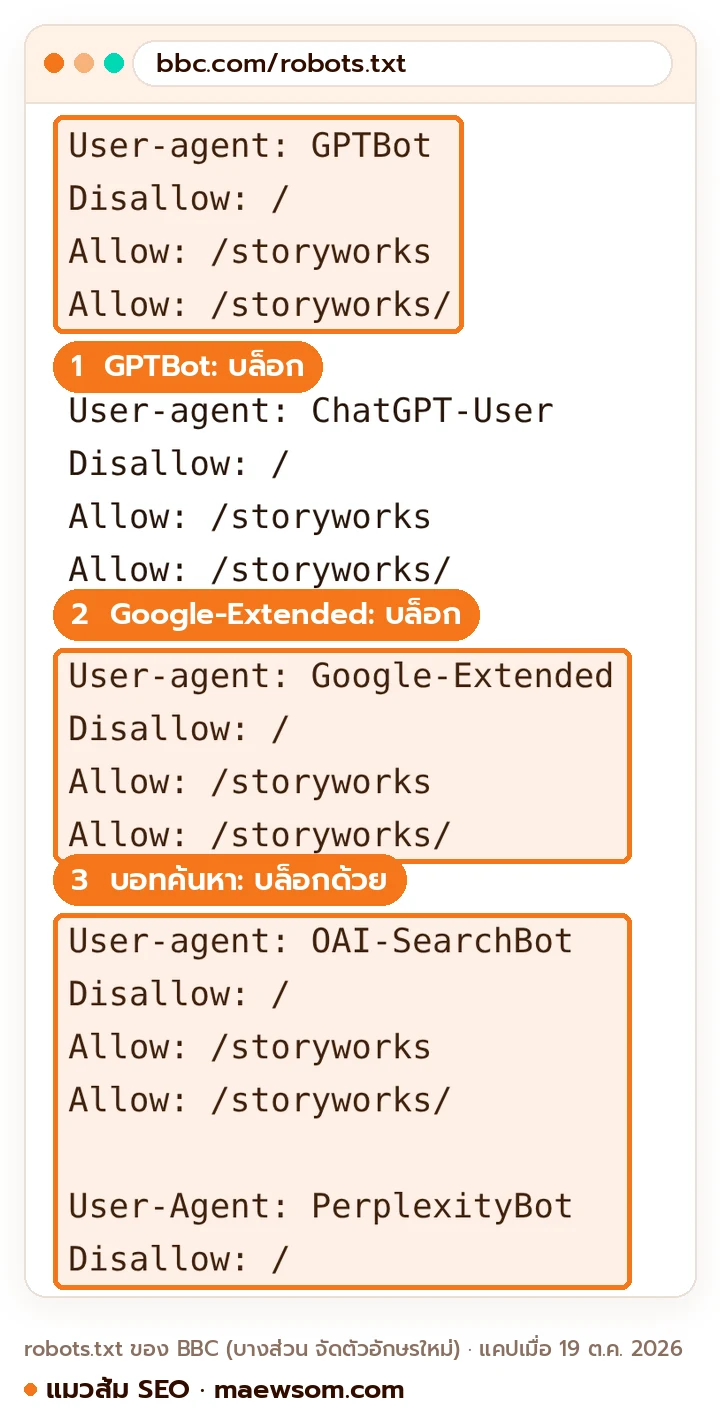
ตัวอย่างจริงของสื่อที่เลือกทางเข้มที่สุดคือ BBC ไฟล์ robots.txt ของ BBC (แมวส้มเปิดดูเมื่อ 19 ต.ค. 2026) บล็อกทั้งบอทเทรนอย่าง GPTBot และ Google-Extended และบอทค้นหาอย่าง OAI-SearchBot และ PerplexityBot โดยเปิดไว้แค่บางโฟลเดอร์ ตามกติกาข้างบน แปลว่า BBC ยอมไม่ถูกยกเป็นแหล่งอ้างอิงจากบอทค้นหาสองตัวนี้เพื่อกันเนื้อหาไว้ทั้งหมด ซึ่งเข้มกว่าแถว “สื่อ” ในตารางที่ยังเปิดบอทค้นหาไว้ จะเลือกแบบไหนขึ้นกับว่าคุณยอมแลกทราฟฟิกจากการอ้างอิงได้แค่ไหน
ตัวอย่าง robots.txt สำหรับ GPTBot และ AI crawler พร้อมก็อป
robots.txt ต้องวางที่ root ของแต่ละโดเมนและ subdomain เช่น https://example.co.th/robots.txt แต่ละบอทจะอ่านกลุ่ม User-agent ที่ตรงชื่อตัวเองที่สุด ถ้าไม่มีกลุ่มของตัวเองจะใช้กลุ่ม * คิดแบบป้ายหน้าร้าน ป้ายที่เขียนชื่อใครตรงตัวจะชนะป้าย “ทุกท่าน” เสมอ ข้างล่างมี 3 ชุดพร้อมก็อป เลือกชุดที่ตรงกับการตัดสินใจของคุณได้เลย
แบบที่ 1 บล็อกบอทเทรน เปิดบอทค้นหา (แนะนำสำหรับสื่อ)
แบบที่ 2 เปิดทุกบอท แต่กันโฟลเดอร์ส่วนตัว (แนะนำสำหรับ SME)
บอท AI ทุกตัวจะใช้กลุ่ม * นี้ เพราะไม่มีกลุ่มของตัวเองแยก
แบบที่ 3 ลดความถี่ของ ClaudeBot แทนการบล็อก
Anthropic ระบุว่ารองรับ Crawl-delay ซึ่งเป็นคำสั่งนอกมาตรฐาน บอทบางตัวไม่รองรับ เช่น Googlebot ไม่สนคำสั่งนี้
ตั้งค่า AI crawler บน Cloudflare
Cloudflare มีเครื่องมือจัดการบอท AI ใช้ได้ทุกแพ็กเกจรวมถึงฟรี ชื่อว่า AI Crawl Control (เดิมชื่อ AI Audit) ใช้ดูว่าบอทไหนเข้าและสั่ง Allow หรือ Block รายตัว ต่างจาก robots.txt ตรงที่บล็อกจริงที่ขอบเครือข่าย ถ้า robots.txt คือป้าย “ขอความกรุณางดเข้า” AI Crawl Control ก็คือไม้กั้นที่มี รปภ. ยืนเฝ้า
- ล็อกอิน Cloudflare dashboard เลือกบัญชีและโดเมน
- ไปที่เมนู AI Crawl Control แล้วเข้าแท็บ Security ตาราง Crawlers มีคอลัมน์ Crawler (ชื่อบอทและเจ้าของ), Category, Requests, Robots.txt violations (จำนวนครั้งที่ละเมิดกฎของคุณ) และ Action
- ในคอลัมน์ Action เลือก Allow สำหรับบอทที่อยากให้อ้างอิงคุณ (เช่น OAI-SearchBot) และ Block สำหรับบอทที่ไม่ต้องการ
- ถ้าอยากตั้งเป็นกลุ่ม ไปที่ Security Settings > Configure AI bot policies จะมี 3 กลุ่มคือ Search, Agent และ Training แต่ละกลุ่มเลือกได้ว่า Block ทั้งเว็บ, Block เฉพาะหน้าที่มีโฆษณา หรือ Allow
ข้อนี้สำคัญมาก ตั้งแต่ 15 กันยายน 2026 Cloudflare ตั้งค่าเริ่มต้นใหม่ให้โดเมนใหม่ คือบล็อกบอทกลุ่ม Training และ Agent บนหน้าที่มีโฆษณา ส่วน Search ยังเปิด และตัวเลือกเดิมชื่อ “Block AI bots” มีกำหนดเลิกใช้ในวันเดียวกัน ซึ่งผ่านมาแล้ว ณ เวลาที่เขียน เว็บที่เคยใช้ตัวเลือกนี้ให้ไปตั้งใหม่ใน Configure AI bot policies บนแพ็กเกจฟรี Cloudflare จับบอทจาก user agent อย่างเดียว ถ้าบอทปลอมชื่อ แพ็กเกจที่สูงกว่าจะตรวจจับได้ละเอียดกว่า
วิธีเช็ก AI crawler จาก server log
วิธีที่แม่นที่สุดในการรู้ว่า AI crawler ตัวไหนเข้าเว็บคุณ คือเปิด access log ของเซิร์ฟเวอร์ แล้วกรองตามชื่อ user agent access log ก็คือกล้องวงจรปิดของเว็บ บันทึกทุกคนที่เดินผ่านประตู พร้อมเวลาและหน้าที่เข้าไปดู ฟังดูเหมือนงานโปรแกรมเมอร์ แต่จริงๆ ก็อปคำสั่งข้างล่างไปวางได้เลย
- หาไฟล์ log บน Nginx มักอยู่ที่
/var/log/nginx/access.logบน Apache ที่/var/log/apache2/access.logถ้าใช้ shared hosting ให้หาเมนู Raw Access Logs ใน cPanel - นับ request ของบอท AI คำสั่งนี้นับจำนวนครั้งที่แต่ละบอทเข้ามาคัดลอก
- ดูว่าบอทอ่านหน้าไหน เช่น ดู 20 URL ที่ OAI-SearchBot เข้าบ่อยที่สุดคัดลอก
- ตรวจว่าเป็นบอทจริง user agent ปลอมกันง่าย ให้เอา IP ไปเทียบกับรายการที่เจ้าของบอทเผยแพร่ OpenAI มีไฟล์
openai.com/gptbot.json,searchbot.jsonและchatgpt-user.jsonส่วน Perplexity มีperplexity.com/perplexitybot.jsonCommon Crawl และ Apple ตรวจด้วย reverse DNS ได้ - เช็กว่าถูกบล็อกโดยไม่ตั้งใจไหม ถ้าเห็นบอทค้นหาได้ status 403 หรือ 429 เยอะ แปลว่า firewall หรือปลั๊กอินความปลอดภัยกำลังกันบอทที่คุณอยากให้เข้า
reverse DNS คือการถาม IP กลับว่า “คุณชื่ออะไร” แล้วถามชื่อนั้นซ้ำว่า “บ้านเลขที่อะไร” ถ้าตอบตรงกันทั้งสองรอบคือของจริง ตัวอย่างจากเอกสาร Common Crawl ข้างล่าง ชื่อโฮสต์ต้องเป็นโดเมนของเจ้าของบอท และค้นกลับต้องได้ IP เดิม
ข้อยกเว้นคือ Anthropic ระบุว่ายังไม่เผยแพร่ช่วง IP ของบอท และเตือนว่าการบล็อกด้วย IP อาจทำให้บอทอ่าน robots.txt ไม่ได้ จึงควรคุม ClaudeBot ผ่าน robots.txt เป็นหลัก ส่วนการทำเว็บให้ Claude หยิบไปตอบ อ่านต่อที่ Claude SEO
คำถามที่พบบ่อย
แหล่งอ้างอิง
- Overview of OpenAI Crawlers โดย OpenAI (ตรวจเมื่อ ต.ค. 2026)
- Does Anthropic crawl data from the web, and how can site owners block the crawler? โดย Anthropic (Claude Help Center) (ตรวจเมื่อ ต.ค. 2026)
- Perplexity Crawlers โดย Perplexity (ตรวจเมื่อ ต.ค. 2026)
- Search generative AI control โดย Google Search Console Help (ตรวจเมื่อ ต.ค. 2026)
- Meta Web Crawlers โดย Meta for Developers (ตรวจเมื่อ ต.ค. 2026)
- CCBot โดย Common Crawl (ตรวจเมื่อ ต.ค. 2026)
- Google’s common crawlers โดย Google for Developers (อัปเดต ต.ค. 2026)
- About Applebot โดย Apple Support (อัปเดต ก.ย. 2026)
- Manage AI crawlers โดย Cloudflare Docs (อัปเดต ก.ค. 2026)
- Block AI Bots โดย Cloudflare Docs (อัปเดต ก.ค. 2026)
- AI features and your website โดย Google Search Central (อัปเดต ธ.ค. 2025)
- The crawl-to-click gap: Cloudflare data on AI bots, training, and referrals โดย Cloudflare Blog (João Tomé) (อัปเดต ส.ค. 2025)
- Perplexity is using stealth, undeclared crawlers to evade website no-crawl directives โดย Cloudflare Blog (อัปเดต ส.ค. 2025)
- Declare your AIndependence: block AI bots, scrapers and crawlers with a single click โดย Cloudflare Blog (อัปเดต ก.ค. 2024)
เขียนโดย
แมวส้มคือมาสคอตของทีม BIQDADDY เอเจนซี SEO และ AISO ในไทย เล่าเรื่อง AI SEO, GEO และ AEO แบบเข้าใจง่าย บทความเขียนด้วยระบบ AI ตามมาตรฐานของทีม ตรวจข้อเท็จจริงกับแหล่งต้นทาง และผ่านผู้ตรวจ AI อิสระก่อนเผยแพร่ ทีม BIQDADDY เป็นผู้ดูแลเว็บและแก้ไขเมื่อมีผู้แจ้งข้อผิดพลาด อ่านนโยบายการเขียน
เรียบเรียงเนื้อหาโดย วุฒิภัทร อุณหะกะ Co-Founder และ COO ของ BIQDADDY
อ่านต่อกับแมวส้ม
Zero-Click Search คืออะไร เมื่อคนค้นแล้วไม่คลิกเข้าเว็บ ต้องวัดผลยังไง
Vector Search คืออะไร การค้นหาด้วยความหมายที่อยู่เบื้องหลัง AI Search
Transformer Model คืออะไร ตัว T ใน GPT ที่ทำให้ AI เข้าใจภาษา