สารบัญ
Perplexity SEO ทำยังไงให้ Perplexity เลือกเว็บคุณเป็นแหล่งอ้างอิง
สวัสดีครับ วันนี้แมวส้มพามารู้จักเครื่องมือค้นหาที่ขยันแปะแหล่งอ้างอิงที่สุดในตลาด Perplexity SEO คือการทำให้ Perplexity เลือกหน้าเว็บของคุณเป็นแหล่งอ้างอิงในคำตอบ ซึ่งโชว์เป็นป้ายชื่อเว็บพร้อมลิงก์ต่อท้ายประโยค สิ่งที่ทำได้มี 3 อย่าง คือเปิดประตูให้ PerplexityBot เข้าเว็บ เขียนให้แต่ละย่อหน้าตอบคำถามได้ในตัวเอง และดูแลข้อมูลให้สดอยู่เสมอ (ข้อสุดท้ายเป็นการอนุมานของแมวส้ม)
- Perplexity แปะป้ายแหล่งอ้างอิงต่อท้ายประโยคในคำตอบ จึงเป็น AI ที่ตรวจง่ายที่สุดว่าเว็บไหนถูกเลือก
- PerplexityBot คือบอทที่ทำให้เว็บโผล่ในผลของ Perplexity และ Perplexity ระบุว่าไม่ได้ใช้เทรนโมเดล ถ้าบล็อกตัวนี้ เว็บมีโอกาสหายจากผลค้นหาของ Perplexity
- Perplexity-User เข้าเว็บตอนผู้ใช้สั่ง และตามเอกสาร Perplexity ตัวนี้มัก "ไม่สนใจ" robots.txt
- Perplexity บอกว่าระบบ index ของตัวเองหั่นเอกสารเป็นชิ้นเล็กแล้วให้คะแนนทีละชิ้น แมวส้มจึงแนะนำให้เขียนย่อหน้าที่ตอบชัดในตัวเอง
- ช่อง AI Assistant ใน GA4 ยังไม่นับ Perplexity (รายงานโดย Search Engine Journal ก.ค. 2026) ต้องดูใน Referral หรือทำ custom channel group เอง
Perplexity เลือกและแสดงแหล่งอ้างอิงยังไง
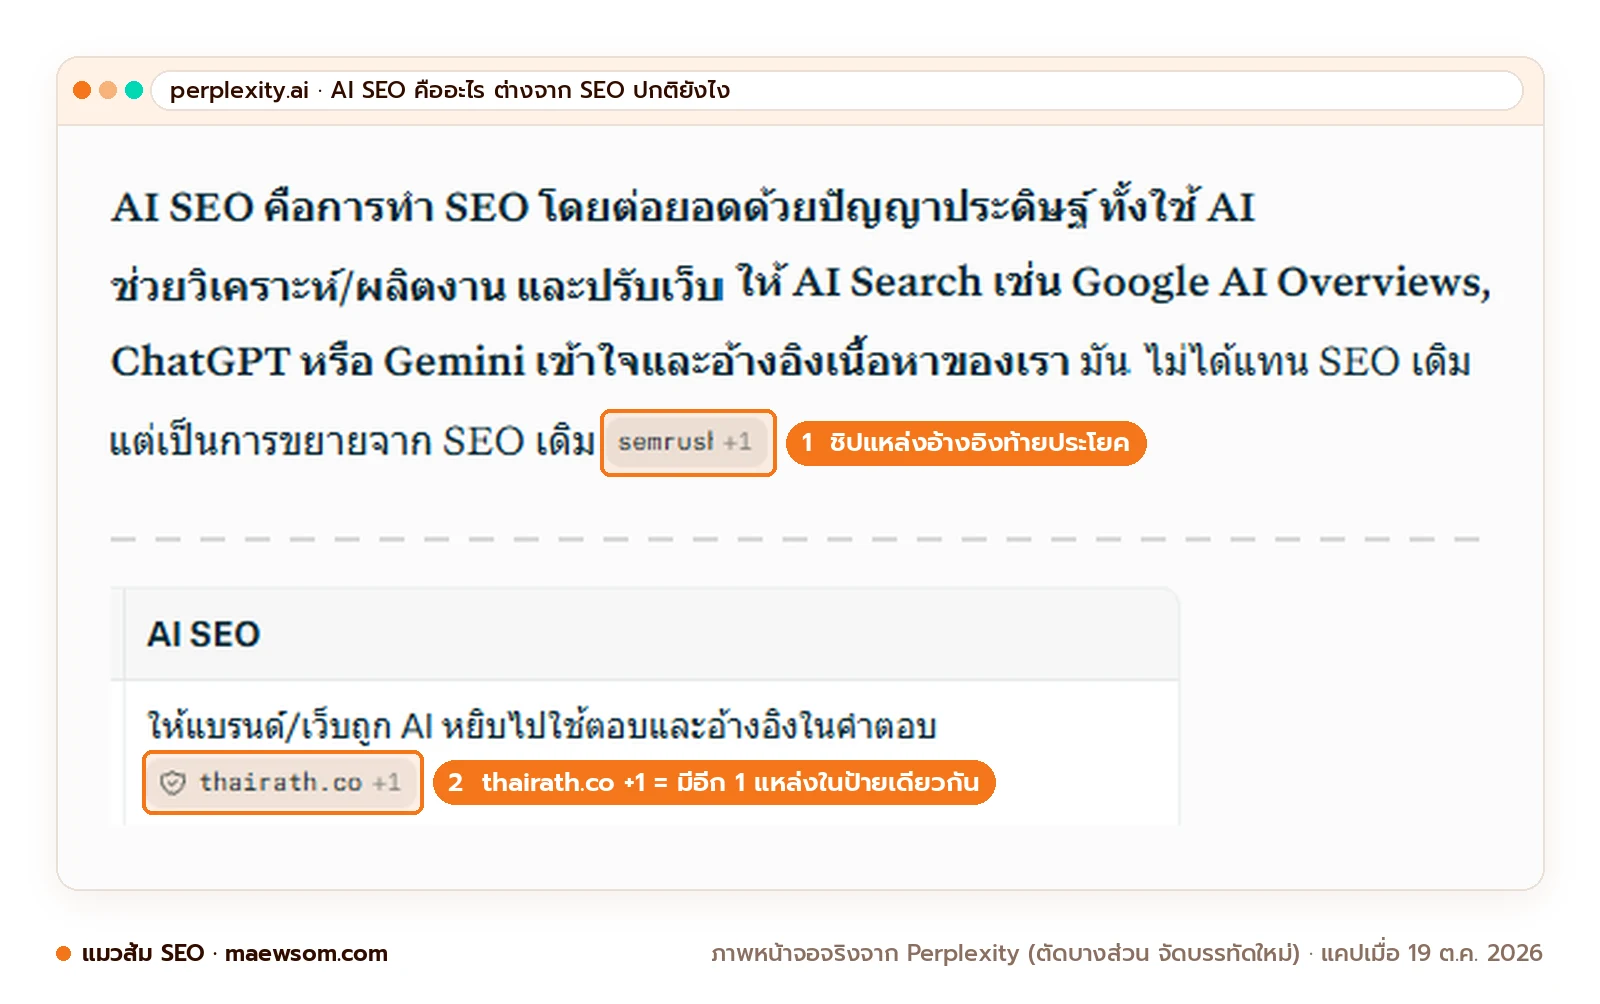
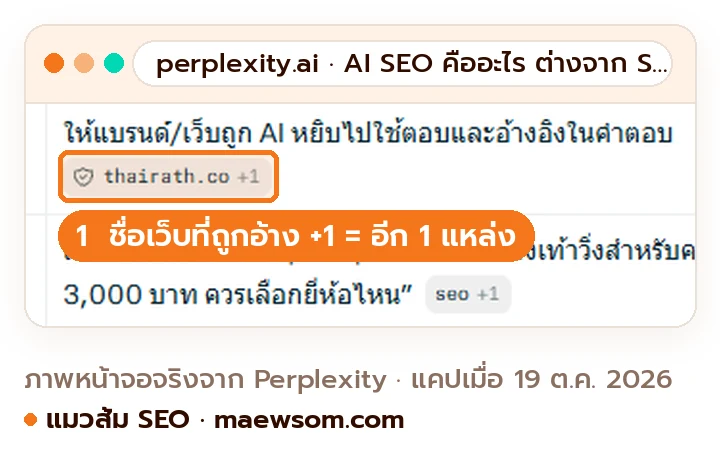
Perplexity ค้นเว็บสดๆ ตอนที่ผู้ใช้ถาม ใช้โมเดลภาษาตีความว่าคนถามอยากรู้อะไร แล้วรวบรวมข้อมูลจากหลายแหล่งมาเป็นคำตอบเดียว ทุกคำตอบมีป้ายแหล่งอ้างอิงต่อท้ายประโยค ในภาพหน้าจอด้านล่างเป็นชิปชื่อเว็บ เช่น “thairath.co +1” ตัว +1 แปลว่ามีอีก 1 แหล่งรวมอยู่ในป้ายเดียวกัน กดแล้วลิงก์กลับไปหาต้นทาง และเปิดดูรายการแหล่งทั้งหมดของคำตอบได้ (ชื่อเมนูและหน้าตาเปลี่ยนไปตามเวอร์ชันแอป) นึกภาพรายงานที่ครูบังคับใส่บรรณานุกรมทุกย่อหน้า เป้าหมายของคุณคือได้ชื่อไปอยู่ในบรรณานุกรมนั้น
ต่างจาก ChatGPT ที่บางคำถามตอบจากความรู้ในหัวของโมเดลเลย ไม่ได้ออกไปค้นเว็บ หน้า Help Center ของ Perplexity เขียนว่าเนื้อหาถูกดึงจากเว็บแบบเรียลไทม์ตอนผู้ใช้ถาม เอกสารยืนยันแค่นี้ ส่วนข้ออนุมานของแมวส้มในบทความนี้มี 2 ข้อ คือหน้าที่ข้อมูลสดได้เปรียบ และย่อหน้าที่ตอบได้ในตัวเองได้เปรียบ บอกตรงๆ ว่ายังไม่เจองานวัดอิสระที่ยืนยันเรื่องนี้
Perplexity มีการค้น 2 ระดับ และสองระดับนี้ใช้จำนวนแหล่งต่างกันมาก หน้า “What is Pro Search?” ใน Help Center มีตารางเทียบแบบย่อว่า standard search ตอบเร็ว ใช้ 1-2 แหล่ง เหมาะกับคำถามข้อเท็จจริงสั้นๆ ส่วน Pro Search ค้นหลายรอบ ดึงจากบทความ งานวิชาการ ฟอรัม และวิดีโอ แล้วสรุปจากแหล่งหลายสิบแหล่ง ตัวเลขนี้เป็นภาพรวม ของจริงอาจต่างไป ให้นับจากรายการแหล่งของคำตอบจริงเอง
เทียบกับการถามเรื่องผลไม้ในตลาดสด standard search เหมือนถามแม่ค้าแผงเดียวว่าวันนี้มะม่วงกิโลละเท่าไร ได้คำตอบไว ส่วน Pro Search เหมือนส่งเพื่อนเดินสำรวจทั้งตลาด ถามหลายแผง แล้วกลับมาสรุปว่าแผงไหนถูก แผงไหนหวาน ที่นั่งในบรรณานุกรมของโหมด Pro จึงมีมากกว่าหลายเท่า ใครอยากเข้าใจภาพใหญ่ว่า AI Search ค้นแล้วเรียบเรียงคำตอบยังไง แมวส้มเล่าไว้ที่ AI Search ทำงานยังไง
ข้างในระบบ index ของ Perplexity
index คือสมุดสารบัญยักษ์ที่เครื่องมือค้นหาจดไว้ว่าหน้าไหนพูดเรื่องอะไร ตอนเปิดตัว Search API เมื่อ 25 กันยายน 2025 Perplexity เล่าว่า index ของตัวเองครอบคลุม “หลายแสนล้านหน้าเว็บ” รับคำขออัปเดตหลายหมื่นครั้งต่อวินาที และหั่นเอกสารเป็นชิ้นย่อยแล้วให้คะแนนความเกี่ยวข้องกับคำค้นทีละชิ้น ตัวเลขเหล่านี้เป็นคำบอกเล่าของ Perplexity เอง ยังไม่มีการวัดอิสระ
เรื่องให้คะแนนทีละชิ้นนี่แหละที่แมวส้มอยากให้คนทำคอนเทนต์จำให้ขึ้นใจ ถ้าระบบดูทีละชิ้น ย่อหน้าที่ต้องอ่านย่อหน้าก่อนถึงจะเข้าใจจะเสียเปรียบ ส่วนย่อหน้าที่ตัดออกมาเดี่ยวๆ แล้วยังตอบคำถามได้จะได้เปรียบ เหมือนการ์ดคำศัพท์ที่หยิบใบไหนขึ้นมาก็อ่านรู้เรื่อง ข้อนี้เป็นการอนุมานจากคำอธิบาย Search API ไม่ใช่กฎที่ Perplexity ประกาศ
ลองนึกถึงหน้าคลินิกความงามสมมติที่มีย่อหน้าหนึ่งเขียนว่า “ราคานี้รวมยาชาและค่าแพทย์แล้ว” ถ้าย่อหน้านี้ถูกตัดออกมาเดี่ยวๆ ไม่มีใครรู้เลยว่า “ราคานี้” คือบริการอะไร เขียนใหม่เป็น “ราคาฉีดฟิลเลอร์ใต้ตาของคลินิกรวมยาชาและค่าแพทย์แล้ว” ชิ้นนี้ก็ยืนได้ด้วยตัวเอง แก้แค่ไม่กี่คำ แต่ต่างกันเยอะมาก
PerplexityBot vs Perplexity-User ต่างกันยังไง
Perplexity มีบอท 2 ตัว PerplexityBot เก็บหน้าเว็บไปแสดงและลิงก์ในผลค้นหาของ Perplexity ส่วน Perplexity-User เข้าหน้าเว็บตอนผู้ใช้ถามแล้วระบบต้องไปอ่านหน้านั้นเพื่อตอบ ทั้งสองตัว Perplexity ระบุว่าไม่ได้ใช้เก็บข้อมูลเทรนโมเดล
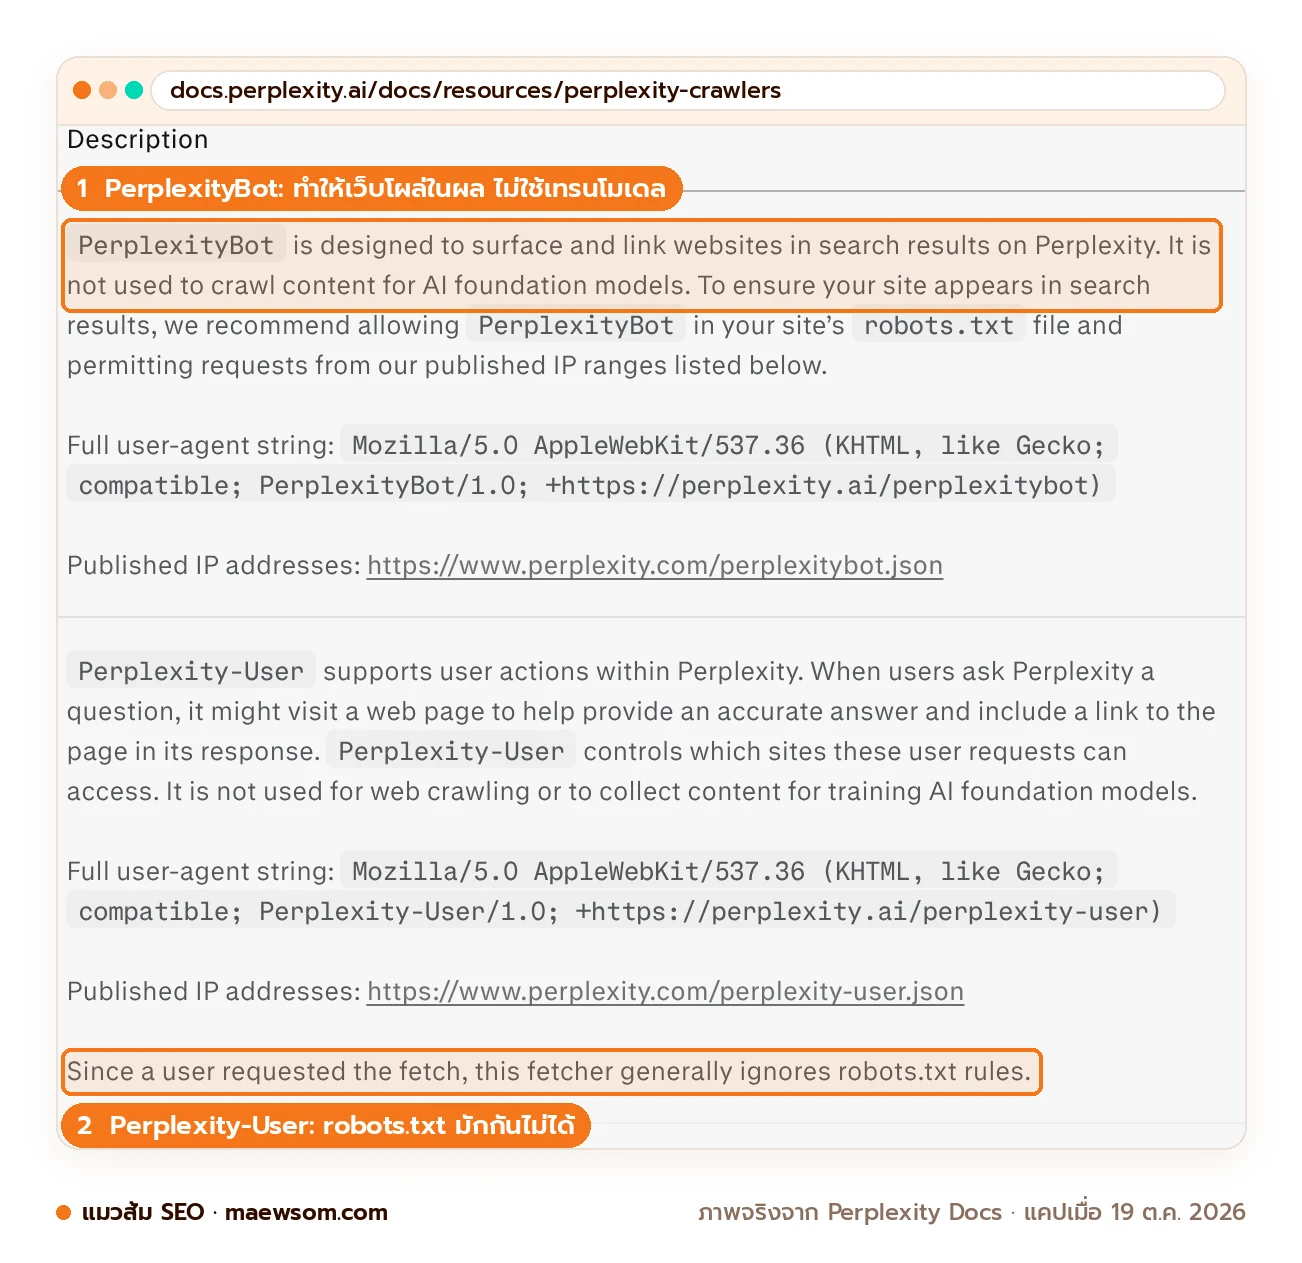
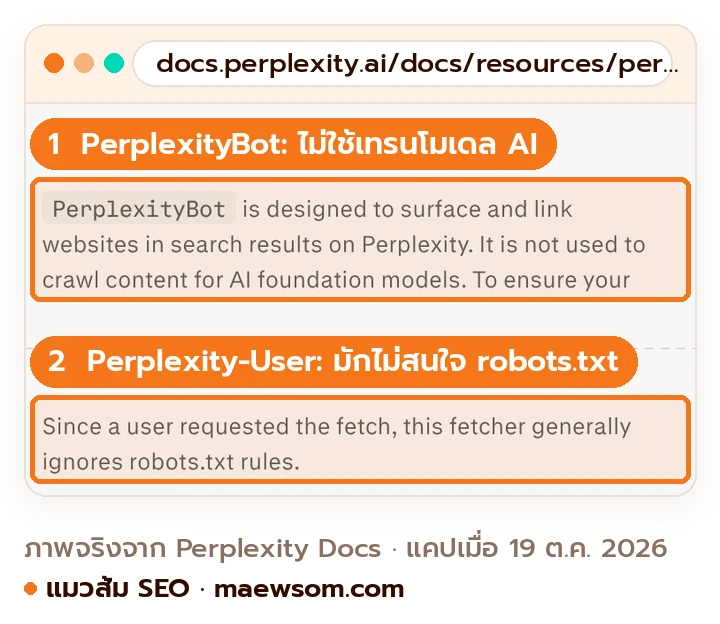
ภาพง่ายๆ คือ PerplexityBot เป็นคนสำรวจร้านที่อ่านป้าย “ห้ามสำรวจ” หน้าร้านแล้วยอมกลับ ส่วน Perplexity-User เป็นคนที่ลูกค้าฝากให้เดินเข้ามาดูของแทน ป้ายแผ่นเดิมจึงกันได้แค่คนแรก ป้ายที่ว่านี้ก็คือไฟล์ robots.txt นั่นเอง
| หัวข้อ | PerplexityBot | Perplexity-User |
|---|---|---|
| หน้าที่ | ทำให้เว็บถูกค้นเจอและลิงก์ในผลของ Perplexity | เข้าหน้าเว็บตามคำขอของผู้ใช้ เพื่อใช้ตอบและลิงก์ในคำตอบ |
| ใช้เทรนโมเดล | ไม่ (ตามเอกสาร Perplexity) | ไม่ (ตามเอกสาร Perplexity) |
| robots.txt | ควบคุมได้ด้วย robots.txt ตามเอกสาร (การแก้มีผลภายใน 24 ชม.) | โดยทั่วไปไม่สนใจ เพราะผู้ใช้เป็นคนสั่ง |
| ไฟล์ IP | perplexity.com/perplexitybot.json |
perplexity.com/perplexity-user.json |
| ถ้าบล็อก | เว็บมีโอกาสหายจากผลค้นหาของ Perplexity | ทำได้ที่ไฟร์วอลล์ ไม่ใช่ robots.txt |
user-agent คือบัตรชื่อที่บอทห้อยคอมาตอนเข้าเว็บ บัตรของ PerplexityBot ตามเอกสารคือ Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot) ส่วนโค้ดข้างล่างเป็นตัวอย่าง robots.txt ที่เปิดให้ทั้งเว็บ แต่กันโซนหลังบ้านไว้
Perplexity ระบุว่าการแก้ robots.txt อาจใช้เวลาถึง 24 ชั่วโมงกว่าจะมีผล และแนะนำให้ตั้ง WAF (ยามหน้าหมู่บ้านของเว็บ) แบบ Allow โดยใช้เงื่อนไข AND คือ user-agent มีคำว่า PerplexityBot หรือ Perplexity-User และ IP (บ้านเลขที่ของเครื่องที่มาเคาะ) อยู่ในช่วงที่ประกาศ ยามที่เช็กทั้งบัตรชื่อและบ้านเลขที่ กันคนแอบห้อยบัตรปลอมได้ดีกว่ามาก
ถ้าใช้ Cloudflare ให้เช็กด้วยว่าการตั้งค่าบล็อก AI bot ไม่ได้ปิด PerplexityBot ไปโดยไม่รู้ตัว ตรงนี้พลาดกันบ่อยและเงียบมาก เทียบการตั้งค่าบอทของทุกค่ายได้ที่ AI Crawler คืออะไร ตั้ง robots.txt ยังไง และเช็กว่าบอทอ่านเนื้อหาเว็บคุณออกจริงไหมที่ AI Crawlability
เทคนิคทำ Perplexity SEO ให้ถูกอ้างอิงบ่อยขึ้น
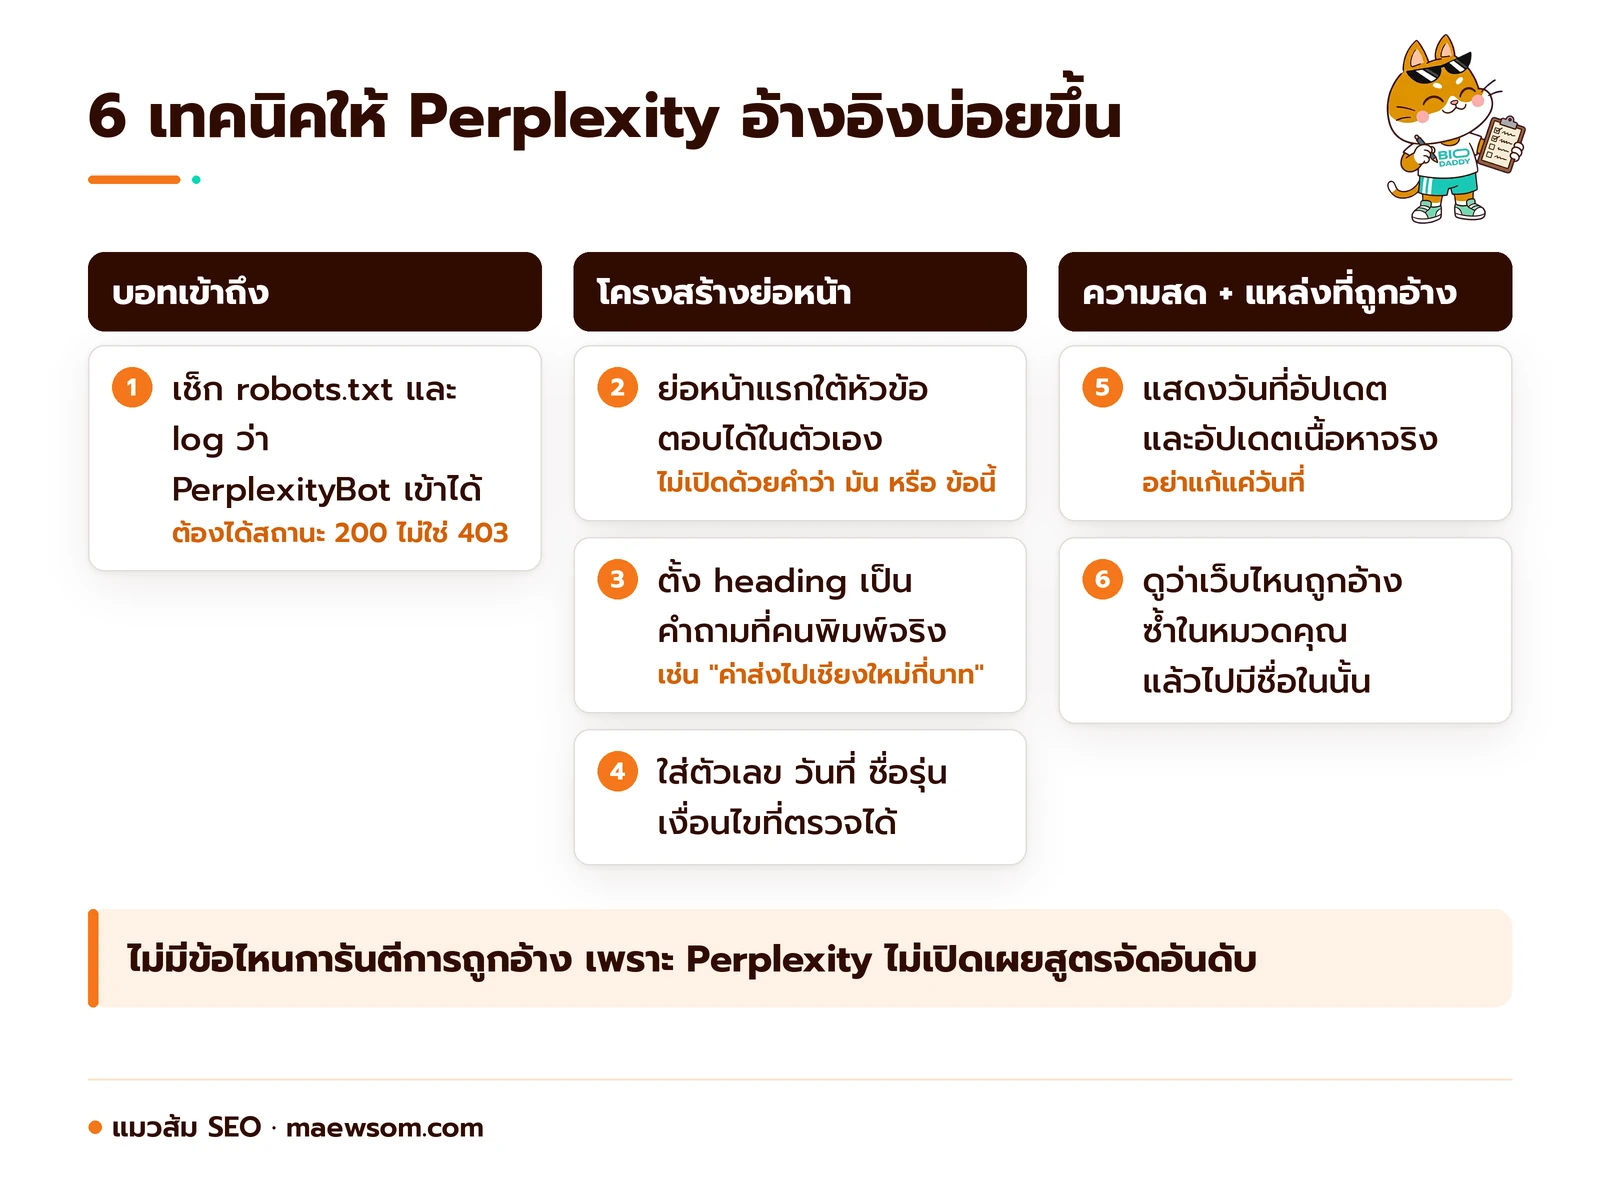
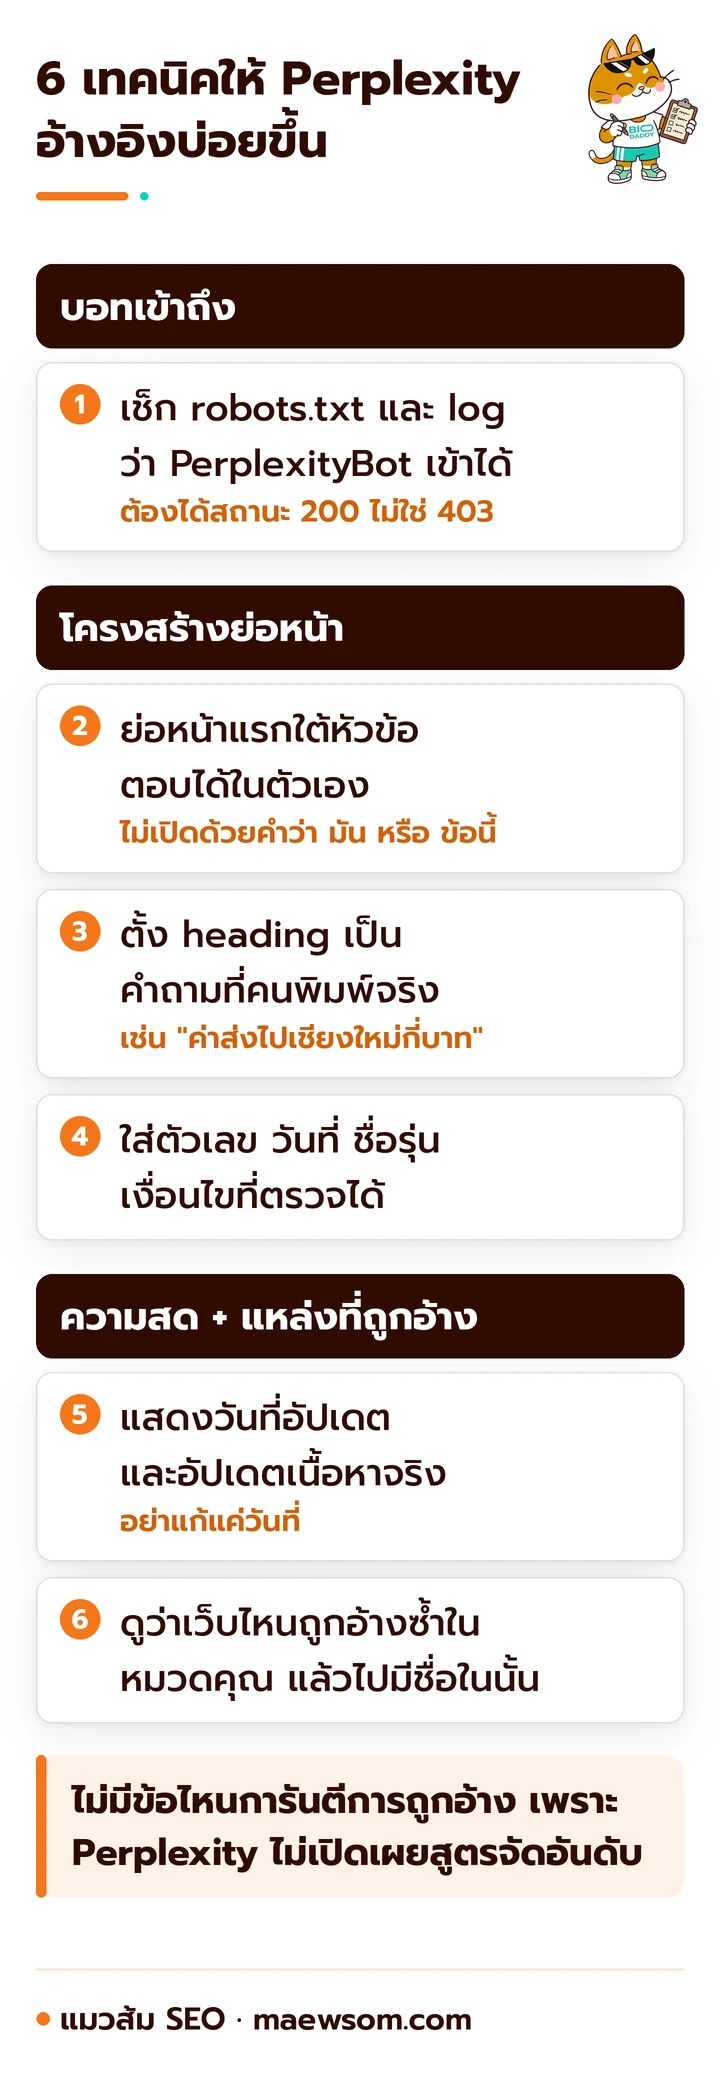
เทคนิค Perplexity SEO ที่มีเหตุผลรองรับ แบ่งเป็นเรื่องให้บอทเข้าถึง เรื่องโครงสร้างย่อหน้า และเรื่องความสด ทำตามลำดับนี้ได้เลย แต่ขอพูดตรงๆ ว่าไม่มีข้อไหนการันตีว่าจะถูกอ้าง เพราะ Perplexity ไม่ได้เปิดเผยสูตรจัดอันดับ
- ตรวจทางเข้า เปิด
yourdomain.com/robots.txtดูว่าไม่มี Disallow ใส่ PerplexityBot แล้วดู log ของเซิร์ฟเวอร์หรือ Cloudflare ว่าคำขอจาก PerplexityBot ได้สถานะ 200 (เข้าได้) ไม่ใช่ 403 (โดนปิดประตูใส่) - ให้ทุกย่อหน้าแรกใต้หัวข้อตอบได้ในตัวเอง ใส่ชื่อเรื่องในประโยค ไม่ขึ้นต้นด้วย “มัน” “ข้อนี้” ที่ต้องอ่านย่อหน้าก่อนถึงจะรู้ว่าหมายถึงอะไร
- ตั้ง heading เป็นคำถามที่คนพิมพ์จริง เช่น “ค่าส่งไปเชียงใหม่กี่บาท” แทน “ข้อมูลการจัดส่ง” heading ที่ตรงคำถามช่วยให้ชิ้นเนื้อหาใต้มันจับคู่กับคำค้นได้ง่าย เหมือนป้ายหน้าชั้นในร้านสะดวกซื้อที่บอกชัดว่าชั้นนี้ขายอะไร
- ใส่ข้อมูลที่ตรวจสอบได้ ตัวเลข วันที่ ชื่อรุ่น สเปก เงื่อนไข ข้อความเจาะจงมีโอกาสถูกยกไปเป็นเชิงอรรถมากกว่าคำบรรยายลอยๆ
- แสดงวันที่อัปเดตและอัปเดตจริง หน้าราคา หน้ารีวิวสินค้าประจำปี หน้าเปรียบเทียบ ให้ทบทวนตามรอบ แล้วแก้วันที่เมื่อเนื้อหาเปลี่ยนจริง อย่าแก้แค่วันที่ เพราะนั่นคือการหลอกตัวเอง
- ไปอยู่ในแหล่งที่ Perplexity อ้างในหมวดคุณ เปิดรายการแหล่งอ้างอิงของคำถามสำคัญ จดว่าเว็บไหนโผล่ซ้ำ แล้วหาทางมีชื่อในนั้น เช่น ให้ข้อมูลกับบทความเปรียบเทียบ หรือตอบคำถามในกระทู้ที่ถูกอ้าง ด้วยข้อมูลจริงและเปิดเผยว่าคุณเป็นใคร
มาดูตัวอย่างย่อหน้าก่อนและหลังแก้กันเลย เป็นหน้าสมมติของร้านขายเครื่องกรองน้ำ
ก่อน: มันเป็นรุ่นที่ขายดีที่สุดของเรา ใช้งานง่าย คุ้มค่า เหมาะกับทุกบ้าน
หลัง: เครื่องกรองน้ำรุ่น A ใช้ไส้กรอง 5 ขั้นตอน ควรเปลี่ยนไส้กรองทุก 6 เดือน ไส้กรองชุดใหม่ราคา 1,290 บาท เหมาะกับบ้านที่ใช้น้ำประปา ไม่เหมาะกับน้ำบาดาลที่มีหินปูนสูง
ย่อหน้าหลังตอบคำถาม “ต้องเปลี่ยนไส้กรองบ่อยแค่ไหน” “ใช้กับน้ำบาดาลได้ไหม” ได้ทันทีแม้ถูกตัดออกมาชิ้นเดียว (ตัวเลขในตัวอย่างเป็นตัวเลขสมมติ) ดูหลักการเต็มที่ 9 วิธีทำให้ AI อ้างอิงเว็บของคุณ และ AEO คืออะไร
Perplexity SEO ต่างจาก ChatGPT SEO ตรงไหน
พื้นฐานเหมือนกันเกือบหมด สิ่งที่ต่างคือ Perplexity ค้นเว็บแทบทุกคำตอบและโชว์แหล่งชัดกว่า ส่วน ChatGPT มีทั้งคำตอบจากความรู้ในโมเดลและคำตอบจากการค้น ชื่อเสียงของแบรนด์บนเว็บจึงมีผลกับ ChatGPT มากกว่า
| หัวข้อ | Perplexity | ChatGPT |
|---|---|---|
| บอทที่ต้องเปิดเพื่อโผล่ในผล | PerplexityBot | OAI-SearchBot |
| แหล่งข้อมูลค้นหา | index ของตัวเอง (ตามที่ Perplexity ประกาศ) | ผู้ให้บริการค้นหาภายนอก รวมถึง Bing (ตาม OpenAI Help Center) |
| การแสดงแหล่งอ้างอิง | ป้ายแหล่งอ้างอิงท้ายประโยค และรายการแหล่งทั้งหมดของคำตอบ | ลิงก์ในเนื้อความและส่วน Sources เฉพาะคำตอบที่ค้นเว็บ |
| ช่องใน GA4 | ยังตกไปที่ Referral (source perplexity.ai) | ช่อง AI Assistant ในตัว (chatgpt.com / ai-assistant) |
รายละเอียดฝั่ง ChatGPT ทั้งเรื่องบอท 3 ตัวและการทำให้แบรนด์ถูกแนะนำ อ่านได้ที่ ChatGPT SEO ทำยังไงให้ ChatGPT แนะนำเว็บและแบรนด์ของคุณ
วัดผล Perplexity SEO ยังไง
วัดผล Perplexity ได้ 2 ทาง คือนับว่าเว็บคุณอยู่ในเชิงอรรถของคำถามสำคัญกี่ครั้ง และดู traffic ที่มาจาก perplexity.ai ใน GA4 ทางแรกบอกการมองเห็น ทางที่สองบอกว่าการมองเห็นนั้นพาคนมาจริงแค่ไหน เหมือนร้านที่ถูกเอ่ยชื่อในรายการทีวี กับจำนวนคนที่เดินเข้าร้านจริงหลังรายการออกอากาศ
เช็กเชิงอรรถ: สิ่งที่ต้องทำเพิ่มจากวิธีของ ChatGPT
โครงหลักของการเช็กใช้แบบเดียวกับ prompt protocol ในบทความ ChatGPT SEO คือชุดคำถามเดิม ยิงซ้ำ จดลงตาราง ทำทุกเดือน ฝั่ง Perplexity ให้เพิ่มอีก 3 อย่างตามข้างล่างนี้
- ล็อกระดับการค้น ยิงคำถามเดียวกันทั้งใน standard search และ Pro Search แล้วจดแยกกัน เพราะ Help Center บอกว่าสองโหมดใช้จำนวนแหล่งต่างกันมาก นับจำนวนเว็บในรายการแหล่งของแต่ละโหมดเอง ถ้าเว็บคุณติดเฉพาะ Pro ก็อาจเป็นสัญญาณว่าหน้านั้นยังไม่ใช่คำตอบอันดับต้นของคำถามนั้น
- จดหมายเลขเชิงอรรถและประโยคที่ถูกยก คลิกตัวเลขแล้วดูว่า Perplexity ดึงย่อหน้าไหนจากหน้าคุณ ย่อหน้าที่ถูกยกซ้ำคือแม่แบบที่ควรใช้กับหน้าอื่น
- นับเว็บในรายการแหล่งทั้งหมด ไม่ใช่แค่ตัวที่ถูกอ้างในเนื้อความ เว็บที่อยู่ในรายการแหล่งแต่ไม่ถูกอ้างคือเว็บที่ถูกอ่านแล้ว แต่แพ้ชิ้นเนื้อหาของคนอื่น เจ็บแต่ได้บทเรียน
ดู log ว่าบอทของ Perplexity เข้ามาจริงไหม
log ของเซิร์ฟเวอร์คือสมุดเซ็นชื่อเข้าออกของเว็บ บอกได้ว่า Perplexity มาอ่านเว็บคุณบ่อยแค่ไหน และได้สถานะอะไรกลับไป ถ้าใช้ Apache หรือ Nginx ที่เก็บ log แบบมาตรฐาน ลองคำสั่งข้างล่างนี้ได้เลย
ผลที่ได้คือจำนวนคำขอแยกตาม status code (รหัสผลลัพธ์ที่เว็บตอบกลับ) ถ้าเห็น 403 หรือ 429 เยอะ แปลว่าไฟร์วอลล์หรือ rate limit (เพดานจำนวนครั้งที่ยอมให้เข้า) กำลังกันบอทอยู่ ถ้า PerplexityBot แทบไม่มาแต่ Perplexity-User มาบ่อย แปลว่ามีผู้ใช้ถามถึงหน้าคุณ แต่ index อาจมีหน้าคุณน้อย ให้ตรวจ robots.txt กับ WAF ซ้ำ แล้วเทียบ IP กับไฟล์ JSON ของ Perplexity เพราะ user-agent ปลอมกันได้
ทำไม Perplexity ไม่ขึ้นในช่อง AI Assistant ของ GA4
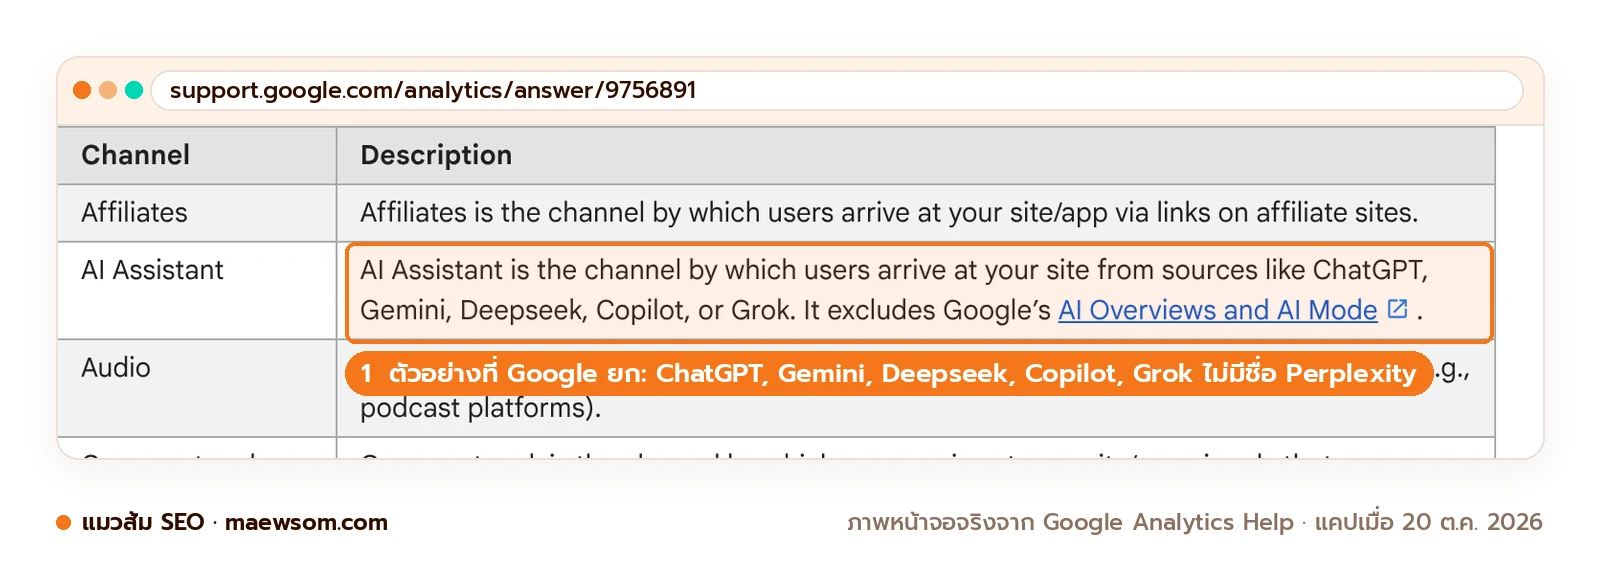
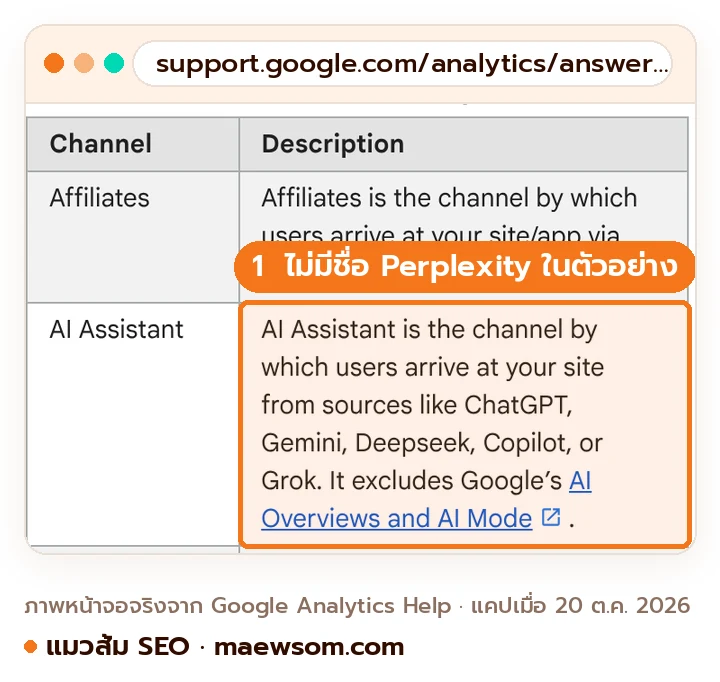
GA4 เพิ่มช่อง AI Assistant ใน Default Channel Group (ลิ้นชักแยกประเภทว่าคนมาจากไหน) เมื่อ 13 พฤษภาคม 2026 โดยตั้ง medium เป็น ai-assistant ให้เองเมื่อ referrer (ป้ายบอกว่าคลิกมาจากเว็บไหน) ตรงกับรายชื่อผู้ช่วย AI ที่ Google รู้จัก ในหน้าช่วยเหลือ Google ยกตัวอย่าง ChatGPT, Gemini, Deepseek, Copilot และ Grok ส่วน Search Engine Journal รายงานเมื่อ 15 กรกฎาคม 2026 ว่า Perplexity ยังไม่อยู่ในรายชื่อนั้น traffic จาก Perplexity จึงยังตกไปที่ Referral ใครดูแค่ช่อง AI Assistant จะเห็น ChatGPT แต่ไม่เห็น Perplexity เลย แล้วอาจสรุปผิดว่า Perplexity ไม่เคยส่งใครมา
ณ เวลาที่เขียน แมวส้มไม่พบเอกสารของ Perplexity ที่บอกว่าใส่ UTM (ป้ายติดตามท้ายลิงก์) ในลิงก์ขาออก การวัดจึงพึ่ง referrer ของเบราว์เซอร์อย่างเดียว ทางแก้คือสร้าง custom channel group เอง ทำตาม 3 ขั้นนี้ได้เลย
- ไปที่ Admin แล้วเลือก Data display ต่อด้วย Channel groups กด Create new channel group (เริ่มจากสำเนาของ default ได้)
- เพิ่ม channel ชื่อ “AI Assistant + Perplexity” เงื่อนไข Source matches regex
^([a-z0-9-]+\.)*perplexity\.ai$หรือ (OR) Medium exactly matchesai-assistant - ลาก channel นี้ขึ้นไปไว้เหนือ Referral แล้วบันทึก GA4 จะใช้กลุ่มใหม่กับรายงานย้อนหลังได้ด้วย
regex คือสูตรจับรูปแบบตัวอักษร และใน GA4 เงื่อนไข matches regex ต้องตรงกับค่าทั้งก้อน สูตรนี้จึงจับได้ทั้ง perplexity.ai และ subdomain อย่าง www.perplexity.ai แต่ไม่ดึงโดเมนอื่นที่แค่มีคำว่า perplexity ส่วนวิธีวัดการมองเห็นใน AI แบบเต็มระบบอยู่ที่ AI Visibility คืออะไร
ความเชื่อเรื่อง Perplexity SEO ที่ควรแก้
ความเข้าใจผิดเรื่อง Perplexity ส่วนใหญ่มาจากการเหมาว่ามันทำงานเหมือน Google หรือ ChatGPT ตารางนี้รวมข้อที่แมวส้มเจอบ่อย พร้อมสิ่งที่เอกสารพูดจริง ใครมาขายสูตรลับ แมวส้มขอยักไหล่แล้วชี้ไปที่คอลัมน์ขวาก่อน
| ความเชื่อ | ที่เอกสารพูดจริง |
|---|---|
| บล็อก PerplexityBot แล้วหายจาก Perplexity แน่นอน | มีโอกาสหายจากผลค้นหา แต่ Perplexity-User ยังดึงหน้าตามคำขอผู้ใช้ได้ และโดยทั่วไปไม่สนใจ robots.txt |
| ต้องเข้าโปรแกรมของ Perplexity หรือ Comet Plus ถึงจะถูกอ้าง | Comet Plus (ส.ค. 2025) เป็นโมเดลแบ่งรายได้ 80% ให้สำนักข่าวที่เข้าร่วม ตามรายงานของ Axios ไม่มีเอกสารบอกว่าช่วยให้ถูกอ้างบ่อยขึ้น |
| ทดสอบใน Pro Search อย่างเดียวพอ | Help Center เทียบแบบย่อว่า standard ใช้ 1-2 แหล่ง Pro ใช้หลายสิบแหล่ง ผลสองแบบจึงต้องจดแยกกัน |
| มีงานวิจัยบอก “ปัจจัยอันดับ 1” ของ Perplexity แล้ว | Perplexity ไม่เคยเปิดเผยน้ำหนักปัจจัย ตัวเลขที่เห็นส่วนใหญ่เป็นงานเชิงสัมพันธ์ของบริษัทขายเครื่องมือ ต้องดูวิธีวัดก่อนเชื่อ |
| ใส่ schema หรือ llms.txt แล้ว Perplexity เลือกมากขึ้น | ยังไม่มีเอกสารของ Perplexity ยืนยัน ณ เวลาที่เขียน |
คำถามที่พบบ่อย
แหล่งอ้างอิง
- Perplexity Crawlers โดย Perplexity (ตรวจเมื่อ ต.ค. 2026)
- Default channel group โดย Google Analytics Help (ตรวจเมื่อ ต.ค. 2026)
- ChatGPT search for Enterprise and Edu โดย OpenAI Help Center (ตรวจเมื่อ ต.ค. 2026)
- What is Pro Search? โดย Perplexity Help Center (อัปเดต ก.ย. 2026)
- What is Perplexity? โดย Perplexity Help Center (อัปเดต ส.ค. 2026)
- How To Track AI Traffic In GA4 Without Undercounting It โดย Search Engine Journal (อัปเดต ก.ค. 2026)
- Introducing the Perplexity Search API โดย Perplexity (อัปเดต ก.ย. 2025)
- Perplexity says it will give publishers 80% cut of new subscription product’s revenue โดย Axios (อัปเดต ส.ค. 2025)
- Agents or bots? Making sense of AI on the open web โดย Perplexity (อัปเดต ส.ค. 2025)
- Perplexity is using stealth, undeclared crawlers to evade website no-crawl directives โดย Cloudflare (อัปเดต ส.ค. 2025)
เขียนโดย
แมวส้มคือมาสคอตของทีม BIQDADDY เอเจนซี SEO และ AISO ในไทย เล่าเรื่อง AI SEO, GEO และ AEO แบบเข้าใจง่าย บทความเขียนด้วยระบบ AI ตามมาตรฐานของทีม ตรวจข้อเท็จจริงกับแหล่งต้นทาง และผ่านผู้ตรวจ AI อิสระก่อนเผยแพร่ ทีม BIQDADDY เป็นผู้ดูแลเว็บและแก้ไขเมื่อมีผู้แจ้งข้อผิดพลาด อ่านนโยบายการเขียน
เรียบเรียงเนื้อหาโดย วุฒิภัทร อุณหะกะ Co-Founder และ COO ของ BIQDADDY
อ่านต่อกับแมวส้ม
Zero-Click Search คืออะไร เมื่อคนค้นแล้วไม่คลิกเข้าเว็บ ต้องวัดผลยังไง
Vector Search คืออะไร การค้นหาด้วยความหมายที่อยู่เบื้องหลัง AI Search
Transformer Model คืออะไร ตัว T ใน GPT ที่ทำให้ AI เข้าใจภาษา