สารบัญ
Entity-based Content คืออะไร เขียนยังไงให้ Google และ AI เข้าใจว่าคุณพูดถึงใคร
สวัสดีครับ วันนี้แมวส้มชวนมาฝึกเขียนแบบที่เครื่องอ่านแล้วไม่งง Entity-based content คือการเขียนเนื้อหาโดยยึด “สิ่งที่มีตัวตน” เป็นแกน เช่น คน แบรนด์ สินค้า สถานที่ หรือแนวคิด แล้วบอกให้ชัดว่าสิ่งนั้นชื่ออะไร เป็นอะไร มีคุณสมบัติอะไร และเกี่ยวกับสิ่งอื่นยังไง แทนการโปรยคำค้นให้ครบจำนวน ผลคือย่อหน้าที่ถูกตัดไปวางที่ไหนก็ยังเข้าใจได้ ซึ่งช่วยทั้งคนอ่าน Google และ AI ที่หยิบข้อความไปตอบ
- เขียนแบบ entity-first คือประโยคแรกของย่อหน้าต้องมีชื่อเต็ม ประเภท และข้อเท็จจริงที่ตรวจได้อย่างน้อย 1 อย่าง
- ล็อกชื่อหลักของแต่ละ entity ไว้ 1 ชื่อ ใช้ซ้ำทั้งบทความ ส่วนคำพ้องใช้ได้กับคำอธิบายทั่วไป ไม่ใช่กับชื่อเฉพาะ
- ชื่อที่ซ้ำกับคนอื่นต้องมี "วลีแยกตัวตน" เช่น ประเภท + พื้นที่ + จุดต่าง แบบเดียวกับคำอธิบายใน Wikidata
- Google ยืนยันใน guide ล่าสุด (10 ก.ค. 2026) ว่าไม่ต้องเขียนแบบพิเศษเพื่อ AI งานนี้จึงเป็นการเขียนให้ชัด ไม่ใช่สูตรลับ
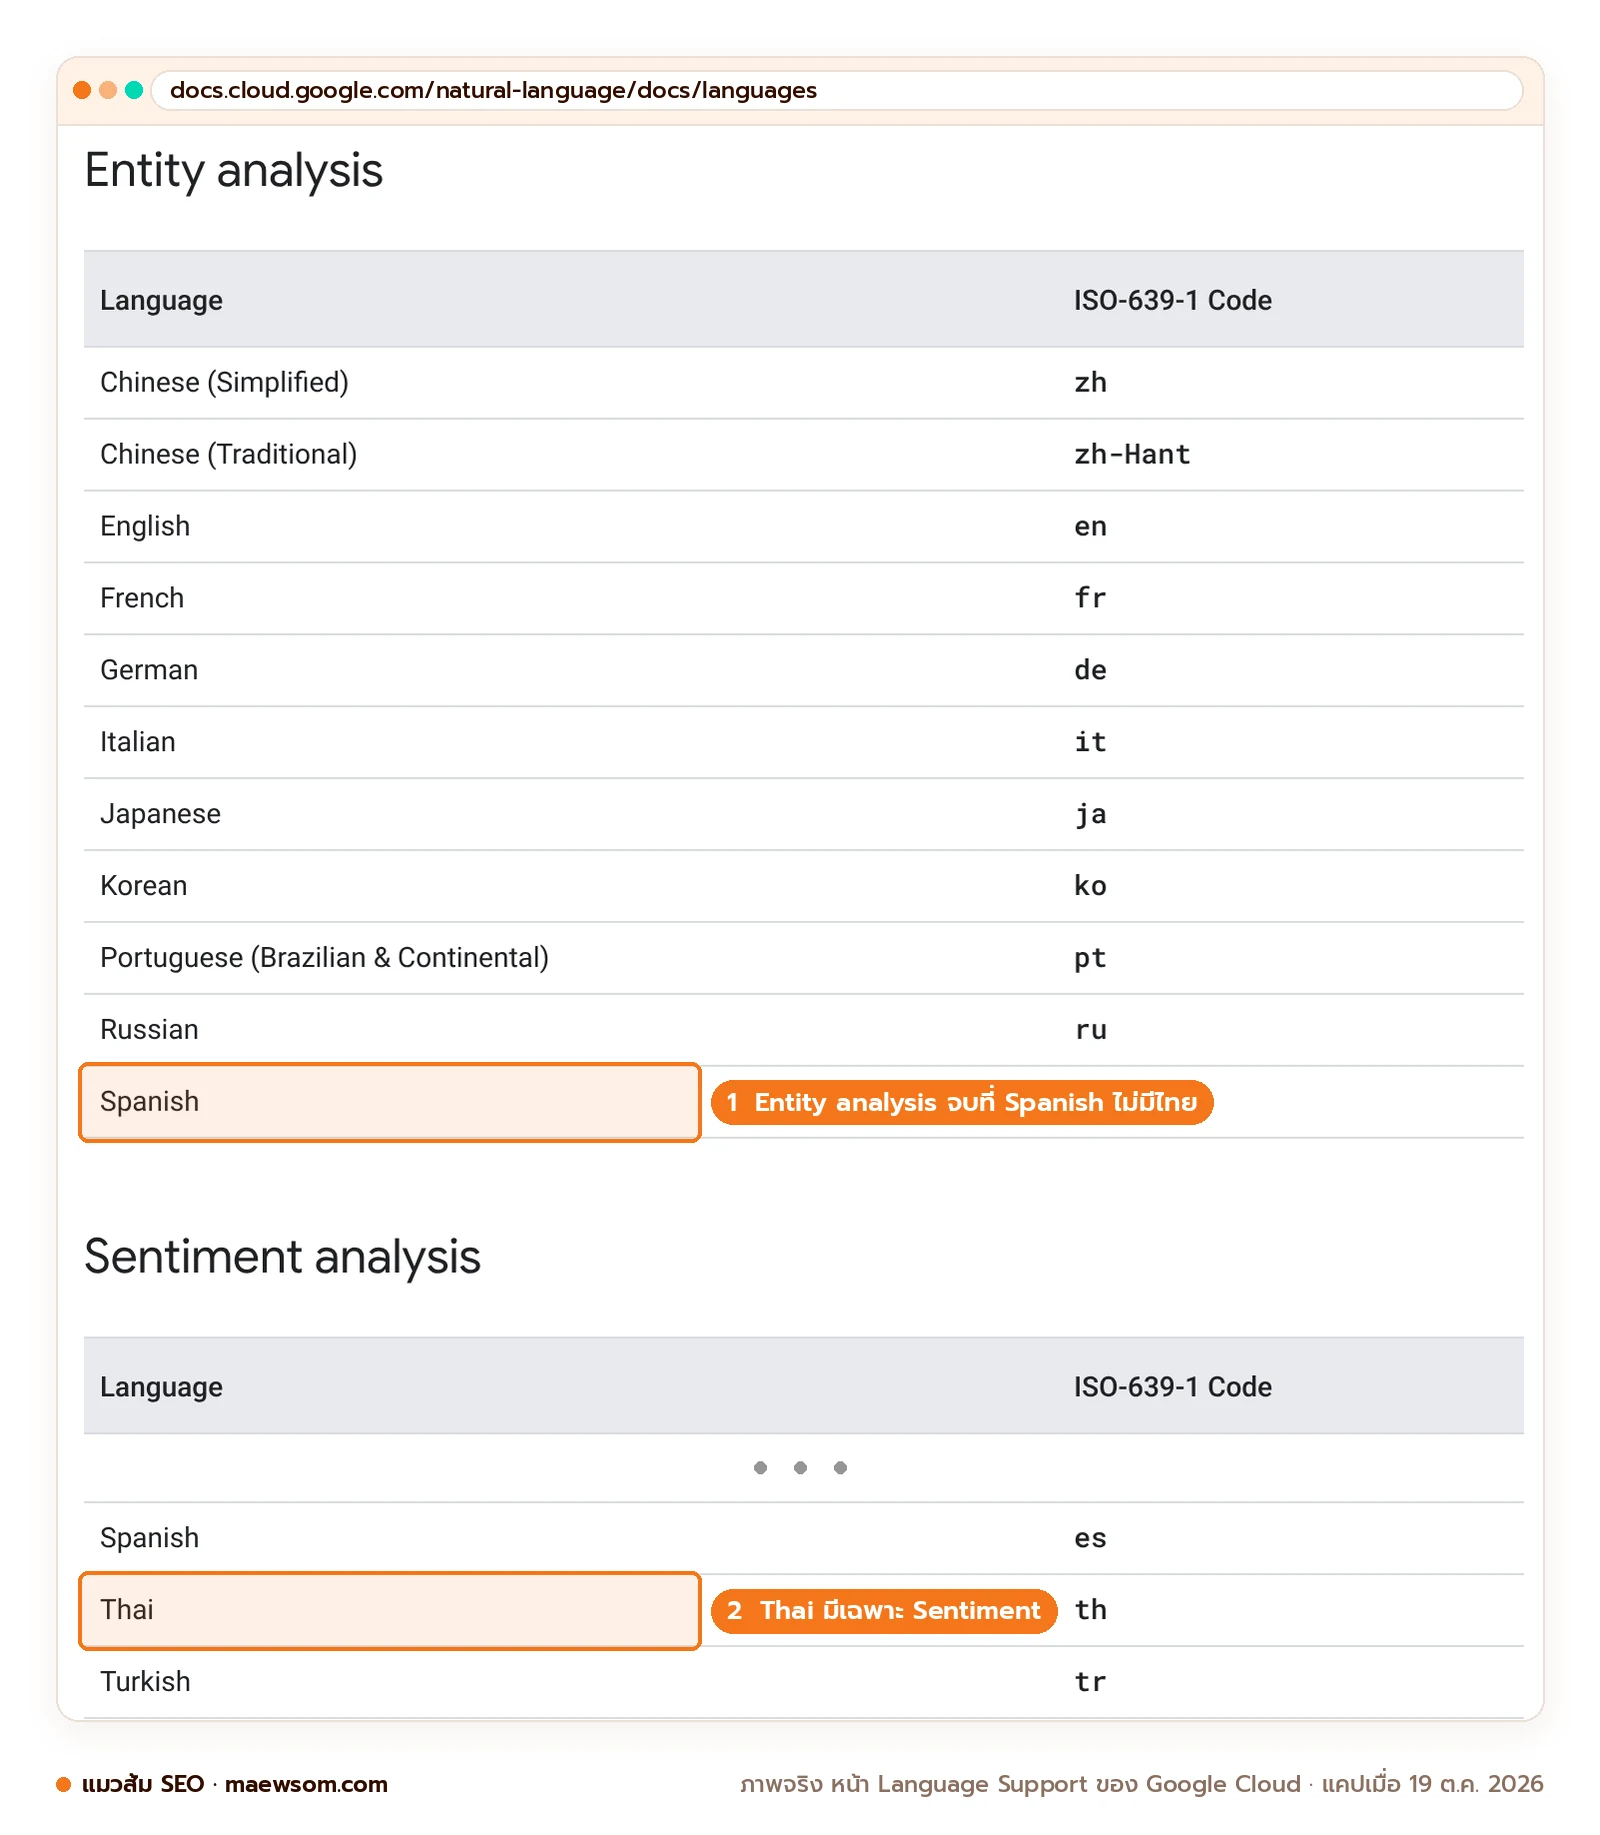
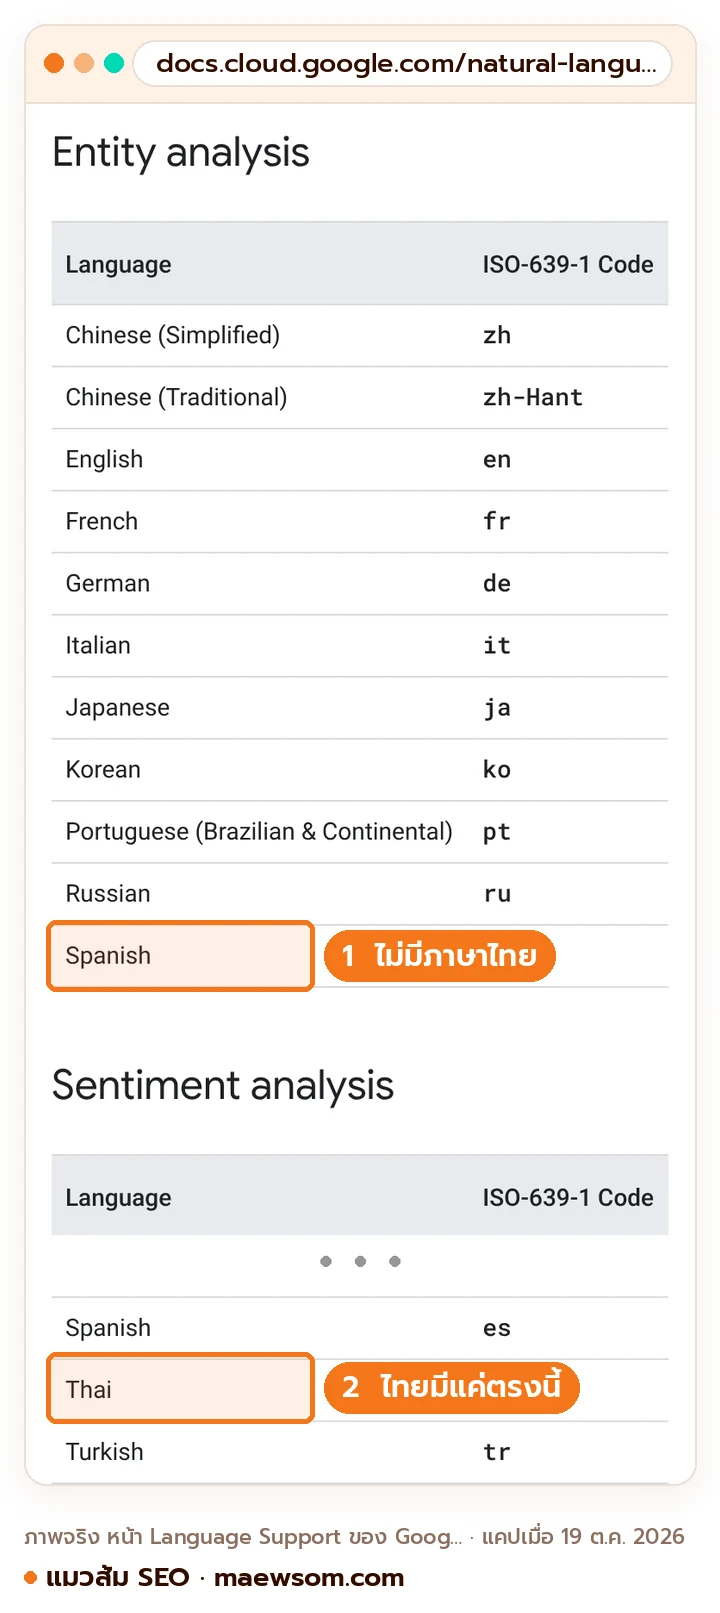
- เช็กด้วย Natural Language API ได้ แต่ฟีเจอร์ Entity analysis ยังไม่รองรับภาษาไทย (ตรวจ ต.ค. 2026)
Entity-based content คืออะไร ต่างจากเขียนตาม keyword ยังไง
Entity-based content คือเนื้อหาที่วางโครงจาก entity และความสัมพันธ์ของมัน ไม่ใช่จากรายการคำค้น คำถามตั้งต้นจึงเปลี่ยนจาก “ต้องใส่คำนี้กี่ครั้ง” เป็น “ย่อหน้านี้พูดถึงใคร หรืออะไร และผู้อ่านต้องรู้อะไรเกี่ยวกับมันบ้าง”
ลองนึกภาพการบอกทางไปร้านข้าวมันไก่ ถ้าพูดว่า “ร้านอร่อยแถวนั้นแหละ” คนฟังไปไม่ถูก แต่ถ้าพูดว่า “ร้านข้าวมันไก่เจ๊หน่อย ปากซอยลาดพร้าว 71 ฝั่งเดียวกับ 7-Eleven เปิด 6 โมงเช้า” คนฟังเดินไปได้เลย ประโยคหลังมีชื่อ ประเภท ที่ตั้ง และจุดอ้างอิง นั่นคือ entity-based content ฉบับปากต่อปาก
ต้องแยกให้ออกนิดหนึ่ง บทความ Entity SEO คืออะไร ทำให้ Google และ AI รู้ว่าแบรนด์คุณคือใคร คือคู่มือหลักเรื่องตั้งตัวตนแบรนด์ เช่น Knowledge Graph, Organization schema และชื่อบน Google Business Profile ส่วนบทความนี้ลงไปที่ระดับประโยคและย่อหน้า ว่าเขียนเนื้อหาแต่ละหน้ายังไงให้ entity ทุกตัวในหน้านั้นชัด ทั้งสินค้า คน สถานที่ และแนวคิดที่คุณอธิบาย
| มุมมอง | เขียนตาม keyword | เขียนแบบ entity-based |
|---|---|---|
| เริ่มคิดจาก | รายการคำค้นและจำนวนครั้ง | รายชื่อ entity ในหน้า และข้อมูลที่ต้องรู้ของแต่ละตัว |
| ประโยคแรกของย่อหน้า | “ทุเรียนอร่อย ส่งไว ราคาดี” | “สวนทุเรียนลุงชัย สวนในอำเภอขลุง จันทบุรี ขายหมอนทองตัดแก่ 85%” |
| สรรพนาม | “ร้านเรา”, “ตัวนี้”, “มัน” กระจายทั้งหน้า | ใช้ชื่อเต็มตอนต้นทุก section แล้วค่อยใช้คำแทน |
| วัดว่าเสร็จ | คำค้นครบตามเครื่องมือ | ตัดย่อหน้าไหนไปวางที่อื่นก็ยังรู้ว่าพูดถึงอะไร |
ทำไม Google และ AI ถึงชอบเนื้อหาที่ entity ชัด
เพราะระบบค้นหาและ AI ต้องรู้ก่อนว่าข้อความพูดถึงอะไร จึงจะหยิบไปตอบคำถามได้ถูกตัว ถ้าย่อหน้าเต็มไปด้วยคำว่า “ที่นี่” หรือ “สินค้าของเรา” เมื่อข้อความถูกแยกออกจากหน้า ความหมายก็หายไปด้วย เหมือนสติกเกอร์ไลน์ที่ส่งมาลอยๆ โดยไม่มีข้อความก่อนหน้า ไม่มีใครรู้ว่าตอบเรื่องอะไร
ฝั่ง Microsoft Bing พูดตรงเรื่องนี้ไว้ในบล็อก Microsoft Advertising เดือนตุลาคม 2025 โดย Krishna Madhavan ผู้จัดการผลิตภัณฑ์ของ Bing ว่าให้เลี่ยงคำกว้างๆ อย่าง “innovative” หรือ “eco” ที่ไม่มีรายละเอียดรองรับ และยกตัวอย่างว่าหน้าสินค้าควรเขียน “42 dB dishwasher designed for open-concept kitchens” แทนแค่ “quiet dishwasher” ประโยคแรกบอกประเภทสินค้า ตัวเลขที่วัดได้ และการใช้งาน ครบทั้ง entity และ attribute
ส่วน Google เขียนไว้ชัดใน คู่มือ generative AI features (อัปเดต 10 ก.ค. 2026) ว่าคุณไม่จำเป็นต้องเขียนในแบบเฉพาะสำหรับ AI search และไม่ต้องหั่นเนื้อหาเป็นชิ้นเล็ก คู่มือนี้ไม่ได้พูดถึงคำว่า entity เลยด้วย แมวส้มจึงขอพูดตรงๆ ว่า entity-based content ไม่ใช่ปุ่มลับให้ติด AI Overviews มันคือการเขียนให้ชัดที่ทั้งคนและเครื่องได้ประโยชน์ ตรงกับคำถามในหน้า helpful content ของ Google ที่ถามว่าเนื้อหาอธิบายหัวข้อได้ครบและมีข้อมูลเกินกว่าเรื่องที่ใครก็รู้ไหม
วิธีเขียนย่อหน้าแบบ entity-first ทำตาม 5 ขั้น
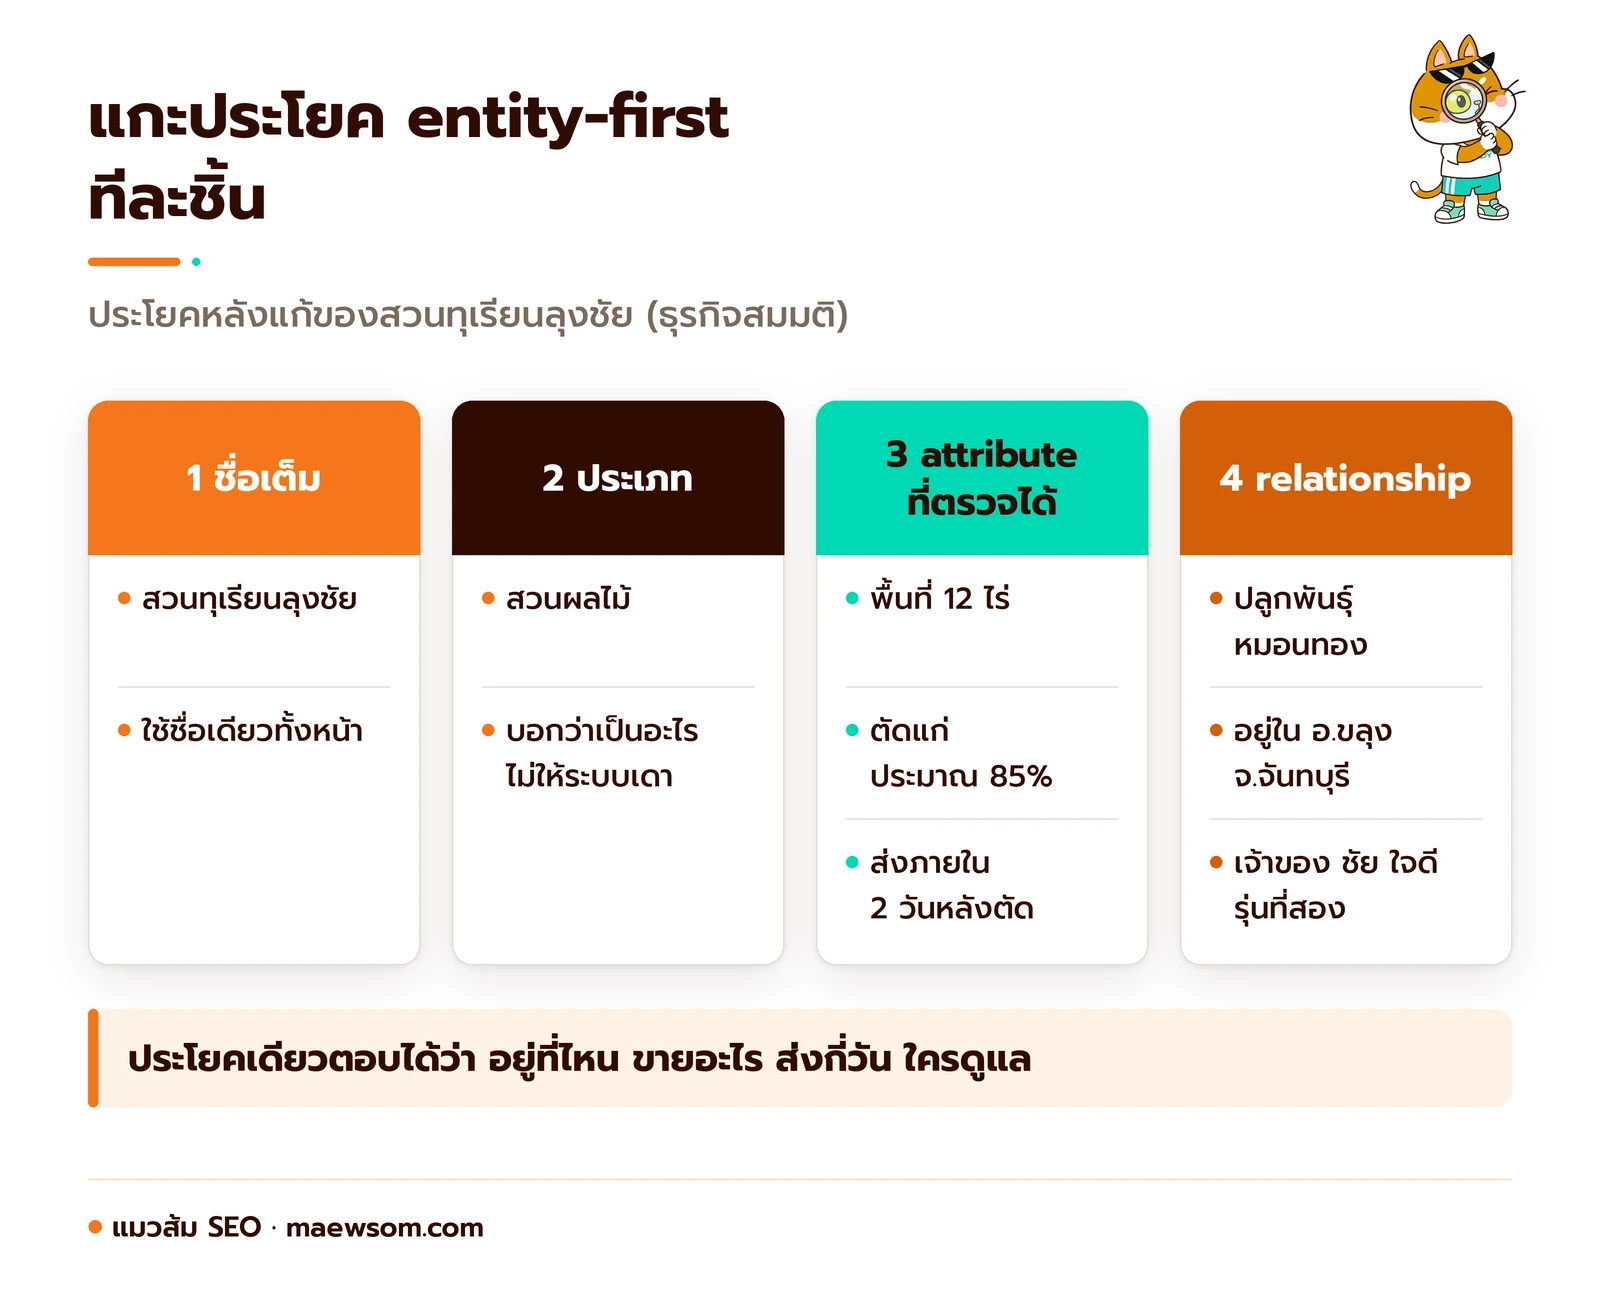
ย่อหน้าแบบ entity-first คือย่อหน้าที่ประโยคแรกบอกครบว่า “สิ่งนี้คือใคร เป็นอะไร โดดเด่นเรื่องไหน” ก่อนจะเล่ารายละเอียด อันนี้แหละที่แมวส้มชอบที่สุด เพราะทำได้ทันทีกับบทความเก่า ไม่ต้องรื้อเว็บ
- เขียนชื่อเต็มก่อน ครั้งแรกในแต่ละ section ใช้ชื่อเต็ม ถ้ามีชื่ออังกฤษให้ใส่ในวงเล็บครั้งเดียว เช่น “สวนทุเรียนลุงชัย (Lung Chai Durian Farm)”
- ตามด้วยประเภท บอกว่าเป็นอะไรในคำไม่กี่คำ เช่น สวนผลไม้ คลินิกทันตกรรม แอปบัญชี ถ้าไม่บอก ระบบต้องเดาจากบริบท
- ใส่ attribute ที่ตรวจได้ 1-3 อย่าง attribute คือคุณสมบัติประจำตัว เหมือนข้อมูลบนบัตรนักเรียน ได้แก่ ตัวเลข ที่ตั้ง ปี ขนาด ราคา ไม่ใช่คำชมตัวเอง
- ผูก relationship กับ entity อื่นที่คนรู้จัก relationship คือเส้นที่โยงสิ่งหนึ่งไปหาอีกสิ่ง เช่น “อยู่ในจังหวัดจันทบุรี”, “ปลูกพันธุ์หมอนทอง”, “ก่อตั้งโดย…” ช่วยให้ระบบวางคุณลงบนแผนที่ความรู้ที่มันมีอยู่แล้ว
- ทดสอบด้วยการตัดแปะ ก๊อปย่อหน้านั้นไปวางในแชตกลุ่มเพื่อนที่ไม่เคยเห็นเว็บคุณ ถ้าเพื่อนถามกลับว่า “ร้านไหนอะ” แปลว่ายังไม่ผ่าน
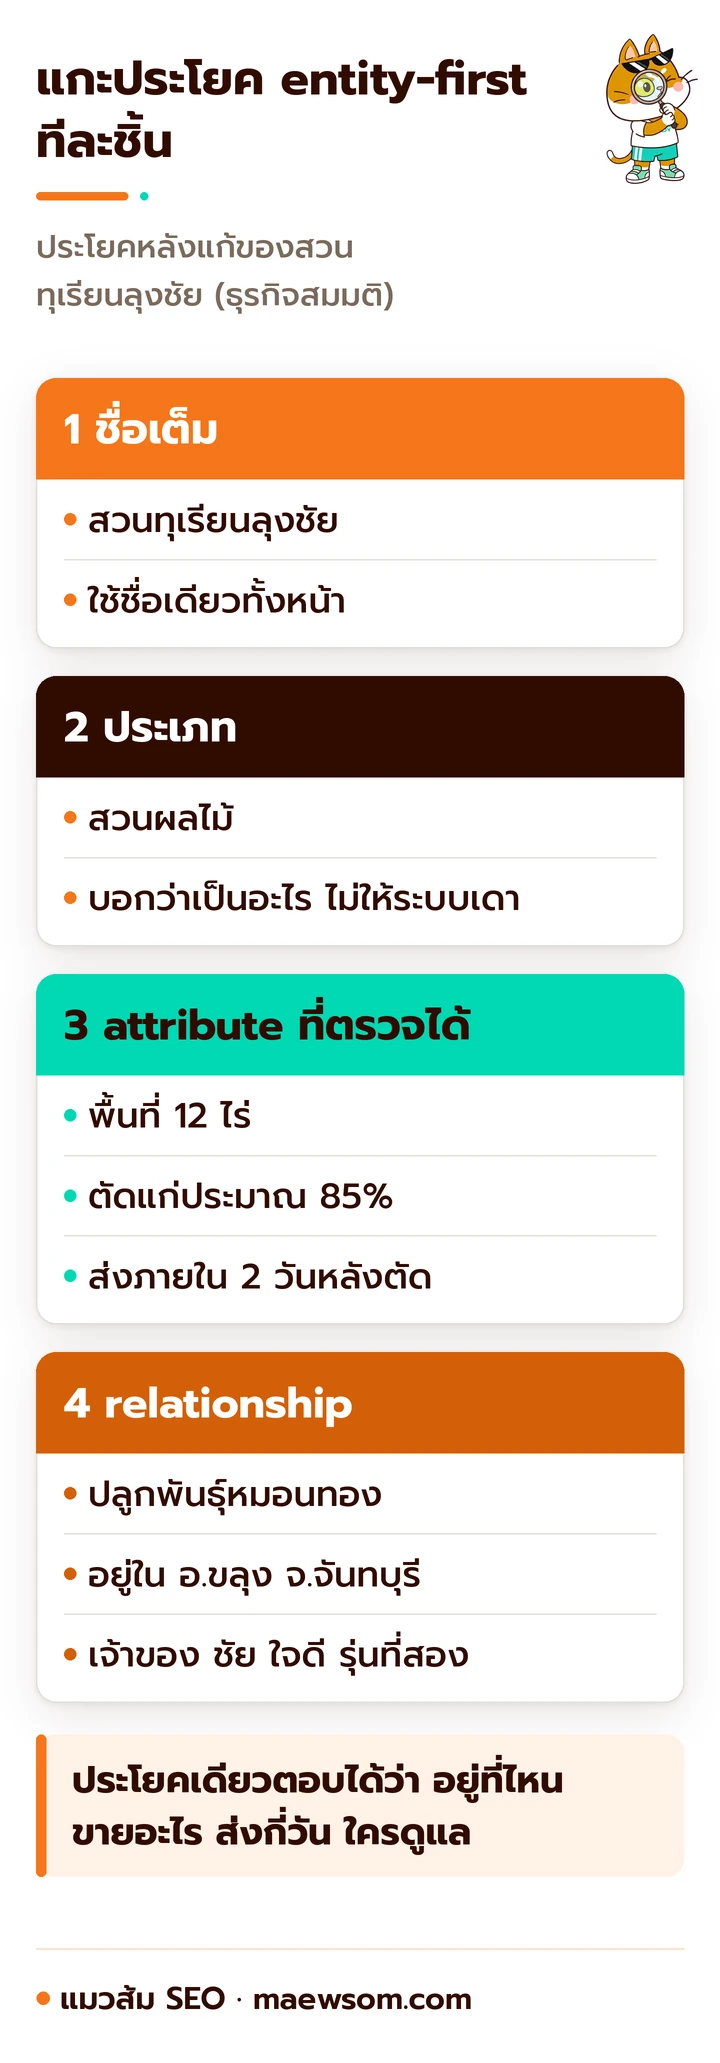
มาดูของจริงกัน นี่คือย่อหน้าเปิดหน้าสินค้าของธุรกิจสมมติ “สวนทุเรียนลุงชัย” ก่อนและหลังแก้
ก่อนแก้: ทุเรียนของเราคัดอย่างดี เนื้อแน่น หวานมัน ส่งตรงจากสวนถึงมือคุณ สดใหม่ทุกลูก สั่งเลยวันนี้
หลังแก้: สวนทุเรียนลุงชัยเป็นสวนผลไม้ในอำเภอขลุง จังหวัดจันทบุรี ปลูกทุเรียนพันธุ์หมอนทองบนพื้นที่ 12 ไร่ ตัดผลเมื่อแก่ประมาณ 85% และส่งแบบแช่เย็นทั่วประเทศภายใน 2 วันหลังตัด ดูแลโดยชัย ใจดี เจ้าของสวนรุ่นที่สอง (ข้อมูลธุรกิจสมมติ)
ฉบับก่อนแก้มีแต่คำชมลอยๆ ซึ่ง AI ยกไปตอบคำถามไหนก็ไม่ได้ ฉบับหลังตอบได้ทันทีหลายคำถาม เช่น “สวนทุเรียนลุงชัยอยู่ที่ไหน”, “ขายพันธุ์อะไร”, “ส่งกี่วันถึง” ทั้งหมดมาจากประโยคเดียว
ตั้งชื่อให้นิ่งทั้งหน้า naming consistency ทำยังไง
Naming consistency คือการเรียก entity เดียวกันด้วยชื่อเดียวกันตลอดทั้งหน้าและทั้งเว็บ ถ้าย่อหน้าหนึ่งเรียก “สวนลุงชัย” อีกย่อหน้าเรียก “LC Durian” และหัวข้อเรียก “ทุเรียนจันท์ของเรา” คนอ่านอาจพอเดาได้ แต่ระบบอาจคิดว่ามีสามร้าน เหมือนเพื่อนที่เปลี่ยนชื่อไลน์ทุกอาทิตย์ จนในกลุ่มไม่มีใครรู้ว่าใครพิมพ์
ใครเคยงงว่า “แล้วคำพ้องความหมายใช้ได้ไหม” ไม่แปลกเลย คำตอบคือใช้ได้ แต่ใช้กับคนละส่วน Google บอกว่าระบบ AI เข้าใจคำพ้องและความหมายโดยรวมได้ ส่วน Bing แนะนำให้ใช้คำพ้องและคำที่เกี่ยวข้องเพื่อช่วยเชื่อมแนวคิด สองคำแนะนำนี้พูดถึงคำอธิบายทั่วไป เช่น “ส่งแบบแช่เย็น” กับ “ส่งรถห้องเย็น” ส่วนชื่อเฉพาะของแบรนด์ คน และสินค้าควรนิ่ง ทำตารางชื่อแบบนี้ไว้ใช้ทั้งทีมได้เลย
| Entity | ชื่อหลัก (ใช้ครั้งแรกทุก section) | ชื่อรองที่ใช้ได้ | เลิกใช้ |
|---|---|---|---|
| แบรนด์ | สวนทุเรียนลุงชัย (Lung Chai Durian Farm) | สวนลุงชัย | LC Durian, ร้านเรา |
| สินค้า | ทุเรียนหมอนทองตัดแก่ 85% | หมอนทองของสวนลุงชัย | ทุเรียนพรีเมียม, ตัวท็อป |
| บุคคล | ชัย ใจดี เจ้าของสวนรุ่นที่สอง | ลุงชัย | เจ้าของ (โดยไม่มีชื่อ) |
| สถานที่ | อำเภอขลุง จังหวัดจันทบุรี | ขลุง จันทบุรี | แถวภาคตะวันออก |
เวลาเรียกชื่อซ้ำบ่อยแล้วรู้สึกว่าประโยคแข็ง ให้ใช้กติกาง่ายๆ คือ ชื่อเต็มครั้งแรกของทุก H2 แล้วค่อยใช้ชื่อรองหรือสรรพนามในประโยคถัดไปของย่อหน้าเดียวกัน ข้ามย่อหน้าเมื่อไรให้กลับมาใช้ชื่ออีกครั้ง
ใส่ attributes และ relationships อะไรบ้าง แยกตามประเภท entity
Attribute ที่ควรใส่คือข้อมูลที่คนถามจริงและตรวจสอบได้ ส่วน relationship ที่ควรใส่คือเส้นโยงไปหา entity ที่ระบบรู้จักอยู่แล้ว เช่น จังหวัด มหาวิทยาลัย มาตรฐาน หรือแบรนด์แม่ ยิ่งโยงไปหาสิ่งที่ชัด entity ของคุณยิ่งชัดตาม เหมือนแนะนำตัวว่า “เป็นน้องสาวของพี่ต้นห้อง 5/2” ทุกคนร้องอ๋อทันที
| ประเภท entity | Attribute ที่ควรมี | Relationship ที่ควรโยง | ตัวอย่างประโยค |
|---|---|---|---|
| บุคคล | ตำแหน่ง ความเชี่ยวชาญ ปีประสบการณ์ ใบอนุญาต | ทำงานที่ไหน จบจากไหน เขียนเรื่องอะไร | “ทพญ. สมใจ (สมมติ) ทันตแพทย์จัดฟัน ประจำคลินิก X ที่ขอนแก่น” |
| แบรนด์/องค์กร | ประเภทธุรกิจ ปีก่อตั้ง ที่ตั้ง ขนาด | บริษัทแม่ สาขา พันธมิตร ผู้ก่อตั้ง | “บริษัท Y จำกัด ผู้ผลิตน้ำพริกจากลำปาง ก่อตั้งปี 2560” |
| สินค้า | รุ่น ขนาด ตัวเลขสเปก ราคา วัสดุ | ผู้ผลิต รุ่นก่อนหน้า ใช้กับอะไร | “หม้อหุงข้าว 1.8 ลิตร รุ่น Z ของแบรนด์ Y ใช้ไฟ 700 วัตต์” |
| สถานที่ | ประเภทสถานที่ ที่อยู่ เวลาเปิด | อยู่ในเขตไหน ใกล้สถานีหรือจุดสังเกตอะไร | “คาเฟ่ใน ต.ช้างเผือก เชียงใหม่ เดิน 5 นาทีจากประตูมหาวิทยาลัย” |
| แนวคิด | นิยามหนึ่งประโยค ปีที่เริ่มใช้ ใครเสนอ | ต่างจากแนวคิดใกล้เคียงยังไง เป็นส่วนหนึ่งของอะไร | “GEO คือการปรับเนื้อหาให้ AI หยิบไปตอบ เสนอในงานวิจัยปี 2023” |
สังเกตว่าแถวสุดท้ายคือ entity ประเภทแนวคิด บทความความรู้ส่วนใหญ่ลืมแถวนี้ ทั้งที่การเขียนนิยามแบบ “X คือ …” ตามด้วยความต่างจากแนวคิดข้างเคียง คือรูปแบบที่ AI ยกไปใช้ได้ทั้งประโยค ถ้าอยากฝึกท่านี้ให้คล่อง แมวส้มรวมเทคนิคไว้ใน เทคนิค AEO เขียนคำตอบให้ AI ยกไปใช้
ชื่อซ้ำกับคนอื่น แยกตัวตน (disambiguation) ยังไงให้ AI ไม่สับสน
Disambiguation คือการเติมข้อมูลจนชื่อที่ซ้ำกันแยกออกจากกันได้ วิธีที่ใช้ได้ทันทีคือเขียน “วลีแยกตัวตน” ติดชื่อไว้เสมอ โดยลอกสูตรจากคำอธิบาย (description) ของ Wikidata ซึ่งเป็นฐานความรู้แบบเปิดที่ต้องแยกชื่อซ้ำกันทุกวัน แค่ค้นคำว่า Siam คำเดียวก็ได้ผลกว่า 146,000 รายการ (ค้นเมื่อ 19 ต.ค. 2026)
ลองค้นคำว่า Siam ใน Wikidata แล้วดูผล คำเดียวกันชี้ไปได้ทั้งนามสกุล ประเทศไทย อ่าวไทย ชื่อเก่าของประเทศ และภาพยนตร์ไทย สิ่งที่แยกพวกมันออกจากกันคือบรรทัดคำอธิบายสั้นๆ ใต้ชื่อ ไม่ใช่ตัวชื่อเลย
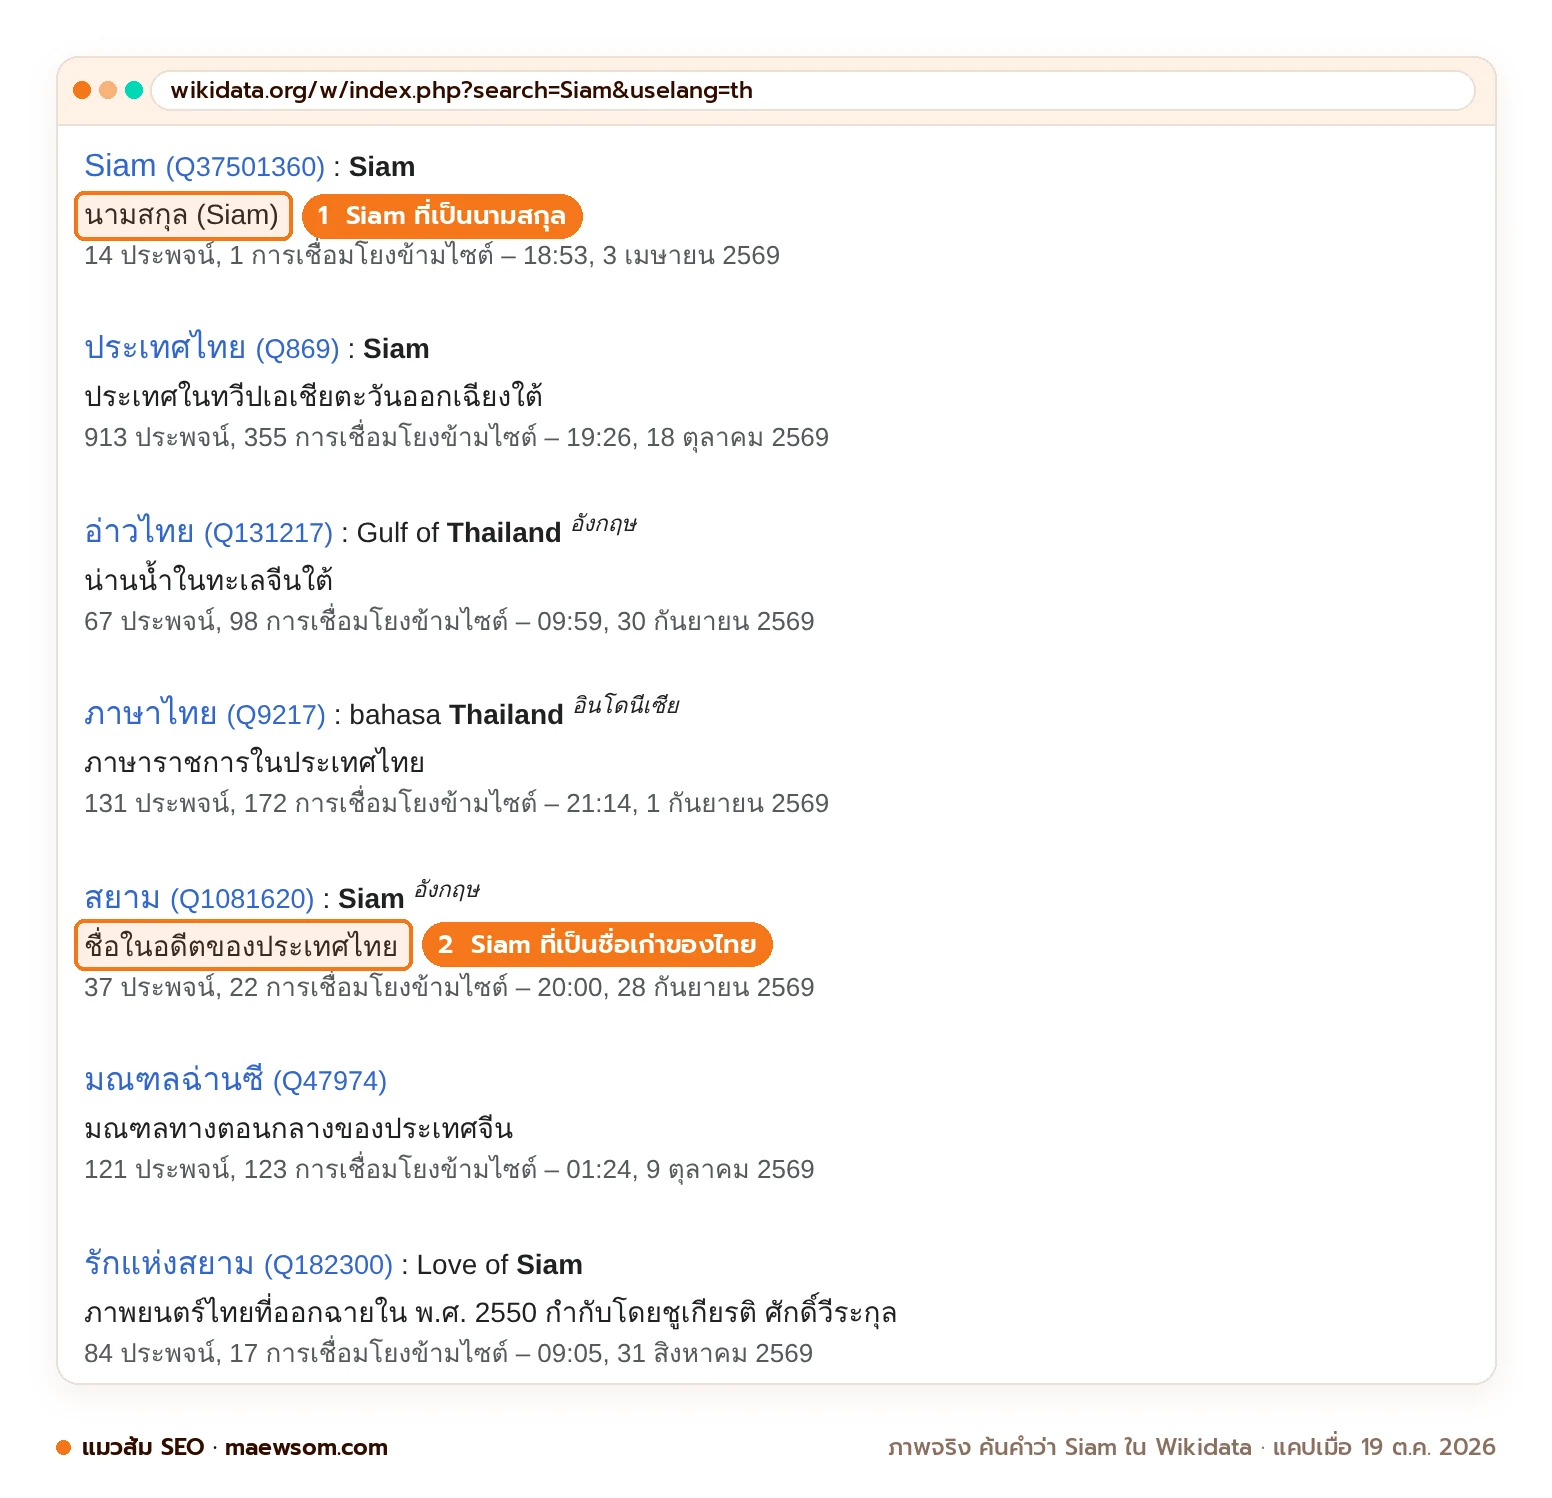
หน้าแนวทาง Help:Description ของ Wikidata วางหลักไว้ 3 ข้อที่เอามาใช้กับเว็บได้ตรงๆ ข้อแรก คำอธิบายควรยาวประมาณ 2-12 คำ คำเดียวมักกำกวมเกินไป ข้อสอง สถานที่ใช้สูตร “ประเภทสถานที่ ใน พื้นที่ย่อย, ประเทศ” ข้อสาม สองรายการมีชื่อเดียวกันได้ แต่ห้ามมีทั้งชื่อและคำอธิบายซ้ำกัน แปลเป็นภาษาธุรกิจไทยได้แบบนี้
- ชื่อร้านซ้ำ: “ครัวคุณยาย” มีเป็นร้อยร้าน ให้เขียน “ครัวคุณยาย ร้านอาหารใต้ในซอยอารีย์ 4 กรุงเทพฯ” ทุกครั้งที่แนะนำตัว
- ชื่อคนซ้ำ: หมอชื่อเดียวกันสองคน ให้ใส่สาขาเฉพาะทางและโรงพยาบาลที่ประจำ
- ชื่อสินค้าซ้ำกับคำทั่วไป: แอปชื่อ “ส้ม” ต้องมี “แอปบัญชีร้านค้า” ตามมาเสมอ ไม่อย่างนั้นระบบจะคิดถึงผลไม้ก่อน
ตัวอย่างธุรกิจไทย: เขียนหน้าสินค้าสวนทุเรียนใหม่ทั้งหน้า
ตัวอย่างนี้ใช้ธุรกิจสมมติ “สวนทุเรียนลุงชัย” เพื่อให้เห็นว่าหลักทั้งหมดรวมกันในหน้าจริงหน้าตาเป็นยังไง เริ่มจากทำรายการ entity ก่อนเขียน แล้วค่อยวางหัวข้อตามคำถามที่ลูกค้าถามจริงใน LINE OA
- รายการ entity ในหน้า แบรนด์ (สวนทุเรียนลุงชัย), สินค้า (ทุเรียนหมอนทองตัดแก่ 85%), บุคคล (ชัย ใจดี), สถานที่ (อำเภอขลุง จันทบุรี), แนวคิด (ความแก่ของทุเรียน)
- หัวข้อจากคำถามจริง “ทุเรียนตัดแก่ 85% คืออะไร”, “ส่งกี่วันถึง”, “ถ้าทุเรียนไม่สุกทำยังไง”
- ประโยคแรกของทุกหัวข้อเป็น entity-first เช่น “ทุเรียนตัดแก่ 85% คือทุเรียนที่ตัดเมื่อเนื้อสุกประมาณ 85% ของความแก่เต็มที่ ทำให้ถึงมือลูกค้าแล้วสุกพอดีใน 2-3 วัน (ตามมาตรฐานของสวนลุงชัย)”
- เล่าประสบการณ์ที่คนอื่นเลียนแบบไม่ได้ เช่น ลุงชัยเคาะลูกฟังเสียงยังไง ดูก้านแบบไหน นี่คือข้อมูลที่ Google เรียกว่า original information
ถ้าอยากบอก entity ในหน้าผ่านโค้ดด้วย Schema.org (คลังคำศัพท์กลางสำหรับติดป้ายข้อมูลในโค้ดให้เครื่องอ่าน เหมือนป้ายหมวดบนชั้นหนังสือห้องสมุด) มี property ชื่อ about (หัวเรื่องหลักของงาน) และ mentions (สิ่งที่ถูกพูดถึงแต่ไม่ใช่หัวเรื่องหลัก) ใช้ได้กับบทความ ตัวอย่างนี้ใช้ sameAs ชี้จังหวัดจันทบุรีไปที่รายการ Wikidata Q327730 (คำอธิบายว่า province in Thailand) sameAs ก็เหมือนการแนบเลขบัตรประชาชนให้ชื่อนั้น บอกเครื่องว่า “คือตัวเดียวกับรายการนี้นะ” ไม่ใช่จันทบุรีอื่น
พูดกันตรงๆ โค้ดนี้เป็นของเสริม Google เขียนไว้ว่า structured data ไม่ใช่ข้อกำหนดของ generative AI search และไม่มี markup พิเศษที่ต้องใส่ ถ้าเนื้อหาในหน้ายังเรียกชื่อมั่วอยู่ schema ช่วยอะไรไม่ได้ อยากรู้ว่า schema ตัวไหนคุ้มจริงอ่านต่อที่ Schema สำหรับ AI Search ใช้ markup แบบไหนให้ AI เข้าใจเว็บ
เช็กเองว่าเนื้อหาชัดเรื่อง entity ไหม มี 3 วิธี
วิธีเช็กที่ทำได้วันนี้มี 3 แบบ เรียงจากง่ายไปละเอียด คือ ทดสอบตัดแปะ ถาม AI ให้สรุป entity และส่องด้วย Google Cloud Natural Language API ซึ่งเป็นเครื่องมือวิเคราะห์ข้อความของ Google Cloud (ไม่ใช่ระบบจัดอันดับของ Google Search)
1. ทดสอบตัดแปะ
สุ่มย่อหน้ากลางหน้ามา 3 ย่อหน้า ก๊อปไปวางในโน้ตเปล่า แล้วถามตัวเองว่ารู้ไหมว่าพูดถึงแบรนด์ไหน สินค้าตัวไหน ถ้าต้องเลื่อนกลับไปอ่านหัวข้อก่อนจึงเข้าใจ ให้เติมชื่อเต็มในประโยคแรก
2. ถาม AI ให้ทำรายการ entity
วางบทความใน ChatGPT, Gemini หรือ Claude แล้วพิมพ์ “ทำตาราง entity ทั้งหมดในบทความนี้ บอกชื่อ ประเภท และข้อเท็จจริงที่บทความให้ไว้ของแต่ละตัว” ถ้า AI นับแบรนด์คุณเป็นสองตัว หรือหาที่ตั้งไม่เจอ แปลว่าคนอ่านก็คงงงเหมือนกัน วิธีนี้ไม่ได้บอกว่าคุณจะติดอันดับ มันแค่เป็นกระจกส่องความชัด
3. ส่องด้วย Natural Language API
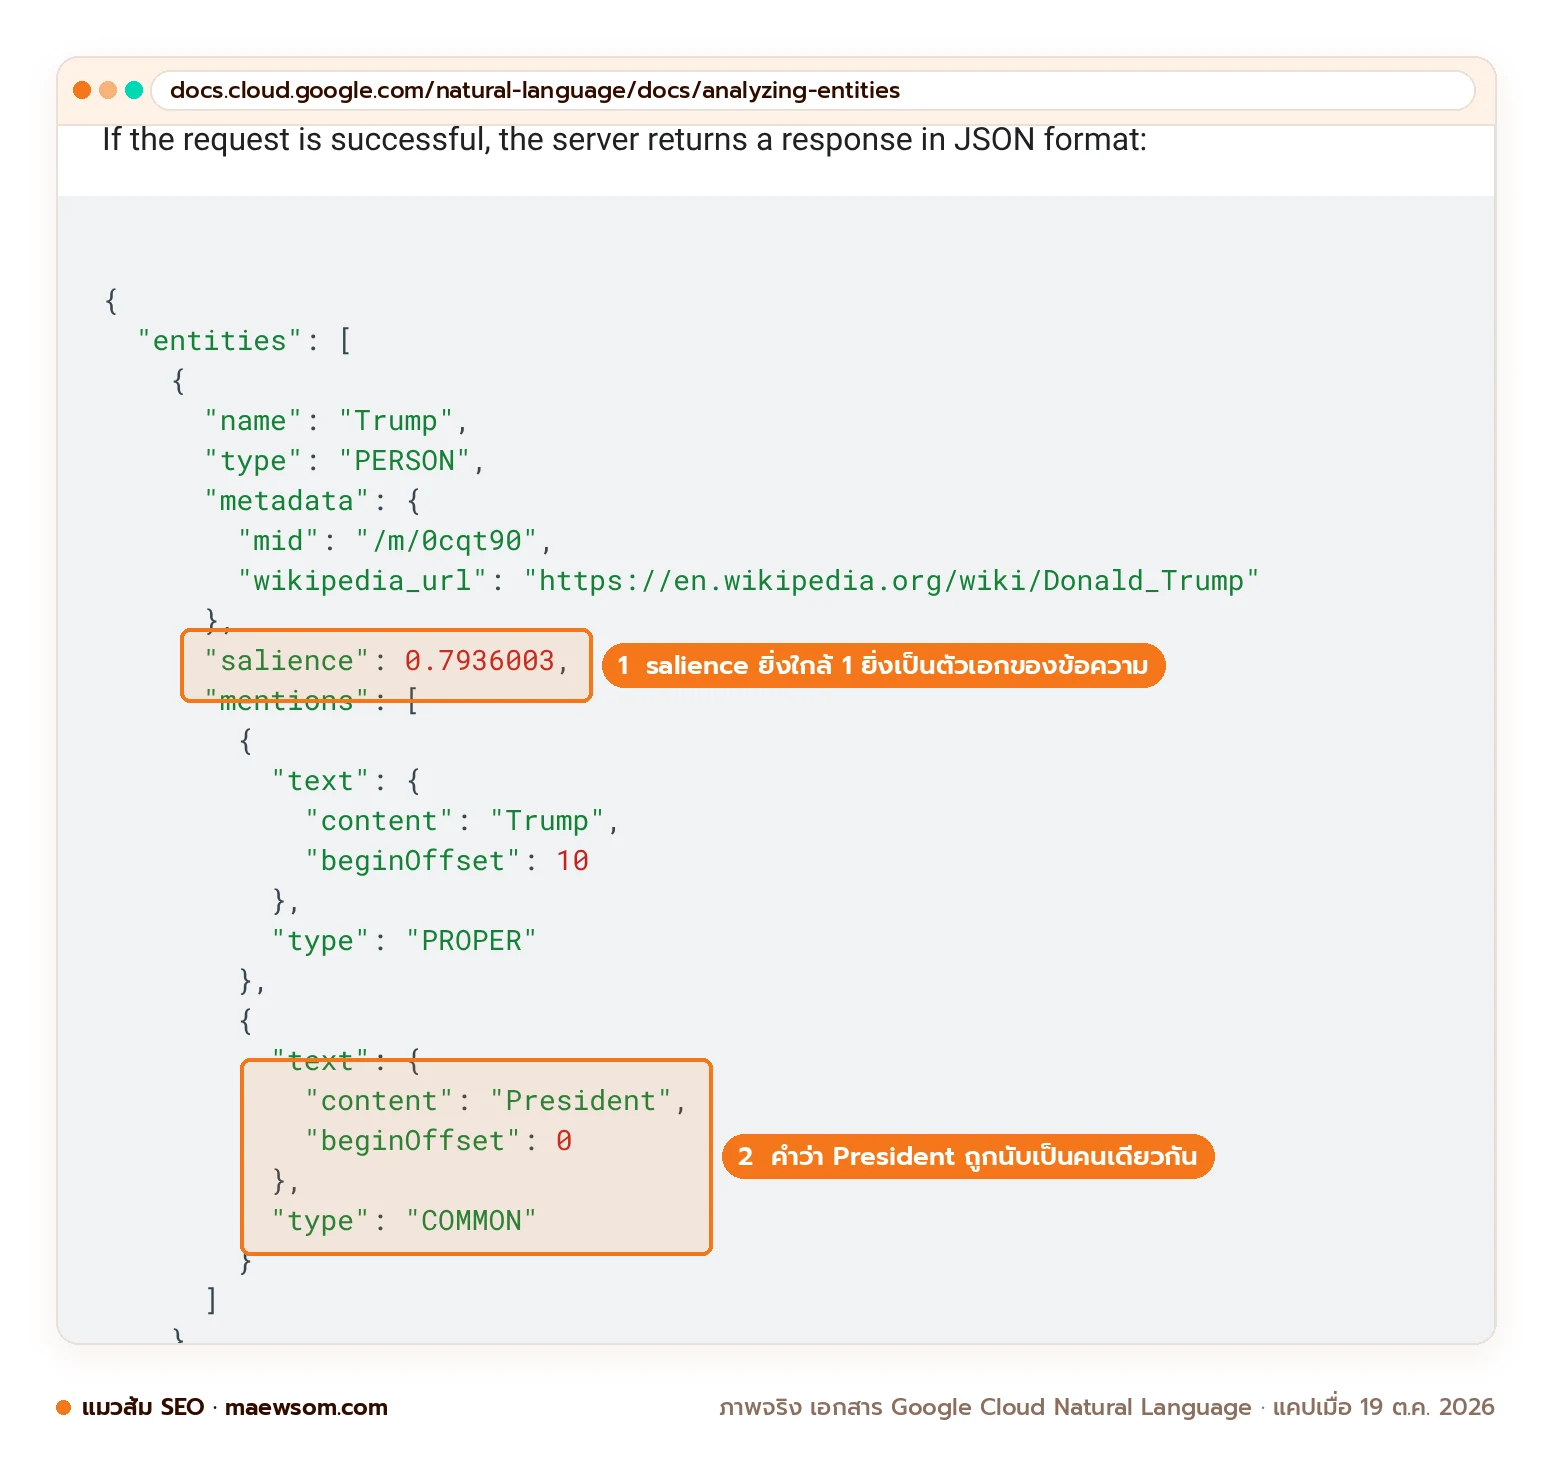
Natural Language API มีฟีเจอร์ Entity analysis ที่ดึง entity ออกจากข้อความ บอกประเภท (PERSON, ORGANIZATION, LOCATION, CONSUMER_GOOD ฯลฯ) และใน API เวอร์ชัน v1 จะให้คะแนน salience ช่วง 0 ถึง 1.0 ซึ่งเอกสารนิยามว่าเป็นความสำคัญหรือความเป็นศูนย์กลางของ entity นั้นต่อข้อความทั้งชิ้น เอาง่ายๆ คือคะแนน “ตัวเอกของเรื่อง” ใครได้ใกล้ 1 คือพระเอก
ตัวอย่างในเอกสารของ Google ใช้ประโยคเกี่ยวกับ President Trump และ White House ผลคือ Trump ได้ salience ประมาณ 0.79 ส่วน White House ได้ประมาณ 0.09 และคำว่า “President” ถูกนับเป็น mention ประเภท COMMON ของคนคนเดียวกัน นี่คือหลักฐานว่าระบบพยายามโยงคำเรียกหลายแบบเข้าหา entity เดียว ซึ่งจะโยงได้ง่ายขึ้นเมื่อคุณเรียกชื่อนิ่ง
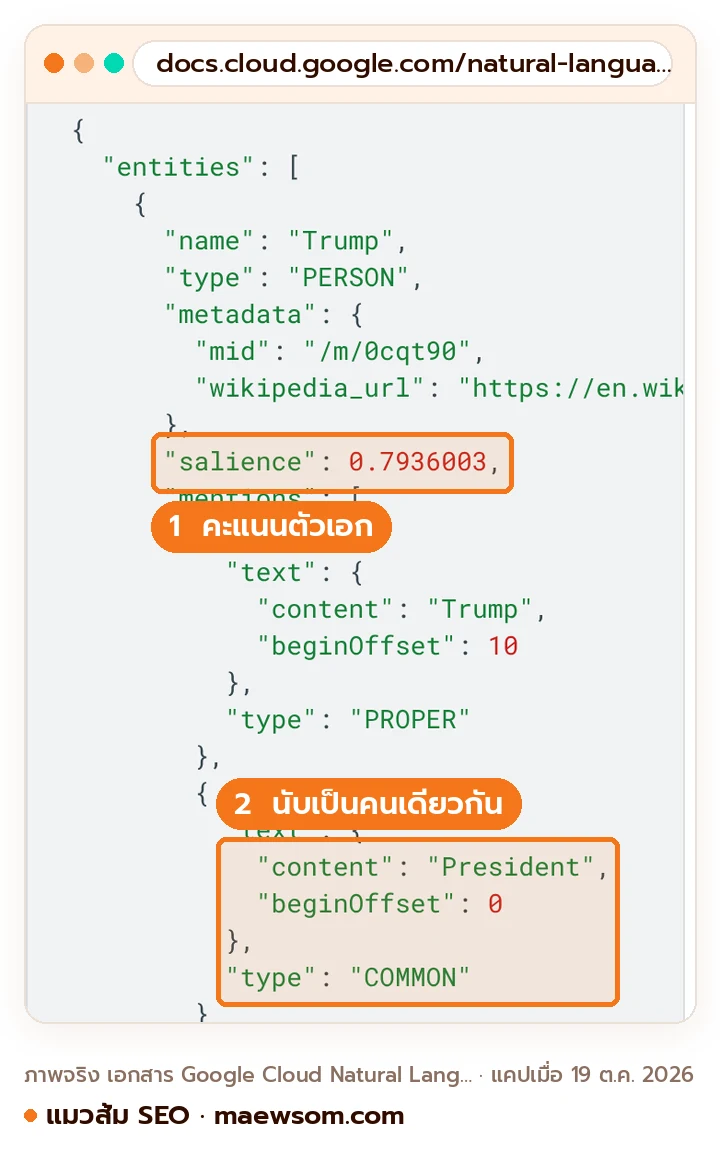
ทางที่ง่ายที่สุดคือกล่อง “Try the API” ในหน้า cloud.google.com/natural-language วางข้อความ กด Analyze แล้วติ๊ก reCAPTCHA ก็เห็น entity ที่ระบบดึงออกมาได้โดยไม่ต้องสร้างโปรเจกต์ ส่วนเอกสาร API เวอร์ชัน v2 ไม่มีช่อง salience แล้ว ถ้าจะเขียนโค้ดเรียกเองให้เลือกเวอร์ชันให้ถูก
ข้อสำคัญที่สุดสำหรับคนไทยคือ หน้า Language Support (อัปเดต 13 ต.ค. 2026) ระบุภาษาไทยไว้เฉพาะ Sentiment analysis ส่วนตาราง Entity analysis มี 11 ภาษาและไม่มีภาษาไทย ตรงนี้พลาดแล้วเสียเวลาฟรีนะ ถ้าวางข้อความไทยแล้วผลออกมาแปลก ไม่ได้แปลว่าบทความคุณแย่ ให้ทดสอบกับฉบับภาษาอังกฤษของหน้า About หรือหน้าสินค้าแทน แล้วใช้วิธีที่ 1-2 กับเนื้อหาไทย
คำถามที่พบบ่อย
แหล่งอ้างอิง
- Optimizing your website for generative AI features on Google Search โดย Google Search Central (อัปเดต ก.ค. 2026)
- Creating helpful, reliable, people-first content โดย Google Search Central (อัปเดต ต.ค. 2026)
- Optimizing Your Content for Inclusion in AI Search Answers โดย Microsoft Advertising (Krishna Madhavan, ต.ค. 2025)
- Language Support โดย Google Cloud Natural Language (อัปเดต ต.ค. 2026)
- Analyzing entities โดย Google Cloud Natural Language (อัปเดต ต.ค. 2026)
- Entity (REST reference v1) โดย Google Cloud Natural Language
- Help:Description โดย Wikidata (ตรวจ ต.ค. 2026)
- about และ mentions โดย Schema.org (เวอร์ชัน 30.1, ก.ย. 2026)
- Introducing the Knowledge Graph: things, not strings โดย Google (Amit Singhal, พ.ค. 2012)
เขียนโดย
แมวส้มคือมาสคอตของทีม BIQDADDY เอเจนซี SEO และ AISO ในไทย เล่าเรื่อง AI SEO, GEO และ AEO แบบเข้าใจง่าย บทความเขียนด้วยระบบ AI ตามมาตรฐานของทีม ตรวจข้อเท็จจริงกับแหล่งต้นทาง และผ่านผู้ตรวจ AI อิสระก่อนเผยแพร่ ทีม BIQDADDY เป็นผู้ดูแลเว็บและแก้ไขเมื่อมีผู้แจ้งข้อผิดพลาด อ่านนโยบายการเขียน
เรียบเรียงเนื้อหาโดย วุฒิภัทร อุณหะกะ Co-Founder และ COO ของ BIQDADDY
อ่านต่อกับแมวส้ม
Zero-Click Search คืออะไร เมื่อคนค้นแล้วไม่คลิกเข้าเว็บ ต้องวัดผลยังไง
Vector Search คืออะไร การค้นหาด้วยความหมายที่อยู่เบื้องหลัง AI Search
Transformer Model คืออะไร ตัว T ใน GPT ที่ทำให้ AI เข้าใจภาษา