สารบัญ
Entity SEO คืออะไร ทำให้ Google และ AI รู้ว่าแบรนด์คุณคือใคร
ฮัลโหล แมวส้มเองครับ ขอเริ่มด้วยการทดลองเล็ก ๆ ลองพิมพ์ชื่อร้านของคุณใน Google ดูตอนนี้เลย เจอข้อมูลของคุณครบไหม หรือมีร้านชื่อคล้ายโผล่มาแย่งที่ ถ้าเป็นแบบหลังก็ไม่ต้องตกใจ วันนี้แมวส้มจะมาไขเรื่องที่ทำให้ Google ไม่จำร้านคุณสลับกับใคร
Entity SEO คือ การทำ SEO (งานทำเว็บให้ติด Google) ที่ทำให้ Google และ AI จำแบรนด์ คน สินค้า หรือร้านของคุณได้เป็น “สิ่งหนึ่งที่ชัดเจน” ไม่ใช่แค่คำที่บังเอิญตรงกับคำค้น
หรือจะพูดแบบภาษาบ้าน ๆ ก็คือ ทำให้ Google รู้ว่า “ร้านนี้คือร้านนี้” ไม่ใช่ร้านไหนก็ได้ที่ชื่อบังเอิญคล้ายกัน นั่นเอง
ถ้าแยกคำออกมาดูทีละคำ จะเห็นภาพชัดขึ้นอีก
- Entity แปลว่า สิ่งที่มีตัวตนและระบุได้ชัด เช่น บริษัท คน สินค้า สถานที่
- SEO แปลว่า การปรับเว็บให้ถูกค้นเจอบนเครื่องมือค้นหาอย่าง Google
ถ้าค้นชื่อร้านตัวเองแล้วเจอข้อมูลร้านอื่นโผล่มา นั่นแหละอาการที่ Entity SEO ช่วยแก้ วิธีทำคือใช้ชื่อเดียวกันทุกที่ มีหน้า About ที่ตรวจได้ ใส่ schema (โค้ดซ่อนในหน้าเว็บที่บอกเครื่องว่าเราเป็นใคร) และให้คนนอกพูดถึงคุณจริง
อ่านจบหน้านี้ คุณจะเช็กเองได้ว่า Google รู้จักแบรนด์คุณแล้วหรือยัง และรู้ว่าต้องแก้อะไรก่อนหลัง ตั้งแต่ชื่อสองภาษาไปจนถึงเรื่อง Wikidata ที่แมวส้มขอพูดแบบตรง ๆ
- Entity คือ "ตัวจริง" ที่ระบุได้ชัด ส่วนคีย์เวิร์ดคือ "คำ" ที่คนพิมพ์ค้น Google เริ่มคิดแบบนี้ตั้งแต่เปิด Knowledge Graph (สมุดความรู้ที่ Google จดว่าอะไรเกี่ยวกับอะไร) ปี 2012
- เช็กได้ 2 ทาง คือดูกล่องข้อมูลข้างผลค้นหา (knowledge panel) หรือค้นผ่าน API (ช่องทางให้โปรแกรมคุยกับ Google) ของ Google Cloud
- ทำเองได้วันนี้ 4 อย่าง คือชื่อไทยอังกฤษตรงกัน หน้า About, schema + sameAs (ช่องใส่ลิงก์โปรไฟล์ทางการของคุณ) และ Google Business Profile (โปรไฟล์ร้านบน Google Maps)
- Wikidata (ฐานความรู้เปิดที่ใครก็แก้ได้) ไม่ใช่ที่ฝากโปรไฟล์บริษัท ถ้ายังไม่มีแหล่งอ้างอิงสาธารณะ อย่าเพิ่งสร้าง
- ไม่มีสูตรลับให้ติด AI แต่ตัวตนที่ชัดช่วยให้ AI พูดถึงคุณได้ถูกคน
Entity SEO คืออะไร ต่างจากการทำ keyword ยังไง
Entity SEO คือการทำให้แบรนด์คุณเป็น “สิ่ง” ที่ Google รู้จัก มีข้อมูลชัด และรู้ว่าเกี่ยวกับอะไรบ้าง ส่วน SEO แบบคีย์เวิร์ดสนใจแค่ว่าหน้าเว็บมีคำตรงกับที่คนค้นไหม
เอาง่ายๆ คีย์เวิร์ดคือ “ชื่อที่เรียก” ส่วน entity คือ “ตัวคนจริงๆ” สองอย่างนี้ไม่ได้แทนกัน คีย์เวิร์ดยังต้องทำ แค่ไม่ใช่ทั้งเกมแล้ว
ลองคิดสภาพว่า.. มีคนสามคนพิมพ์คำว่า “สิงห์” เหมือนกัน คนหนึ่งหมายถึงเบียร์ อีกคนหมายถึงราศี อีกคนทำการบ้านเรื่องสัตว์ป่า ตัวอักษรเหมือนกันเป๊ะ แต่เป็นคนละ entity
ทีนี้ระบบที่เข้าใจ entity จะดูคำรอบข้าง เช่น “สิงห์ ราคาเท่าไร” กับ “สิงห์ กินอะไร” แล้วเลือกตัวที่ถูก ถ้าเลือกผิดก็ขำดี แต่ถ้าแบรนด์คุณโดนสลับ คงขำไม่ออก
คนในวงการชอบพูดว่า “things, not strings” แปลว่า “ของจริง ไม่ใช่แค่ตัวอักษร” วลีนี้มาจากบล็อกของ Google ตอนเปิด Knowledge Graph วันที่ 16 พฤษภาคม 2012
คนเขียนคือ Amit Singhal ซึ่งตอนนั้นเป็นผู้บริหารใหญ่ฝ่ายวิศวกรรม (SVP of Engineering) ของ Google ใจความคือ เลิกนับว่าหน้าเว็บมีคำนี้กี่ครั้ง แล้วหันมาถามว่าคำนี้หมายถึงอะไรในโลกจริง
แมวส้มมองว่าวลีนี้เปลี่ยนคำถามของเจ้าของเว็บไปด้วย จากเดิมที่ถามว่า “หน้าเราใส่คำค้นครบหรือยัง” กลายเป็น “Google รู้หรือยังว่าเราคือใคร” ถ้าตอบข้อหลังไม่ได้ ต่อให้ใส่คำค้นครบแค่ไหน ก็ยังเสี่ยงโดนจำสลับกับคนชื่อคล้ายอยู่ดี
หลักเดียวกันใช้กับงานเขียนด้วย ดูตัวอย่างก่อนและหลังแก้ได้ที่ Entity-based Content เขียนยังไงให้ Google และ AI เข้าใจว่าคุณพูดถึงใคร
| มุมมอง | คีย์เวิร์ด (strings) | Entity (things) |
|---|---|---|
| ระบบสนใจอะไร | คำหรือวลีที่พิมพ์ | สิ่งที่มีตัวตน เช่น บริษัท คน สินค้า สถานที่ |
| ระบบถามว่าอะไร | หน้านี้มีคำว่า X ไหม | หน้านี้พูดถึง X ตัวไหน และ X เกี่ยวกับอะไรบ้าง |
| ตัวอย่าง | “ร้านกาแฟ ส้ม อารีย์” | บ้านส้มคั่ว (บริษัท) อยู่ซอยอารีย์ 1 (สถานที่) ดำเนินงานโดย บริษัท บ้านส้ม จำกัด |
| สิ่งที่ต้องทำ | ใส่คำค้นในชื่อหน้า หัวข้อ และเนื้อหา | ทำให้ชื่อ ข้อมูล และความเกี่ยวข้องของแบรนด์ตรงกันทั้งในเว็บและนอกเว็บ |
พอไล่ดูครบทั้งตาราง แถวที่แมวส้มอยากให้จำคือแถวสุดท้าย งานคีย์เวิร์ดจบได้ในหน้าเว็บของคุณเอง แต่งาน entity ต้องทำให้ข้อมูลตรงกันทั้งในเว็บและนอกเว็บ คำถามต่อมาก็คือ แล้ว Google เก็บข้อมูลพวกนี้ไว้ที่ไหน
Knowledge Graph คืออะไร และเกี่ยวกับ entity ของคุณยังไง
Knowledge Graph คือสมุดความรู้ของ Google ที่จดว่าอะไรเป็นอะไร และเกี่ยวกับใคร คล้ายผังความสัมพันธ์ตัวละครในซีรีส์ เช่น “บริษัท A ก่อตั้งโดยคน B มีออฟฟิศที่เมือง C”
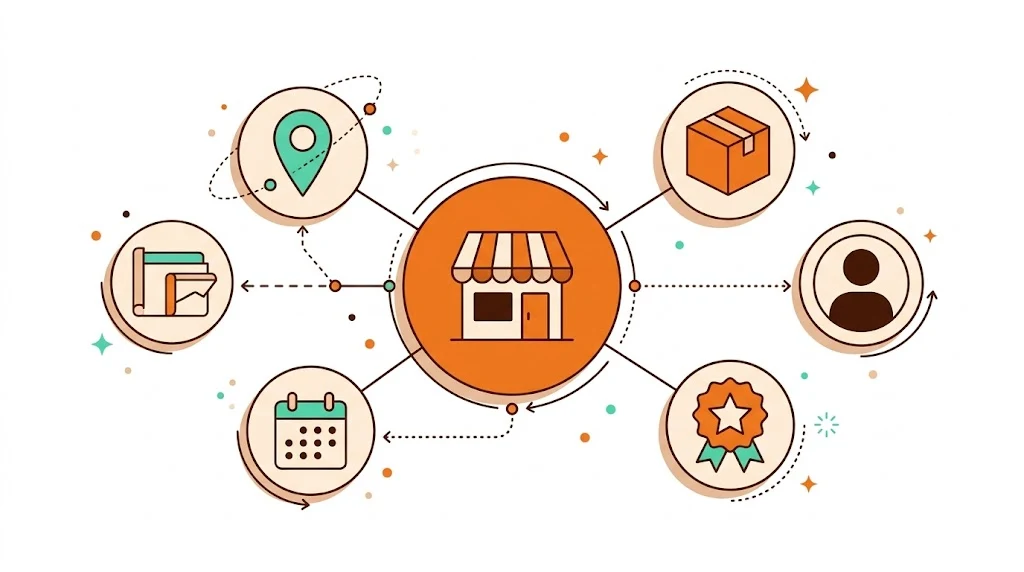
แยกคำให้ดูก่อน Knowledge แปลว่า ความรู้ ส่วน Graph แปลว่า แผนภาพที่ลากเส้นเชื่อมจุดต่าง ๆ เข้าหากัน รวมกันก็คือ “แผนภาพความรู้” ที่ทุกเรื่องโยงหากันเป็นใยแมงมุม
หรือจะพูดแบบภาษาบ้าน ๆ ก็คือ ป้าร้านข้าวแกงปากซอยที่จำได้ว่า “น้องคนนี้ทำงานธนาคาร อยู่บ้านสีเขียว ชอบแกงเขียวหวานไม่ใส่มะเขือ” นั่นเอง ป้าไม่ได้จำแค่หน้า Knowledge Graph คือสมุดจดแบบป้า แต่จดทั้งโลก
แล้วถามว่า.. ทั้งโลกนี่ใหญ่แค่ไหน ตัวเลขใหญ่มากครับ ตอนเปิดปี 2012 Google บอกว่ามีมากกว่า 500 ล้านสิ่ง และมากกว่า 3,500 ล้านข้อเท็จจริง
ตัวเลขทางการล่าสุดอยู่ในบทความของ Danny Sullivan วันที่ 20 พฤษภาคม 2020 คือมากกว่า 500,000 ล้านข้อเท็จจริง เกี่ยวกับ 5,000 ล้าน entity
หลังจากนั้น แมวส้มยังไม่พบตัวเลขทางการที่ใหม่กว่านี้ หน้าช่วยเหลือตอนนี้เขียนแค่ว่ามี “หลายพันล้านข้อเท็จจริง” เกี่ยวกับคน สถานที่ และสิ่งของ
แมวส้มมองว่าตัวเลขพวกนี้บอกเราว่า ยิ่งสมุดหนา ชื่อซ้ำและชื่อคล้ายก็ยิ่งเยอะ แบรนด์ที่ข้อมูลไม่ชัดก็เหมือนลายมือหวัด ๆ หน้าหนึ่งในสมุด อ่านผิดได้ง่ายมาก
ส่วนที่คุณเห็นได้ด้วยตาคือ knowledge panel หรือกล่องข้อมูลข้างผลค้นหา (หน้าช่วยเหลือภาษาไทยของ Google ส่วนใหญ่เรียกว่า “การ์ดความรู้”) คล้ายบัตรประจำตัวที่ Google ทำให้ มีชื่อ โลโก้ คำอธิบาย และโปรไฟล์โซเชียล
ถ้าเจอกล่องนี้ แปลว่า Google มี entity ของคุณแล้ว ถ้าไม่เจอ อาจแค่ยังไม่มั่นใจพอ เหมือนป้าที่จำหน้าคุณได้ แต่ยังไม่กล้าเรียกชื่อเพราะกลัวผิด
ทีนี้คำถามที่ตามมาก็คือ แล้วแบรนด์เราอยู่ในสมุดของป้าแล้วหรือยัง ไปเช็กกันเลยครับ
วิธีเช็กว่าแบรนด์คุณเป็น entity ใน Google แล้วหรือยัง
ทางเร็วคือค้นชื่อแบรนด์ใน Google แล้วดูว่ามี knowledge panel ไหม ทางละเอียดคือค้นใน Knowledge Graph ผ่าน API
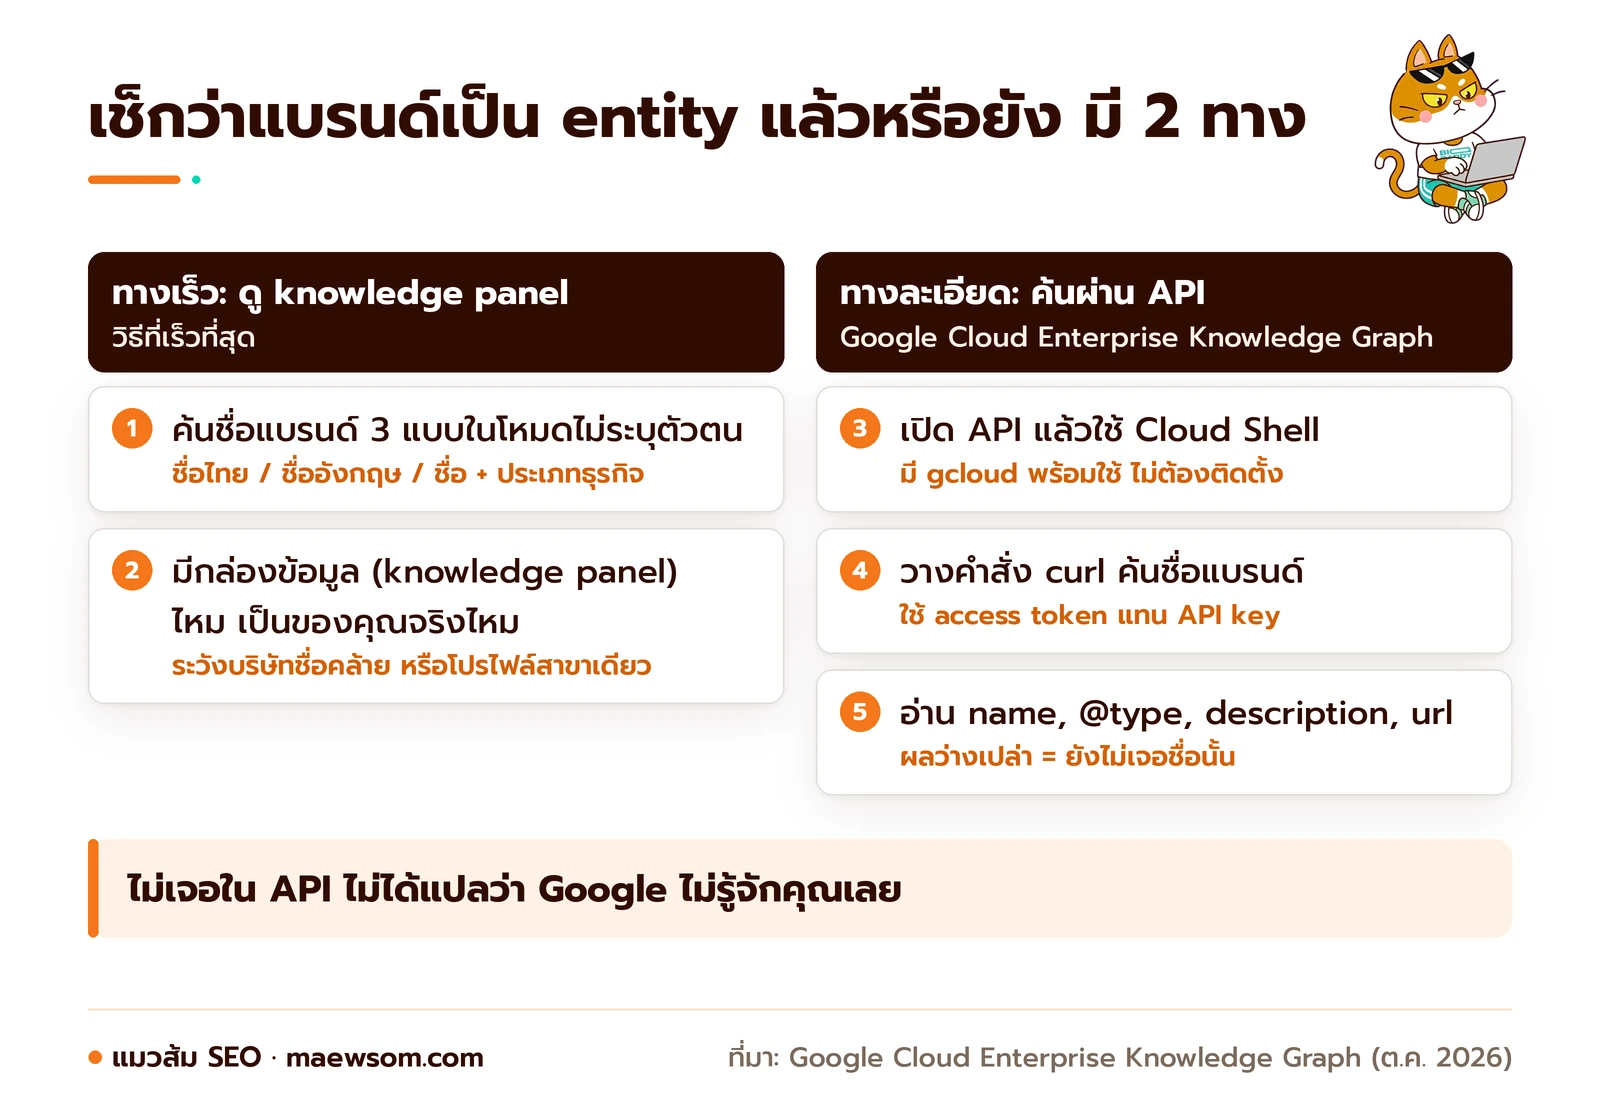
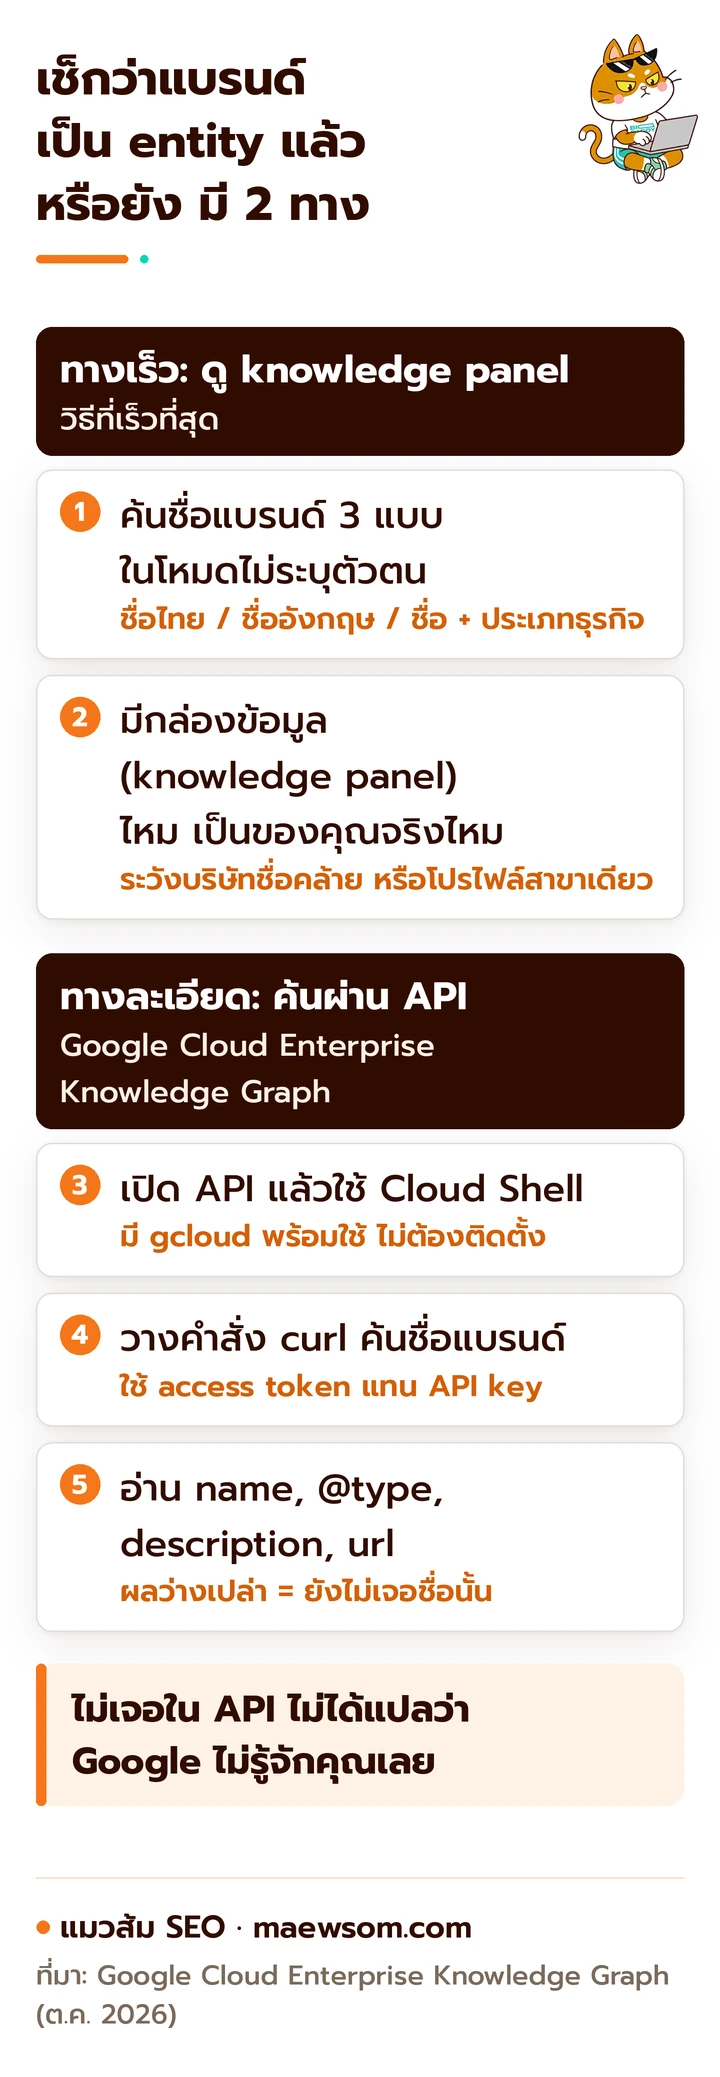
ถ้าเพิ่งเริ่ม เอกสารของ Google แนะนำให้ใช้ตัวใหม่ชื่อ Google Cloud Enterprise Knowledge Graph แทน Knowledge Graph Search API ตัวเดิม
ทำตาม 5 ขั้นนี้ได้วันนี้เลย ข้อ 1-2 ใช้แค่เบราว์เซอร์ ข้อ 3-5 สำหรับคนที่ไม่กลัวหน้าจอพิมพ์คำสั่ง ถ้าไม่ถนัดก็หยุดแค่ข้อ 2 ได้ ไม่เสียหายอะไร
- ค้นชื่อแบรนด์ 3 แบบ ชื่อไทย ชื่ออังกฤษ และชื่อ + ประเภทธุรกิจ เช่น “บ้านส้มคั่ว”, “Baan Som Roastery”, “บ้านส้มคั่ว ร้านกาแฟ” (ชื่อสมมติ) ใช้โหมดไม่ระบุตัวตน (หน้าต่างที่ไม่ใช้ประวัติค้นหาเดิม) แล้วจดว่าแบบไหนมีกล่องข้อมูล
- ดูว่ากล่องนั้นเป็นของคุณจริงไหม บางทีเป็นของบริษัทชื่อคล้าย หรือเป็นแค่โปรไฟล์สาขาเดียว
- เตรียมโปรเจกต์ Google Cloud (บริการเช่าระบบคอมพิวเตอร์ของ Google) สร้างหรือเลือกโปรเจกต์ เปิดใช้ Enterprise Knowledge Graph API แล้วเปิด Cloud Shell (หน้าจอพิมพ์คำสั่งในเบราว์เซอร์) ซึ่งมีคำสั่ง
gcloud(ชุดคำสั่งของ Google Cloud) พร้อมใช้ ไม่ต้องติดตั้งอะไร - วางคำสั่งค้นหา วางคำสั่งด้านล่างใน Cloud Shell แล้วแทน PROJECT_ID ด้วยรหัสโปรเจกต์ของคุณ คำสั่งนี้ใช้ access token (บัตรผ่านชั่วคราวที่หมดอายุเอง) แทน API key (กุญแจถาวร)
- อ่านผล ถ้าเจอ ให้ดู
name,@type,descriptionและurlว่าตรงกับแบรนด์คุณไหม ถ้าitemListElementว่างเปล่า แปลว่ายังไม่เจอ entity ที่ตรงชื่อนั้น
curl -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://enterpriseknowledgegraph.googleapis.com/v1/projects/PROJECT_ID/locations/global/publicKnowledgeGraphEntities:Search?query=Baan%20Som%20Roastery&languages=th&types=Organization&limit=5"
ผลที่ได้อยู่ในรูปแบบ JSON-LD คือข้อมูลที่จัดเป็นคู่ “หัวข้อ กับ ค่า” ให้เครื่องอ่าน หน้าตาประมาณนี้ (ค่าข้างในเป็นตัวอย่างสมมติ ตัดให้สั้นแล้ว)
{
  "@type": "ItemList",
  "itemListElement": [
    {
      "@type": "EntitySearchResult",
      "result": {
        "@id": "kg:/g/xxxxxxxx",
        "name": "Baan Som Roastery",
        "@type": ["Organization", "Thing"],
        "description": "Coffee roaster",
        "url": "https://baansom.example/"
      }
    }
  ]
}
แมวส้มชอบที่ตัวใหม่ใช้ access token แทน API key เพราะบัตรผ่านชั่วคราวหมดอายุเอง ถ้าเผลอแปะคำสั่งไว้ในโน้ตหรือแชตทีม ก็ไม่เหลือกุญแจถาวรค้างไว้ให้ใครหยิบไปใช้ต่อ
รายละเอียดเพิ่ม: ถ้าโปรเจกต์คุณเปิด API ตัวเดิมไว้แล้ว ยังใช้แบบ API key ได้ที่ https://kgsearch.googleapis.com/v1/entities:search?query=...&key=API_KEY แต่ไม่ควรเริ่มโปรเจกต์ใหม่ด้วยตัวนี้
API ตัวเดิมจะมีค่า resultScore (คะแนนความตรง) ด้วย Google ไม่ได้บอกว่าคำนวณยังไง จึงใช้ได้แค่เทียบกันในผลชุดเดียว เช่น ดูว่าแบรนด์คุณอยู่อันดับ 1 หรือแพ้ชื่อคล้าย
อย่าเอา resultScore ไปเป็น KPI (ตัวเลขที่ใช้รายงานผลงาน) รายเดือน มันเหมือนวัดไข้ด้วยเทอร์โมมิเตอร์ที่ไม่มีใครบอกสเกล
ถ้าให้แมวส้มเลือกทางเดียวสำหรับร้านเล็ก แมวส้มเลือกทางเร็ว เพราะสิ่งที่ลูกค้าเห็นจริงคือกล่องข้อมูลบนหน้าค้นหา ไม่ใช่ผล JSON ในหน้าจอคำสั่ง
เช็กแล้วยังไม่เจอก็อย่าเพิ่งท้อนะครับ เพราะส่วนต่อไปคือของที่คุณลงมือสร้างเองได้ตั้งแต่วันนี้
สร้าง entity signals ให้แบรนด์ไทยต้องทำอะไรบ้าง
Entity signals คือหลักฐานที่ทำให้ระบบมั่นใจว่า “ชื่อนี้ คือสิ่งนี้” ยิ่งหลายแหล่งชี้ไปทางเดียวกัน ระบบยิ่งมั่นใจ
หรือจะพูดแบบภาษาบ้าน ๆ ก็คือ การถามทางในตลาดนัดนั่นเอง ถ้าแม่ค้าสามร้านชี้ทางเดียวกัน คุณเดินไปได้เลย ถ้าชี้คนละทิศ คุณก็ยืนงง แบรนด์ไทยมีโจทย์เพิ่มคือชื่อสองภาษาที่มักสะกดไม่ตรงกัน
แมวส้มมองว่าโจทย์ชื่อสองภาษานี่แหละที่ยากที่สุด เพราะร้านเดียวต้องคุมการสะกดสองชุดไปพร้อมกัน ไล่ทำทีละข้อข้างล่างนี้ได้เลย
1. ชื่อ ที่อยู่ เบอร์โทร ต้องตรงกันทุกที่ ทั้งไทยและอังกฤษ
NAP ย่อมาจาก Name แปลว่า ชื่อ, Address แปลว่า ที่อยู่ และ Phone แปลว่า เบอร์โทร ถ้าร้านเดียวสะกด 4 แบบใน 4 แพลตฟอร์ม เครื่องจะเห็นเป็นร้าน 4 ร้านที่บังเอิญอยู่ตึกเดียวกัน
เลือกชื่อทางการภาษาไทย 1 ชื่อ ภาษาอังกฤษ 1 ชื่อ แล้วใช้ให้เหมือนกันทุกช่องทาง ทั้งเว็บ Facebook Page, LINE OA (บัญชีร้านบน LINE), Google Business Profile, Shopee/Lazada และไดเรกทอรีธุรกิจ (เว็บรวมรายชื่อร้านค้า)
| ช่องทาง | ก่อนแก้ (เจอบ่อย) | หลังแก้ |
|---|---|---|
| ท้ายหน้าเว็บ | บ้านส้ม คั่วกาแฟ | บ้านส้มคั่ว (Baan Som Roastery) |
| Facebook Page | BaanSom Coffee | Baan Som Roastery บ้านส้มคั่ว |
| Google Business Profile | ร้านกาแฟบ้านส้ม อารีย์ กาแฟสด เบเกอรี่ | บ้านส้มคั่ว |
| เบอร์โทร | 02-xxx-xxxx บางที่, 08x บางที่ | เบอร์หลักเดียวกันทุกที่ รูปแบบเดียวกัน |
ชื่อเล่นที่ลูกค้าเรียกจริง ให้ใส่ในช่อง alternateName (ชื่ออื่นที่ใช้เรียก) ของ schema และในหน้า About อย่าเปลี่ยนชื่อไปมาตามแพลตฟอร์ม
แมวส้มชอบตารางนี้ เพราะเห็นชัดว่าปัญหาไม่ได้อยู่ที่พิมพ์ผิด แต่อยู่ที่แต่ละช่องทางเติมคำต่อท้ายกันคนละแบบ อย่าง “กาแฟสด เบเกอรี่” ในแถว Google Business Profile ซึ่งเป็นคำอธิบายสินค้า ไม่ใช่ชื่อร้าน
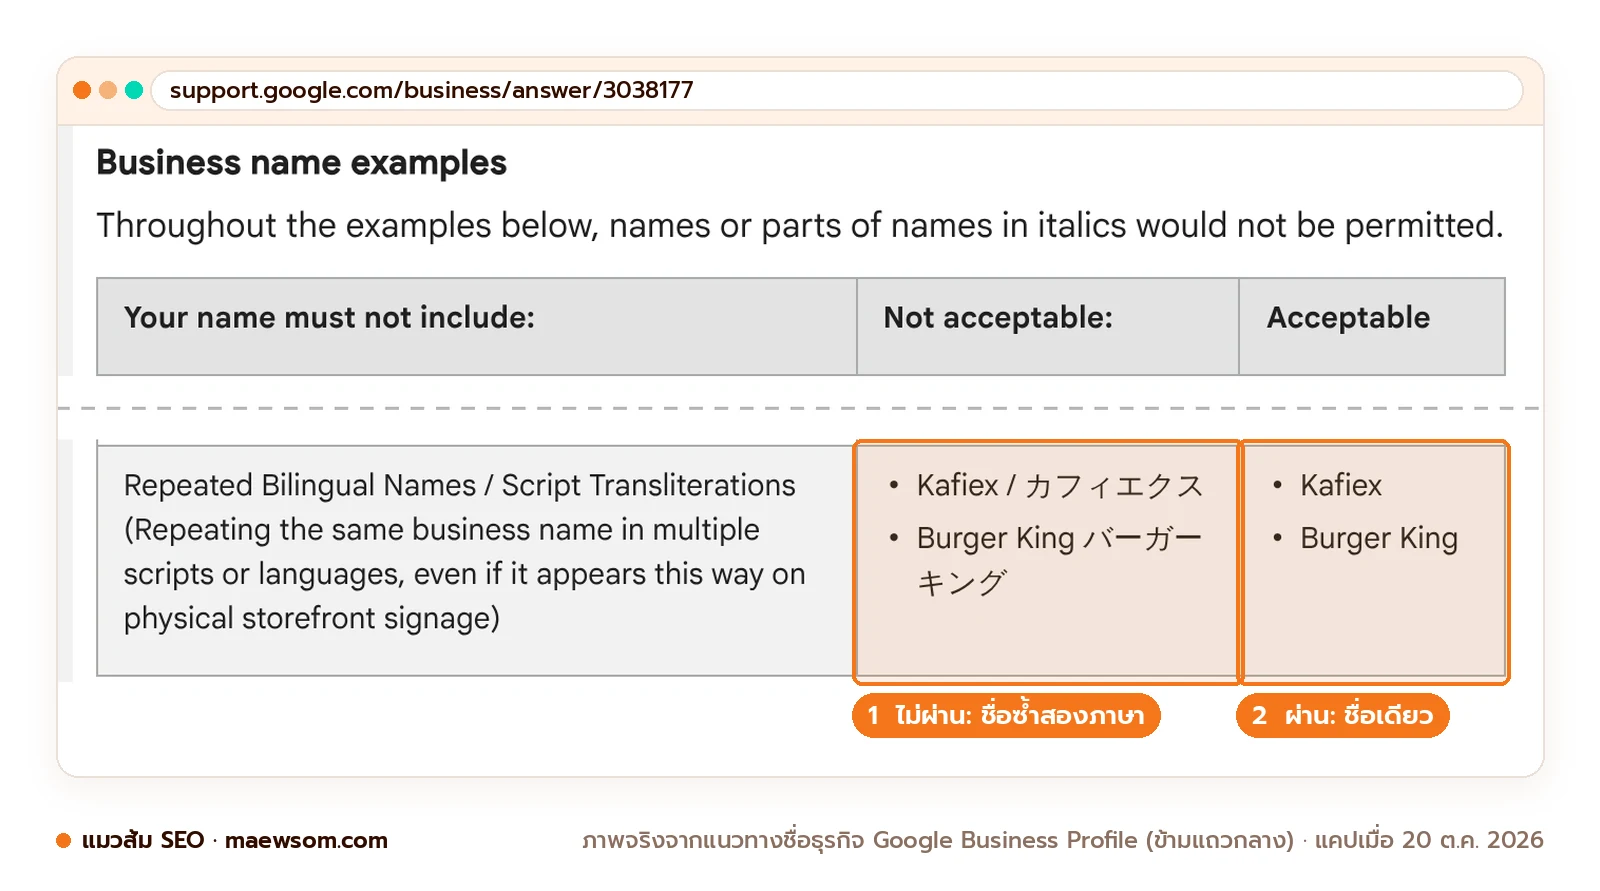
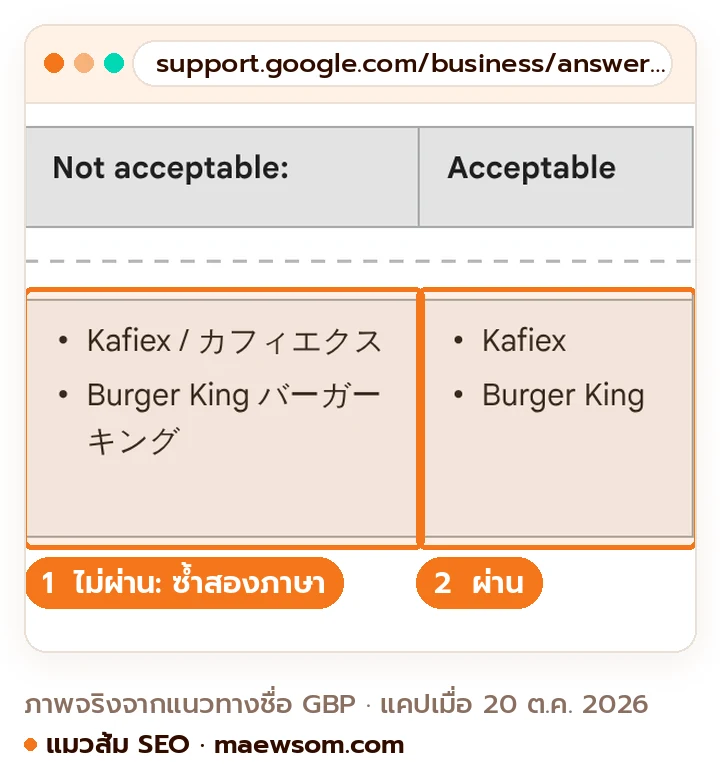
ชื่อใน Google Business Profile มีกฎเข้มกว่า ต้องเป็นชื่อจริงที่ใช้บนป้าย เว็บ และเอกสาร ห้ามใส่สโลแกนหรือคำอธิบายสินค้า
ชื่อย่านใส่ได้เฉพาะเมื่อเป็นส่วนของชื่อจริง ตัวอย่างของ Google คือ “Equinox SOHO” ผ่าน แต่ “Equinox near SOHO” ไม่ผ่าน
ข้อที่แบรนด์ไทยพลาดกันบ่อย คือห้ามใส่ชื่อซ้ำหลายภาษา Google ยกตัวอย่าง “Burger King バーガーキング” ว่าไม่ผ่าน ดูภาพจริงข้างบนได้เลย
ดังนั้นอย่าตั้งชื่อว่า “บ้านส้มคั่ว Baan Som Roastery” แม้ป้ายหน้าร้านจะเขียนสองภาษา ทำผิดกฎแล้วโปรไฟล์อาจถูกระงับ เสียดายแย่
สิ่งที่แมวส้มกังวลคือกฎข้อนี้สวนทางกับความรู้สึกของเจ้าของร้าน ป้ายหน้าร้านเขียนสองภาษา ก็อยากให้ชื่อบน Google เขียนแบบเดียวกัน แมวส้มแนะนำให้เลือกชื่อหลักชื่อเดียวในโปรไฟล์ แล้วให้ชื่ออีกภาษาไปอยู่ใน alternateName และหน้า About แทน
2. หน้า About ที่ตอบว่า “คุณคือใคร” แบบตรวจสอบได้
หน้า About คือบัตรประชาชนของแบรนด์บนเว็บตัวเอง เอกสารของ Google ก็แนะนำให้วาง schema ขององค์กรไว้ที่หน้าแรก หรือหน้าที่อธิบายองค์กร เช่น หน้า About
หน้านี้ควรมีข้อเท็จจริงที่ตรวจได้ ไม่ใช่วิสัยทัศน์ล้วนๆ ลองเทียบดู
- ก่อน: “เรามุ่งมั่นส่งมอบกาแฟคุณภาพเพื่อทุกคน ด้วยใจรักในทุกแก้ว”
- หลัง: “บ้านส้มคั่ว (Baan Som Roastery) เป็นโรงคั่วกาแฟในกรุงเทพฯ ก่อตั้งปี 2562 ดำเนินงานโดย บริษัท บ้านส้ม จำกัด คั่วเมล็ดจากเชียงราย ขายส่งให้ร้านกาแฟ และมีหน้าร้านที่ซอยอารีย์ 1”
แบบหลังมีชื่อสองภาษา ประเภทธุรกิจ ปีก่อตั้ง ชื่อบริษัท และที่ตั้ง AI ยกไปตอบได้ทันทีเมื่อมีคนถามว่า “บ้านส้มคั่วคือร้านอะไร”
แมวส้มมองว่าประโยค “ก่อน” ไม่ได้ผิดอะไร แค่มันใช้ได้กับร้านกาแฟทุกร้าน ลองเปลี่ยนชื่อร้านเป็นร้านอื่นดู ประโยคนี้ก็ยังจริงอยู่ดี ส่วนประโยค “หลัง” เป็นของบ้านส้มคั่วร้านเดียวเท่านั้น นี่แหละความต่างระหว่างคำสวย ๆ กับข้อมูลที่บอกว่าคุณคือใคร
3. Organization schema พร้อม sameAs
Organization schema คือโค้ดที่บอกเครื่องว่าองค์กรนี้ชื่ออะไร โลโก้ไหน ติดต่อยังไง เหมือนกรอกแบบฟอร์มประวัติให้เครื่องอ่าน
ส่วน sameAs คือช่องใส่ลิงก์โปรไฟล์ทางการของคุณในที่อื่น เช่น เพจโซเชียล พูดง่ายๆ คือ “นี่คือบัญชีของฉันที่อื่นนะ” Google บอกว่าไม่มีช่องไหนบังคับ แต่แนะนำให้ใส่ทุกช่องที่ใช้ได้
ถ้าแยกคำดู Same แปลว่า เดียวกัน ส่วน As แปลว่า กับ รวมกันก็คือ “เป็นตัวเดียวกันกับ” ชื่อช่องบอกหน้าที่ของมันตรง ๆ เลยครับ
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://baansom.example/#organization",
  "name": "บ้านส้มคั่ว",
  "alternateName": ["Baan Som Roastery", "บ้านส้ม"],
  "legalName": "บริษัท บ้านส้ม จำกัด",
  "url": "https://baansom.example/",
  "logo": "https://baansom.example/logo-512.png",
  "foundingDate": "2019",
  "telephone": "+66-2-000-0000",
  "sameAs": [
    "https://www.facebook.com/your-page-name",
    "https://www.instagram.com/your-account-name",
    "https://www.youtube.com/@your-channel-name"
  ]
}
</script>
ลิงก์ใน sameAs ข้างบนเป็นตัวอย่าง ให้เปลี่ยนเป็นโปรไฟล์จริงที่ชื่อตรงกัน อย่าใส่ลิงก์ข่าวที่เขียนถึงคุณ เพราะหน้านั้นไม่ได้ “เป็น” คุณ
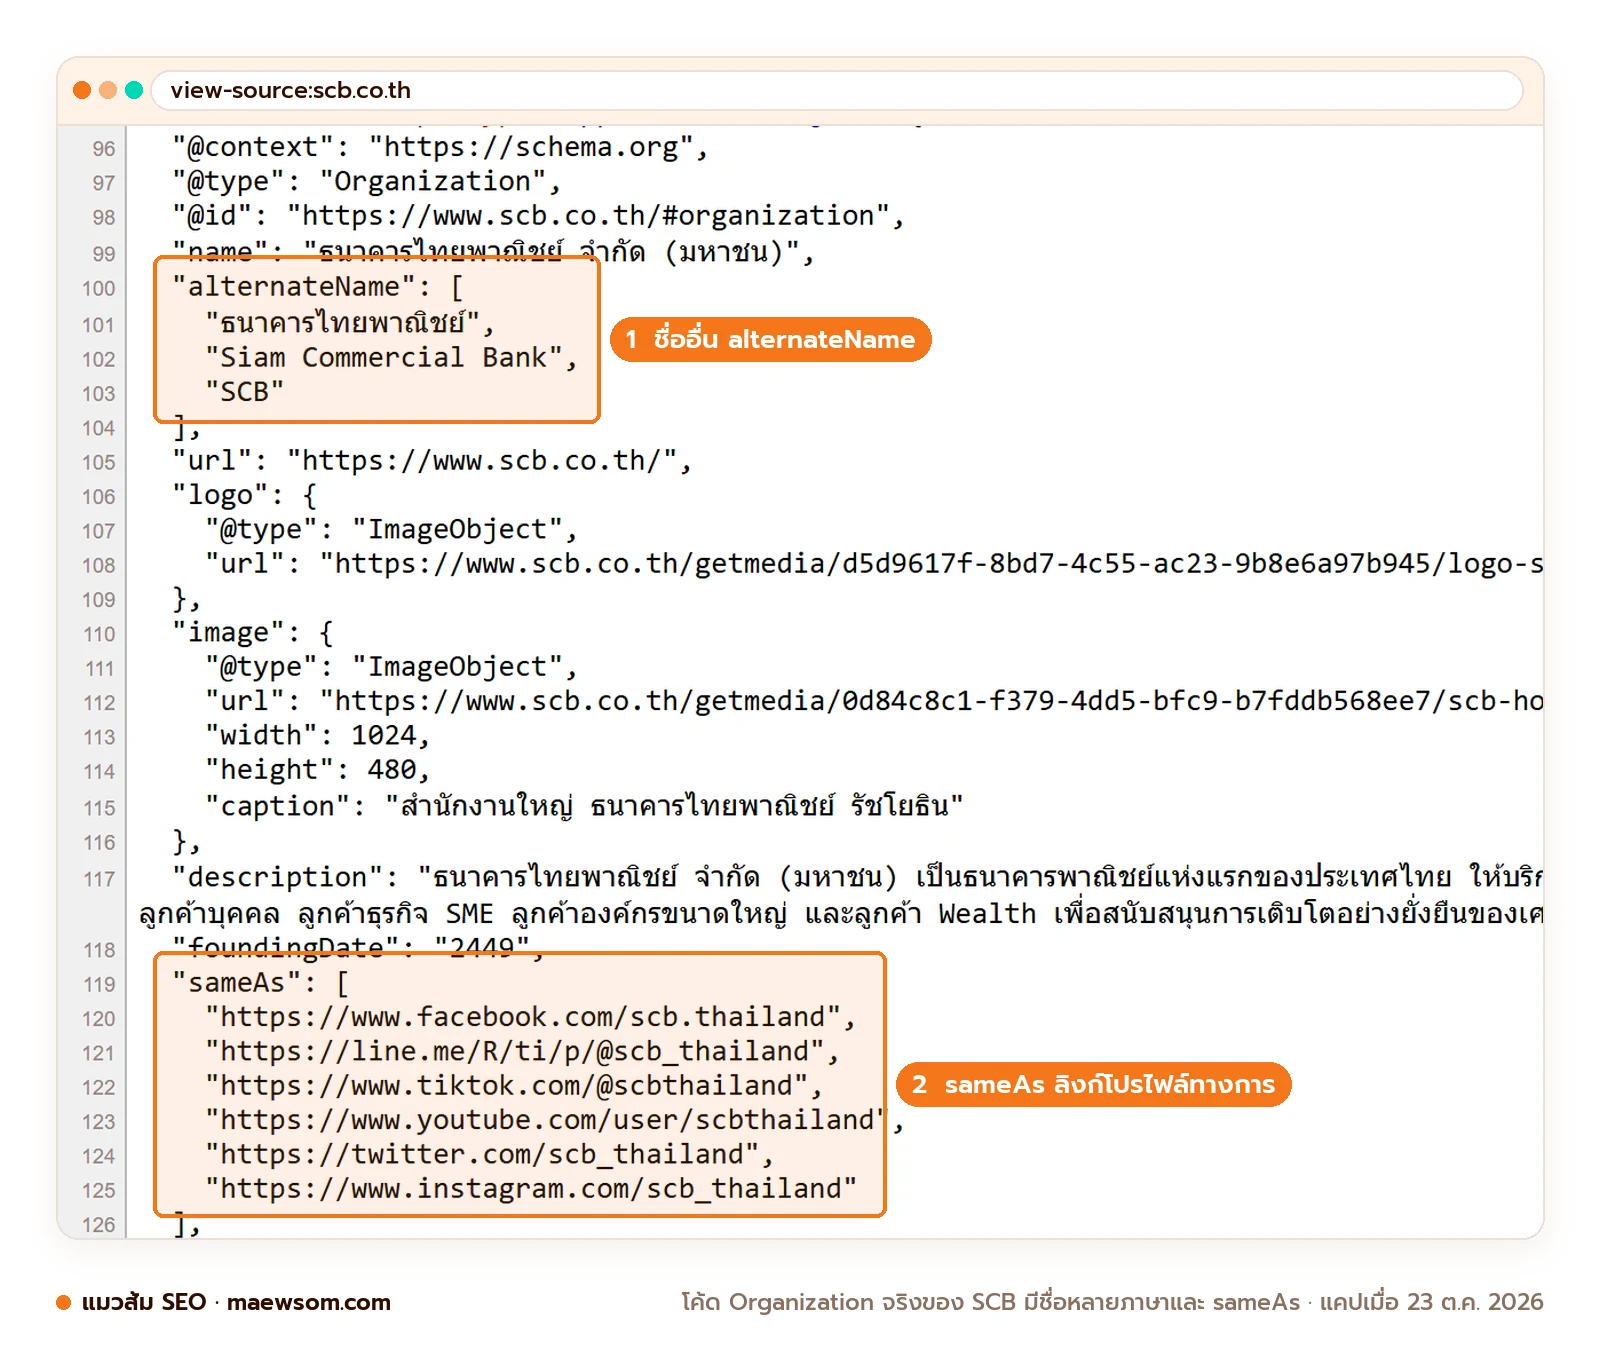
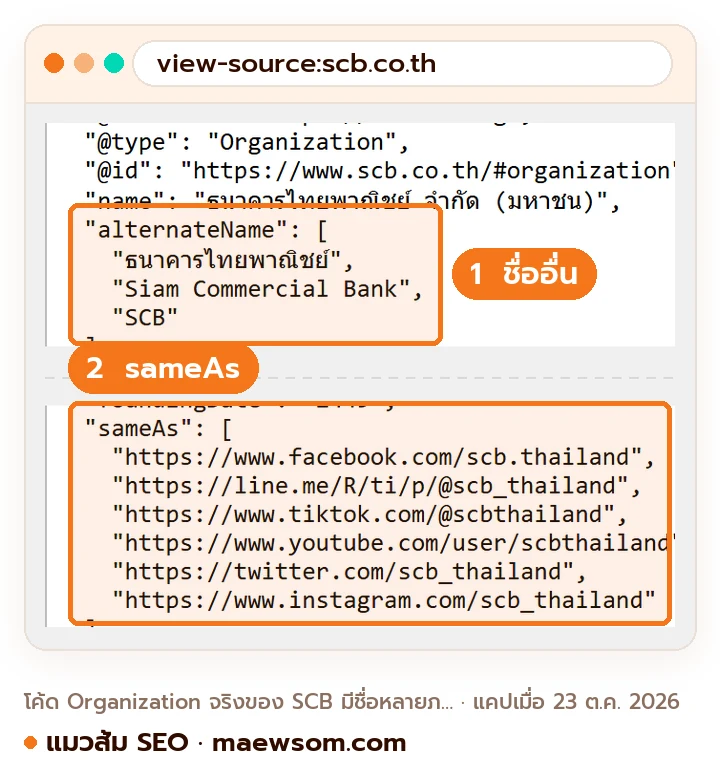
แมวส้มชอบตัวอย่างในภาพนี้ เพราะเป็นแบรนด์ไทยที่ใส่ alternateName ครบทั้งชื่อไทย ชื่ออังกฤษ และชื่อย่อ ส่วน sameAs ก็ชี้ไปที่เพจทางการ ตรงกับหลักที่ว่าใส่เฉพาะบัญชีที่ “เป็น” แบรนด์จริง
อยากดูตัวอย่าง schema ครบชุด อ่านต่อที่ Schema สำหรับ AI Search ใช้ markup แบบไหน
4. Google Business Profile ถ้ามีหน้าร้านหรือพื้นที่ให้บริการ
ถ้าคุณมีหน้าร้านหรือพื้นที่ให้บริการ เช่น ช่างแอร์ คลินิก ร้านอาหาร แมวส้มว่า Google Business Profile คืองานแรกที่ควรทำ เพราะคุณแก้ข้อมูลเองได้
หน้าช่วยเหลือของ knowledge panel ก็แนะนำให้ใช้ Google Business Profile เหมือนกัน
ไกด์ AI ของ Google (อัปเดต 10 ก.ค. 2026) เขียนว่า Merchant Center (ระบบลงสินค้าเพื่อขายผ่าน Google) และ Google Business Profile ช่วยให้สินค้าและบริการโผล่ทั้งในคำตอบของ AI และในผลค้นหาส่วนอื่น
ข้อมูลในโปรไฟล์ต้องตรงกับหน้า About ทุกตัวอักษร ผิดจุดเดียว ระบบก็ลังเลได้
5. ถูกพูดถึงจากแหล่งภายนอกที่น่าเชื่อถือ แบบของจริง
ชมตัวเองว่าทำอาหารอร่อย ยังไงก็สู้เพื่อนบ้านมาชมไม่ได้ ระบบก็เหมือนกัน จะมั่นใจขึ้นเมื่อคนอื่นพูดถึงคุณด้วยข้อมูลที่ตรงกัน
ตัวอย่างเช่น สื่อเขียนรีวิว สมาคมการค้ามีรายชื่อสมาชิก งานสัมมนาลงชื่อวิทยากร
ไกด์ของ Google เตือนตรงๆ ว่าการไล่ปั๊มชื่อตัวเองตามเว็บต่างๆ แบบไม่จริงไม่ช่วยอย่างที่คิด เพราะระบบ AI ของ Google Search ก็มีด่านกันสแปม (เนื้อหาขยะที่ทำมาหลอกระบบ) เหมือนกัน
เอาจริง ๆ ข้อนี้เป็นข้อที่คุณคุมเองได้น้อยที่สุด แมวส้มมองว่านั่นแหละคือเหตุผลที่มันมีค่า ของที่ปั๊มเองไม่ได้ก็ปลอมยาก ทางที่ได้ผลกว่าคือทำเรื่องจริงที่สื่อหรือสมาคมอยากหยิบไปพูดต่อ แล้วให้ทุกที่ใช้ชื่อชุดเดียวกับข้อ 1
6. Wikidata ทำได้ไหม แมวส้มขอพูดตรงๆ
Wikidata คือฐานความรู้แบบเปิดของวิกิมีเดีย (มูลนิธิเจ้าของ Wikipedia) ที่ใครก็แก้ได้ แต่มีเกณฑ์ว่าเรื่องไหน “เด่นพอจะมีรายการ” รายการต้องผ่านอย่างน้อย 1 ใน 3 ข้อนี้
- มีลิงก์ที่ถูกต้องไปยังหน้าในโครงการวิกิมีเดีย เช่น Wikipedia
- ระบุตัวตนได้ชัด และมีแหล่งอ้างอิงที่ “จริงจังและเป็นสาธารณะ” อธิบายได้
- จำเป็นต่อโครงสร้าง เช่น ต้องมีรายการนี้ ข้อมูลในรายการอื่นถึงจะใช้ได้
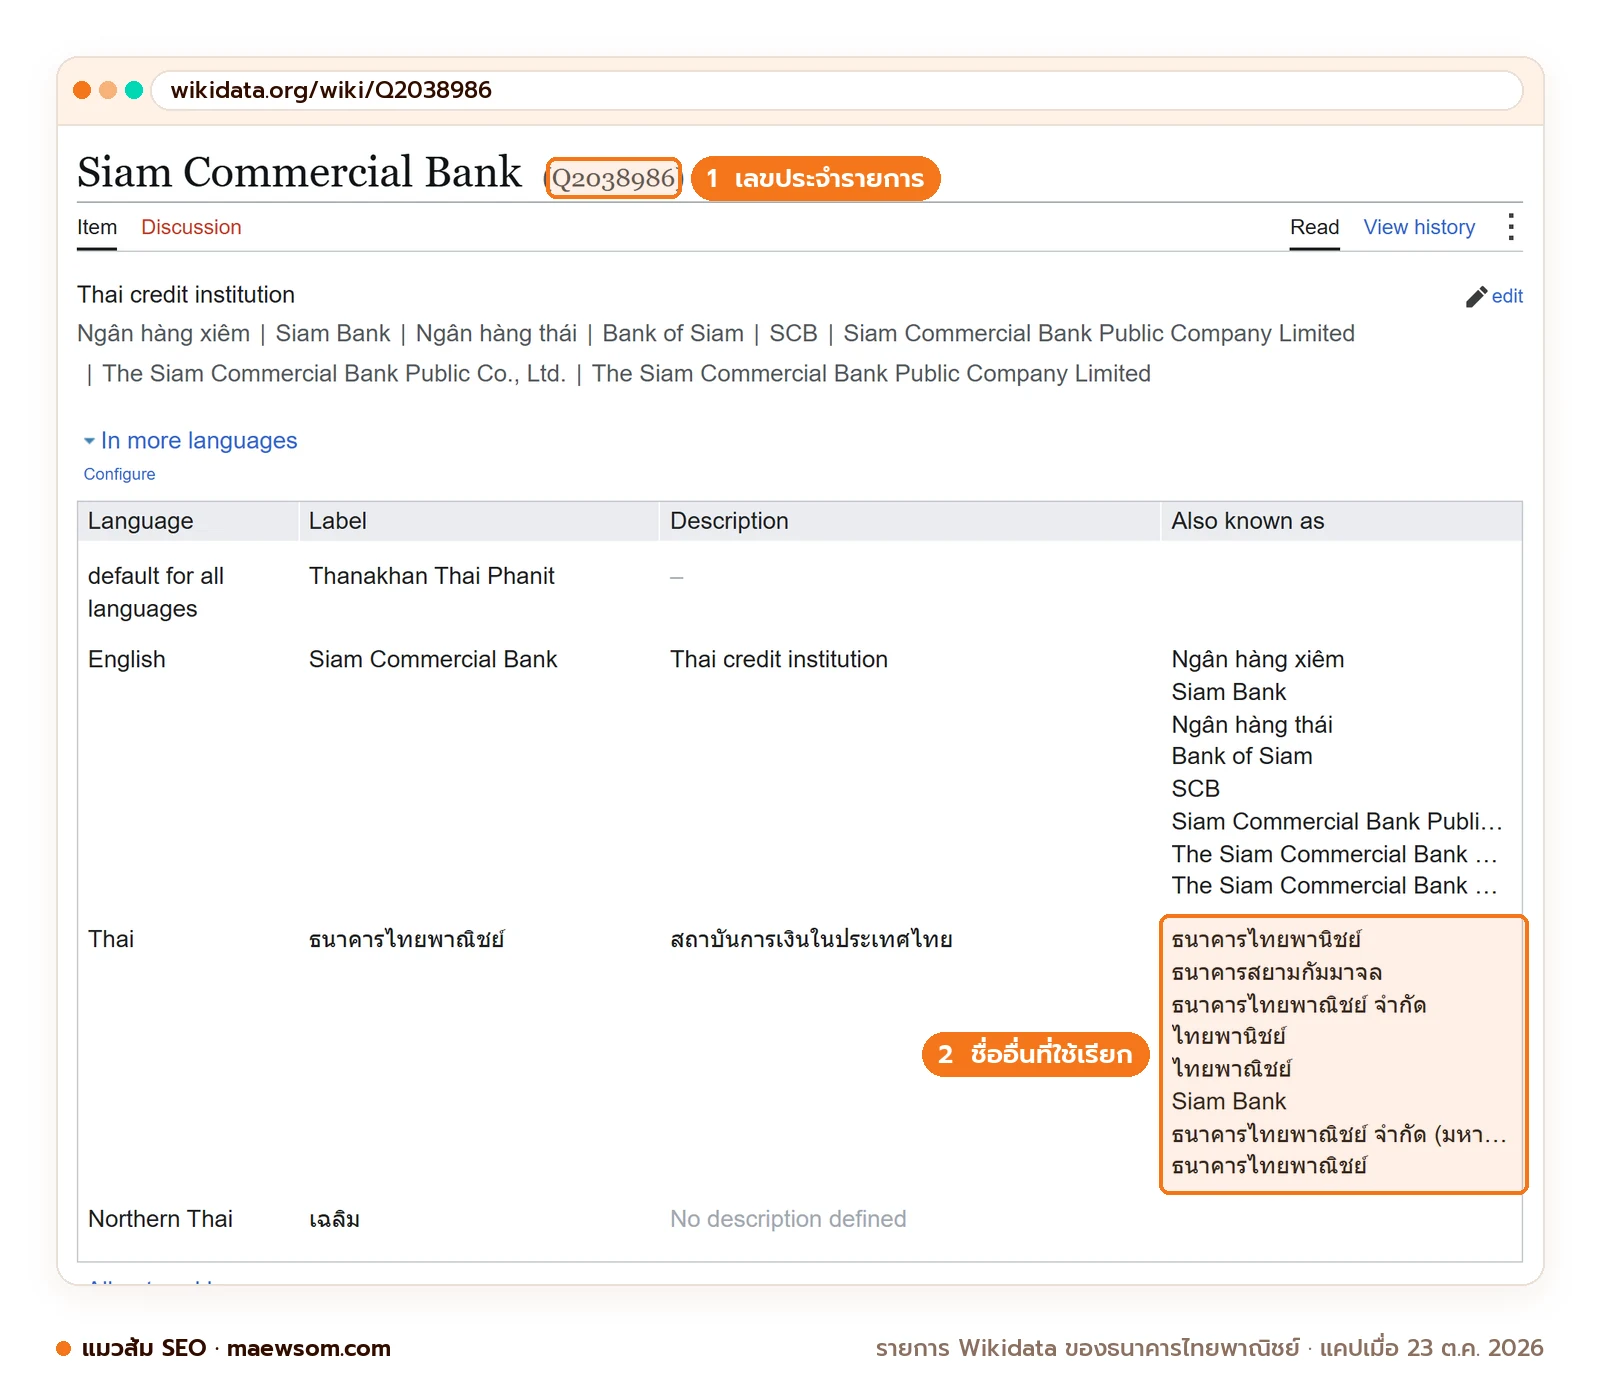
หน้านโยบายบอกเองว่าเกณฑ์ไม่ตายตัว ถ้าเห็นต่างกันให้เปิดคำขอลบ และชุมชนเป็นคนตัดสินเสมอ ณ วันที่เขียนยังมีการเปิดอภิปรายเรื่องปฏิรูปนโยบายนี้อยู่ เกณฑ์จึงอาจเปลี่ยน
สรุปแบบบ้านๆ ถ้าแหล่งอ้างอิงมีแค่เว็บกับเพจของตัวเอง รายการเสี่ยงโดนลบ รู้ว่าอยากมีเร็วๆ แต่ทำข้อ 1-5 ให้แน่นก่อน รอให้มีแหล่งสาธารณะพูดถึงจริง แล้วค่อยมา Wikidata
ถ้าให้แมวส้มเลือกระหว่างรีบสร้างรายการ Wikidata วันนี้ กับรอให้มีแหล่งสาธารณะพูดถึงก่อน แมวส้มเลือกรอ เพราะรายการที่โดนลบไปแล้วไม่ได้ช่วยอะไร ส่วนงานข้อ 1-5 ที่ทำระหว่างรอก็ไม่สูญเปล่าเลยสักข้อ
ทำครบทุกข้อแล้ว คำถามที่ตามมาก็คือ แล้วงานทั้งหมดนี้ช่วยเรื่องคำตอบของ AI ได้จริงไหม ไปดูกันต่อครับ
ทำไม Entity SEO สำคัญกับคำตอบของ AI
Entity SEO สำคัญกับคำตอบของ AI เพราะ AI มักเอ่ยชื่อแบรนด์ คน และสินค้าตรงๆ ถ้าระบบแยกไม่ออกว่าชื่อคุณคือใคร AI อาจไม่พูดถึงคุณเลย หรือเอาข้อมูลบริษัทชื่อคล้ายมาปน
ลองคิดสภาพว่า.. มีคลินิกทำฟันชื่อคล้ายกันสองแห่ง แห่งหนึ่งอยู่เชียงใหม่ อีกแห่งอยู่บางนา ทั้งคู่สะกดชื่อไม่นิ่ง และหน้า About ไม่บอกที่ตั้งชัด
AI อาจบอกคนบางนาว่าคลินิกเปิดวันอาทิตย์ ทั้งที่เป็นเวลาของสาขาเชียงใหม่ คนไข้เสียเที่ยว คลินิกเสียลูกค้า และไม่มีใครรู้ว่าต้นเหตุคือชื่อสะกดไม่ตรงกัน
Entity SEO จึงเป็นงานกันความสับสนก่อน แล้วค่อยเป็นงานเพิ่มการมองเห็น อยากรู้ว่า AI หยิบข้อมูลมาตอบยังไง อ่าน AI Search ทำงานยังไง ประกอบได้
แต่ต้องพูดให้ครบ หน้า AI features ของ Google เขียนว่าไม่มีการปรับแต่งพิเศษที่จำเป็นสำหรับ AI Overviews (กล่องสรุปคำตอบด้วย AI) และ AI Mode (โหมดแชตของ Google)
ไกด์ AI ของ Google (อัปเดต 10 ก.ค. 2026) มีเงื่อนไขเทคนิคเพิ่มข้อเดียว คือเว็บต้องไม่ถูกตั้งเป็น Exclude ในการตั้งค่า Search generative AI ของ Search Console (ค่าเริ่มต้นคือ Include อยู่แล้ว หรือ Inherit ถ้า property มีตัวแม่) และไกด์นี้ไม่พูดถึง entity เลย
ดังนั้นสัญญาณในบทความนี้คือพื้นฐาน SEO ที่ทำให้ข้อมูลแบรนด์ตรงกัน ไม่ใช่สูตรลับให้ติด AI
แมวส้มชอบที่ Google พูดตรง ๆ แบบนี้ ถ้ามีใครบอกว่าต้องทำ entity แบบพิเศษเพื่อ AI Overviews ให้ถามกลับว่าอ้างจากเอกสารไหน สิ่งที่แมวส้มเอาไปใช้จริงคือ มองงาน entity เป็นงานกันข้อมูลผิด ไม่ใช่สูตรไล่ตำแหน่งในคำตอบของ AI
ส่วน ChatGPT, Perplexity และ Gemini ให้น้ำหนักเรื่องนี้แค่ไหน ณ ต.ค. 2026 แมวส้มยังไม่พบเอกสารทางการจากเจ้าไหนที่อธิบายละเอียด วิธีที่ซื่อสัตย์คือทดสอบเองตาม 3 ขั้นนี้
- เตรียมคำถาม 5 แบบ เช่น “บ้านส้มคั่วคือร้านอะไร”, “โรงคั่วกาแฟในอารีย์มีที่ไหนบ้าง”
- ถามใน ChatGPT, Gemini, Perplexity และ Google แล้วจดว่าคำตอบเอ่ยชื่อคุณไหม ข้อมูลถูกไหม อ้างแหล่งไหน
- แก้ข้อมูลที่ไม่ตรงกัน แล้วถามชุดเดิมซ้ำทุกเดือน
วิธีวัดแบบเป็นระบบกว่านี้ อยู่ใน AI Visibility คืออะไร วิธีวัดว่าแบรนด์ถูกพูดถึงใน AI แค่ไหน
รู้แล้วว่าทำไปเพื่ออะไร ทีนี้มารวบทุกข้อไว้ในหน้าเดียว จะได้หยิบไปเช็กได้ทันที
เช็กลิสต์ Entity SEO สำหรับแบรนด์ไทย
เช็กลิสต์ Entity SEO มี 7 ข้อ คือชื่อไทยอังกฤษชุดเดียว หน้า About, schema + sameAs, Google Business Profile, ผู้เขียนตัวจริง คนนอกพูดถึง และ Wikidata เมื่อผ่านเกณฑ์
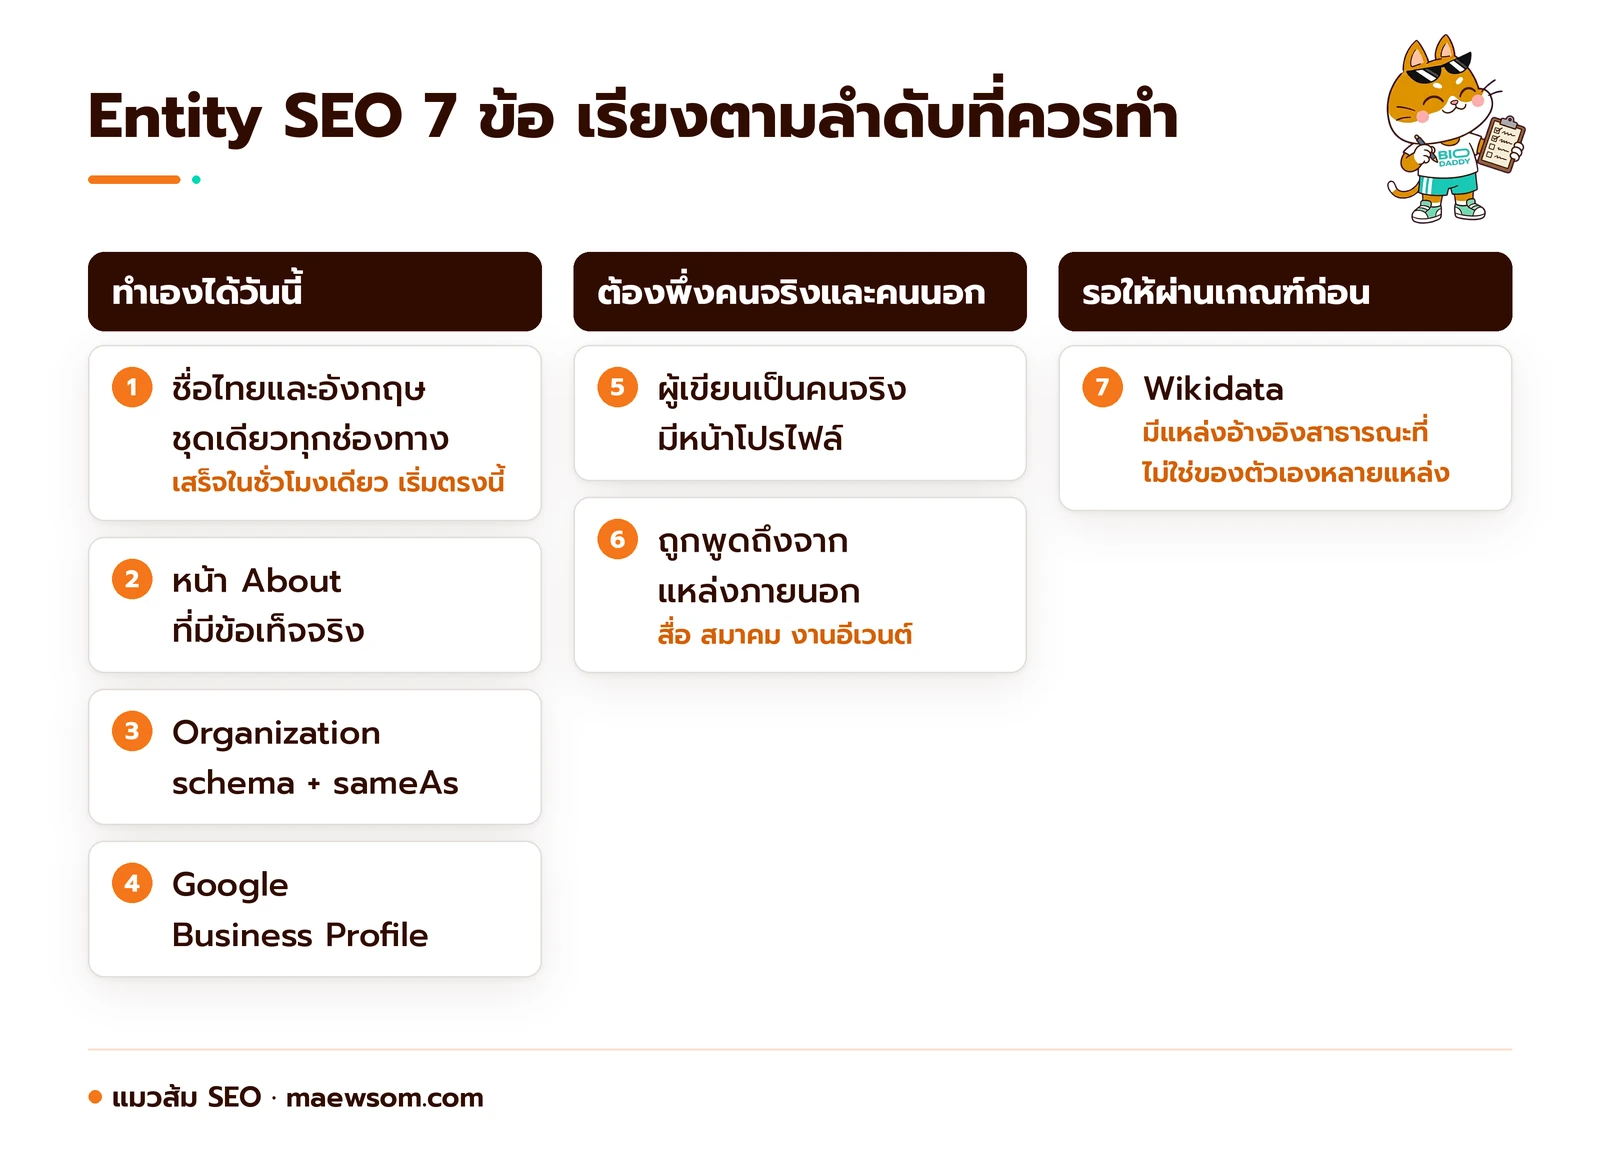
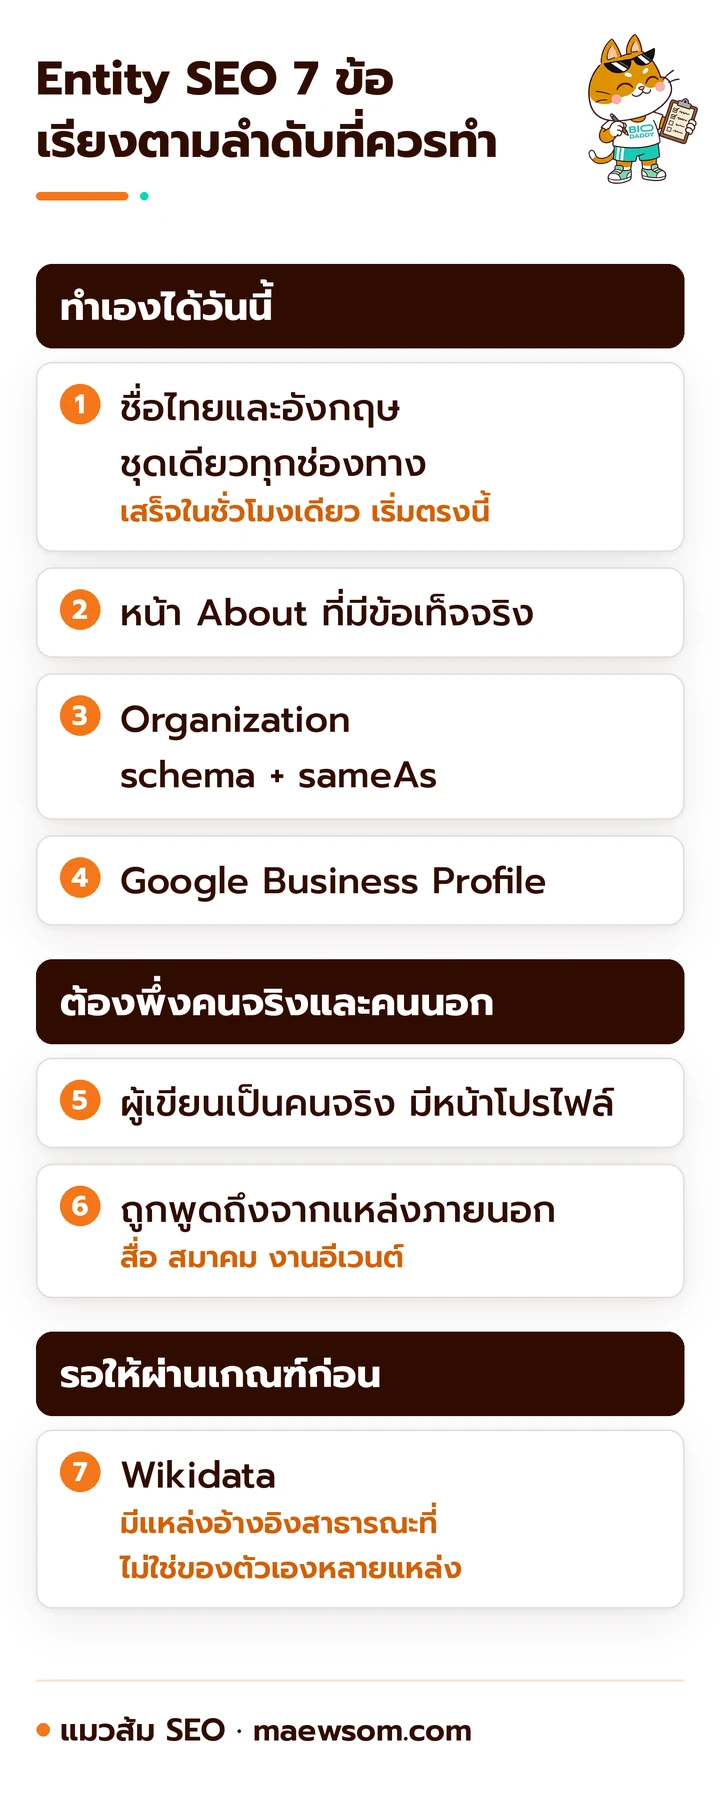
ข้อแรกทำเสร็จได้ในชั่วโมงเดียว เริ่มตรงนั้นเลย ตารางข้างล่างบอกว่าแต่ละข้อทำที่ไหน และเช็กยังไง
| สัญญาณ | ทำที่ไหน | เช็กยังไง |
|---|---|---|
| ชื่อไทย/อังกฤษชุดเดียว | ทุกช่องทาง | ไล่เปิดทุกโปรไฟล์ จดชื่อลงตาราง ต้องเหมือนกันทุกช่อง |
| หน้า About มีข้อเท็จจริง | เว็บตัวเอง | มีชื่อสองภาษา ประเภทธุรกิจ ปีก่อตั้ง ชื่อบริษัท ที่ตั้ง ครบไหม |
| Organization schema + sameAs | หน้าแรกหรือหน้า About | วางลิงก์หน้าใน Rich Results Test หรือ Schema Markup Validator (เครื่องมือตรวจ schema ฟรี) |
| Google Business Profile | business.google.com | ยืนยันตัวตนแล้ว ชื่อไม่ยัดคำค้นหรือซ้ำสองภาษา ชื่อ ที่อยู่ เบอร์ ตรงกับเว็บ |
| ผู้เขียนเป็นคนจริง | หน้าบทความ | มีชื่อ หน้าโปรไฟล์ และช่องผู้เขียน (author) ใน Article schema |
| ถูกพูดถึงจากแหล่งนอก | สื่อ สมาคม งานอีเวนต์ | ค้นชื่อแบรนด์ในเครื่องหมายคำพูด ไม่นับเว็บตัวเอง |
| Wikidata (ถ้าผ่านเกณฑ์) | wikidata.org | มีแหล่งอ้างอิงสาธารณะที่ไม่ใช่ของตัวเองหลายแหล่ง |
พอไล่ดูครบทั้งตาราง แมวส้มมองว่าลำดับสำคัญพอ ๆ กับตัวข้อ ถ้ารีบสร้าง Wikidata ทั้งที่ชื่อในเว็บกับเพจยังไม่ตรงกัน ก็เท่ากับเอาข้อมูลที่ยังสับสนไปฝากไว้อีกที่หนึ่ง
เรื่องผู้เขียนเป็นคนจริงเกี่ยวกับความน่าเชื่อถือโดยตรง อ่านต่อที่ E-E-A-T คืออะไร 4 สัญญาณความน่าเชื่อถือ
คำถามที่พบบ่อย
แหล่งอ้างอิง
- How Google’s Knowledge Graph works โดย Google Knowledge Panel Help (ตรวจเมื่อ ต.ค. 2026)
- Get verified on Google โดย Google Knowledge Panel Help (ตรวจเมื่อ ต.ค. 2026)
- Guidelines for representing your business on Google โดย Google Business Profile Help (ตรวจเมื่อ ต.ค. 2026)
- Wikidata:Notability โดย Wikidata (ตรวจเมื่อ ต.ค. 2026)
- Google Knowledge Graph Search API (Enterprise Knowledge Graph) โดย Google Cloud (อัปเดต ต.ค. 2026)
- sameAs โดย Schema.org (เวอร์ชัน 30.1) (อัปเดต ก.ย. 2026)
- Organization structured data โดย Google Search Central (อัปเดต ก.ย. 2026)
- Google’s guide to optimizing for generative AI features on Google Search โดย Google Search Central (อัปเดต ก.ค. 2026)
- AI features and your website โดย Google Search Central (อัปเดต ธ.ค. 2025)
- Google Knowledge Graph Search API โดย Google for Developers (อัปเดต เม.ย. 2024)
- A reintroduction to our Knowledge Graph and knowledge panels โดย News from Google (Danny Sullivan) (อัปเดต พ.ค. 2020)
- Introducing the Knowledge Graph: things, not strings โดย News from Google (Amit Singhal) (อัปเดต พ.ค. 2012)
เขียนโดย
แมวส้มคือมาสคอตของทีม BIQDADDY เอเจนซี SEO และ AISO ในไทย เล่าเรื่อง AI SEO, GEO และ AEO แบบเข้าใจง่าย บทความเขียนด้วยระบบ AI ตามมาตรฐานของทีม ตรวจข้อเท็จจริงกับแหล่งต้นทาง และผ่านผู้ตรวจ AI อิสระก่อนเผยแพร่ ทีม BIQDADDY เป็นผู้ดูแลเว็บและแก้ไขเมื่อมีผู้แจ้งข้อผิดพลาด อ่านนโยบายการเขียน
เรียบเรียงเนื้อหาโดย วุฒิภัทร อุณหะกะ Co-Founder และ COO ของ BIQDADDY
อ่านต่อกับแมวส้ม
ChatGPT แปลภาษา และ AI ตัวอื่น แปลบทความเว็บยังไงไม่ให้เสีย SEO พร้อมเช็กลิสต์ hreflang และ 5 prompt
ChatGPT API (OpenAI API) คืออะไร ขอ API key ราคาแต่ละโมเดล และสคริปต์ทำ SEO
Gemini สร้างรูปยังไง วิธีใช้และแต่งรูปทีละขั้น ฟรีได้แค่ไหน ลายน้ำ SynthID และสิทธิ์ภาพ