สารบัญ
Fine-tuning คืออะไร ต้องปรับจูน AI ไหมถึงจะติด AI Search
สวัสดีครับ แมวส้มเองครับ มีคนถามบ่อยมากว่า “ต้อง fine-tune AI ให้รู้จักแบรนด์ไหม ถึงจะติด ChatGPT” วันนี้ตอบให้ชัดๆ เลย
Fine-tuning คือการเอาโมเดล AI (ตัวสมองของ AI) ที่ฝึกมาแล้วไปฝึกต่อด้วยชุดตัวอย่างของเราเอง ให้มันตอบตามรูปแบบ น้ำเสียง หรืองานเฉพาะทางได้สม่ำเสมอ ภาษาไทยเรียกว่า “การปรับจูนโมเดล” หรือ “การฝึกโมเดลเพิ่ม”
ผลที่ได้คือโมเดลเวอร์ชันของคุณเอง ซึ่งใช้ได้เฉพาะในระบบของคุณ จำประโยคนี้ไว้ก่อนนะ เพราะมันคือคำตอบของคำถามข้างบน
Fine-tuning เปรียบง่ายๆ เหมือนอะไร
Fine-tuning เหมือนการฝึกพ่อครัวมือดีให้ทำตามสูตรร้านจนชิน สมมติพ่อครัวทำอาหารไทยเป็นทุกอย่างอยู่แล้ว แต่ร้านคุณมีสูตรผัดกะเพราเฉพาะตัว
คุณเลยให้เขาทำตามสูตรซ้ำๆ เป็นร้อยจาน จนรสเดิมทุกจานโดยไม่ต้องเปิดสูตรดู นั่นคือ fine-tuning
ส่วนการแปะการ์ดสูตรไว้ข้างเตาทุกครั้งที่ทำ คือการใส่ตัวอย่างในพรอมต์ (ข้อความที่เราสั่ง AI) แบบนี้ถูกกว่าและเริ่มได้ทันที
ทำไม Fine-tuning ถึงไม่ใช่ทางลัดสู่ AI search
เพราะ fine-tuning เปลี่ยนแค่โมเดลที่คุณใช้เอง ไม่ได้เปลี่ยนโมเดลของ Google หรือ ChatGPT ที่ลูกค้าใช้ค้นหา
คำตอบของ AI search (AI ที่ค้นเว็บแล้วตอบให้) ที่ลิงก์มาหาเว็บคุณ มาจากการค้นเว็บสดๆ ตอนลูกค้าถาม ไม่ได้มาจากการที่ใครเอาเว็บคุณไปฝึกโมเดล
คู่มือ AI ของ Google (อัปเดต 10 ก.ค. 2026) อธิบายว่าระบบใช้ระบบจัดอันดับของ Search ดึงหน้าเว็บที่เกี่ยวข้องและสดใหม่จากดัชนี (สมุดรายชื่อหน้าเว็บที่ Google เก็บไว้) มาประกอบคำตอบ
เพราะแบบนี้ งานที่ช่วยให้ติด AI search จึงยังเป็น SEO (ติดอันดับ Google) AEO และ GEO (ให้ AI หยิบไปตอบและอ้างถึง) ไม่ใช่การจ้างคนมา fine-tune
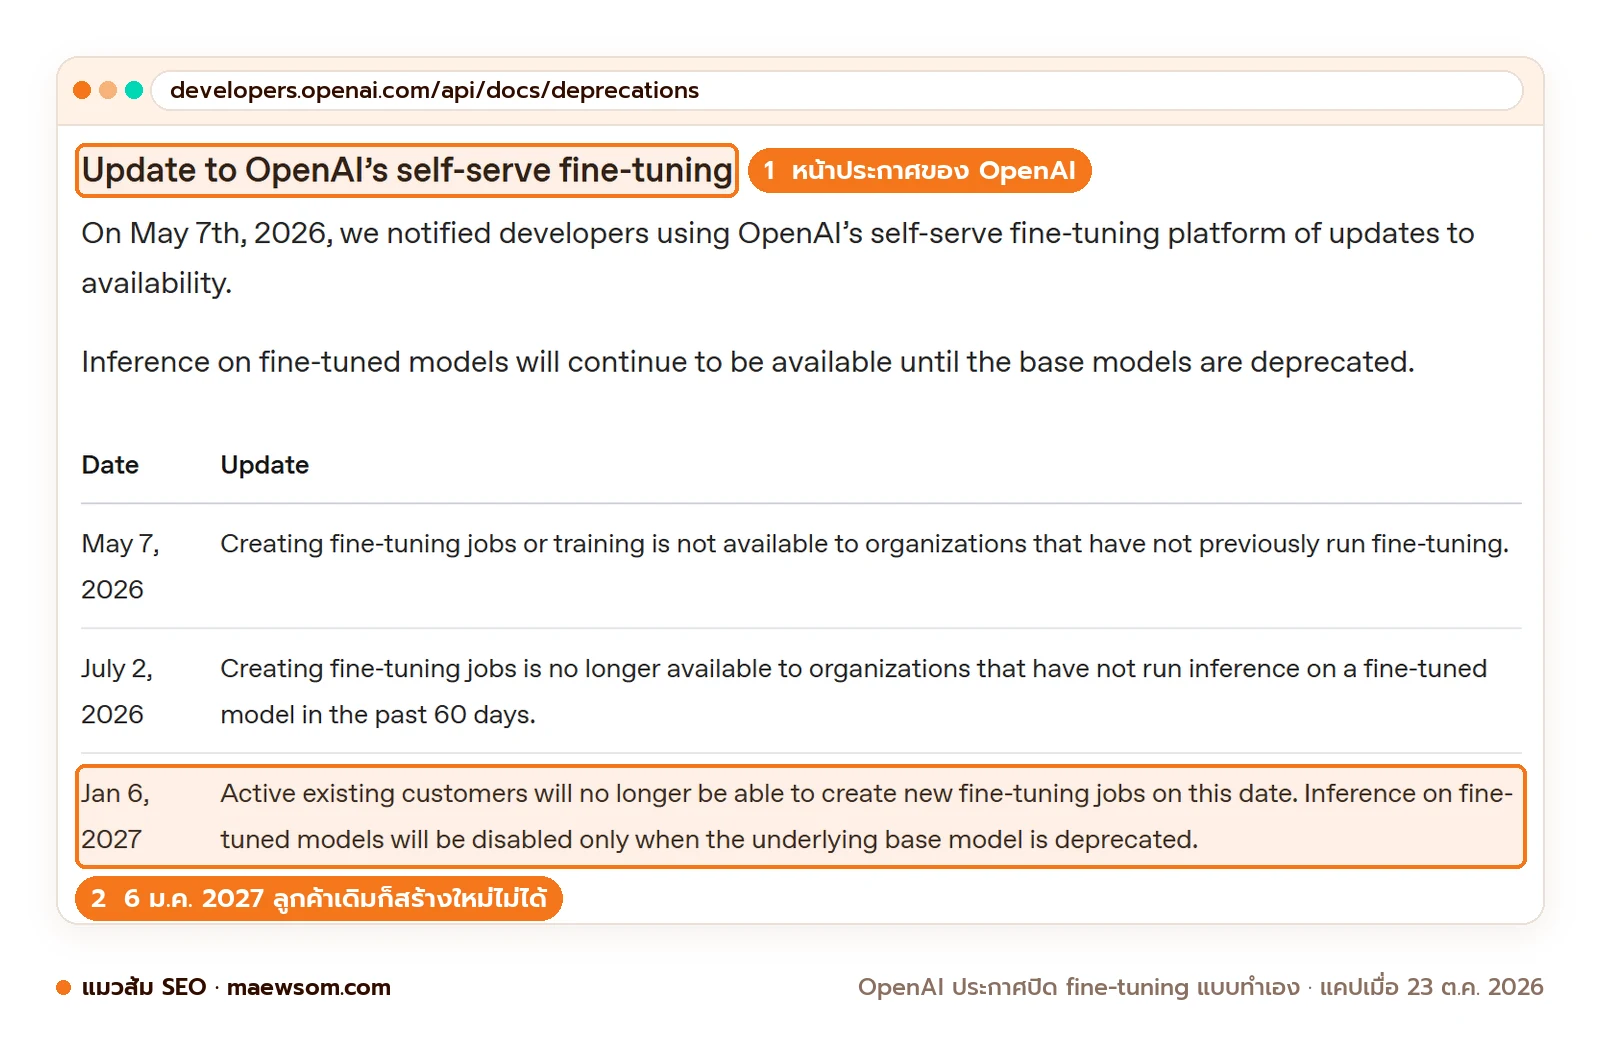
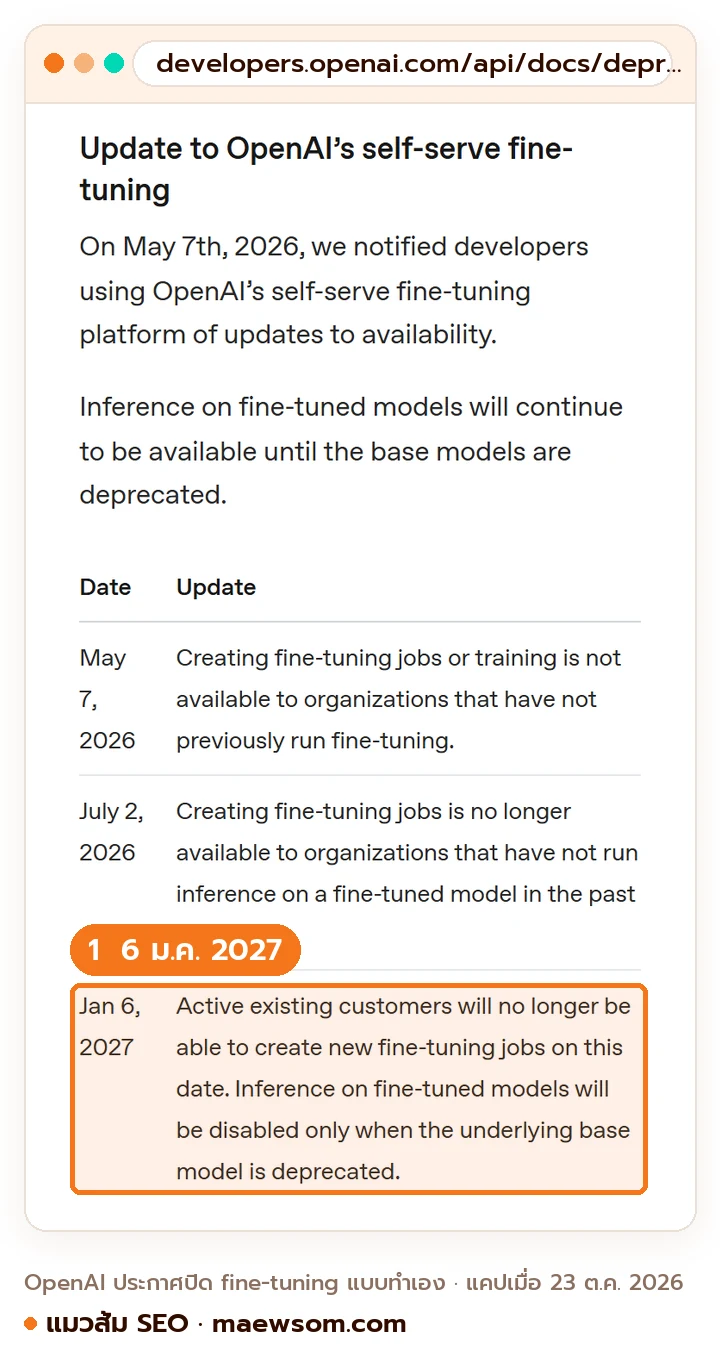
ทีนี้มีข่าวที่คนทำงานกับ AI ควรรู้อีกเรื่อง OpenAI กำลังปิดระบบ fine-tuning แบบที่ลูกค้ากดทำเองได้ หน้าการยกเลิกบริการของ OpenAI ระบุไทม์ไลน์ไว้ 3 ช่วง
- 7 พ.ค. 2026 องค์กรที่ไม่เคยทำ fine-tuning มาก่อน สร้างงาน fine-tuning ใหม่ไม่ได้แล้ว
- 2 ก.ค. 2026 องค์กรที่ไม่ได้ใช้โมเดล fine-tuned เลยใน 60 วันที่ผ่านมา สร้างงานใหม่ไม่ได้
- 6 ม.ค. 2027 ลูกค้าเดิมที่ยังใช้อยู่ก็สร้างงานใหม่ไม่ได้ ส่วนโมเดลที่ fine-tune ไว้แล้วยังเรียกใช้ได้จนกว่าโมเดลฐาน (โมเดลต้นแบบที่เอามาฝึกต่อ) จะถูกปลด
ฝั่ง Google Cloud (บริการเช่าเครื่องและ AI ของ Google) ยังมี supervised fine-tuning (ฝึกด้วยตัวอย่างคำถามคู่คำตอบ) สำหรับโมเดล Gemini ให้ใช้ แต่ต้องตั้งโปรเจกต์บนคลาวด์และเตรียมข้อมูลเอง ซึ่งไม่ใช่งานที่เจ้าของร้านออนไลน์ส่วนใหญ่ต้องทำ
ข่าวดีคือ เจ้าของร้านออนไลน์ส่วนใหญ่ไม่ต้องไปถึงตรงนั้นเลย ถอนหายใจโล่งอกได้
Fine-tuning มีกี่แบบ
Fine-tuning มี 4 แบบหลัก ตามที่เอกสารของ OpenAI แบ่งไว้
| แบบ | ฝึกยังไง | เหมาะกับ |
|---|---|---|
| Supervised fine-tuning (SFT) | ให้ดูตัวอย่างคำถามคู่กับคำตอบที่ถูก | รูปแบบคำตอบตายตัว จัดหมวดหมู่ แปลแบบมีศัพท์เฉพาะ |
| Direct preference optimization (DPO) | ให้ดูคู่คำตอบดีกับไม่ดีของคำถามเดียวกัน | น้ำเสียงและสไตล์ การสรุปให้ตรงจุด |
| Reinforcement fine-tuning (RFT) | ให้ตัวตรวจคะแนนคำตอบ แล้วเสริมแนวคิดที่ได้คะแนนสูง | งานเฉพาะทางที่ต้องใช้เหตุผล |
| Vision fine-tuning | ฝึกด้วยรูปภาพ | จำแนกรูป งานที่ต้องเข้าใจภาพ |
ลองแบบที่ถูกกว่าก่อน วันนี้เลย
สมมติเอเจนซีต้องเขียนคำอธิบายสินค้าให้ร้านเครื่องสำอาง 300 ชิ้นด้วยน้ำเสียงเดียวกัน ก่อนคิดถึง fine-tuning ลองทำ 4 ขั้นนี้
- เลือกคำอธิบายที่ดีที่สุดของร้าน 3 ถึง 5 ชิ้น ที่เจ้าของร้านชอบจริง
- เขียนพรอมต์ที่บอกกฎสั้นๆ เช่น ความยาว คำที่ห้ามใช้ แล้วแปะตัวอย่างทั้งหมดไว้ท้ายพรอมต์
- ให้ AI เขียน 10 ชิ้นใหม่ แล้วให้คนในทีมให้คะแนนว่าตรงน้ำเสียงไหม
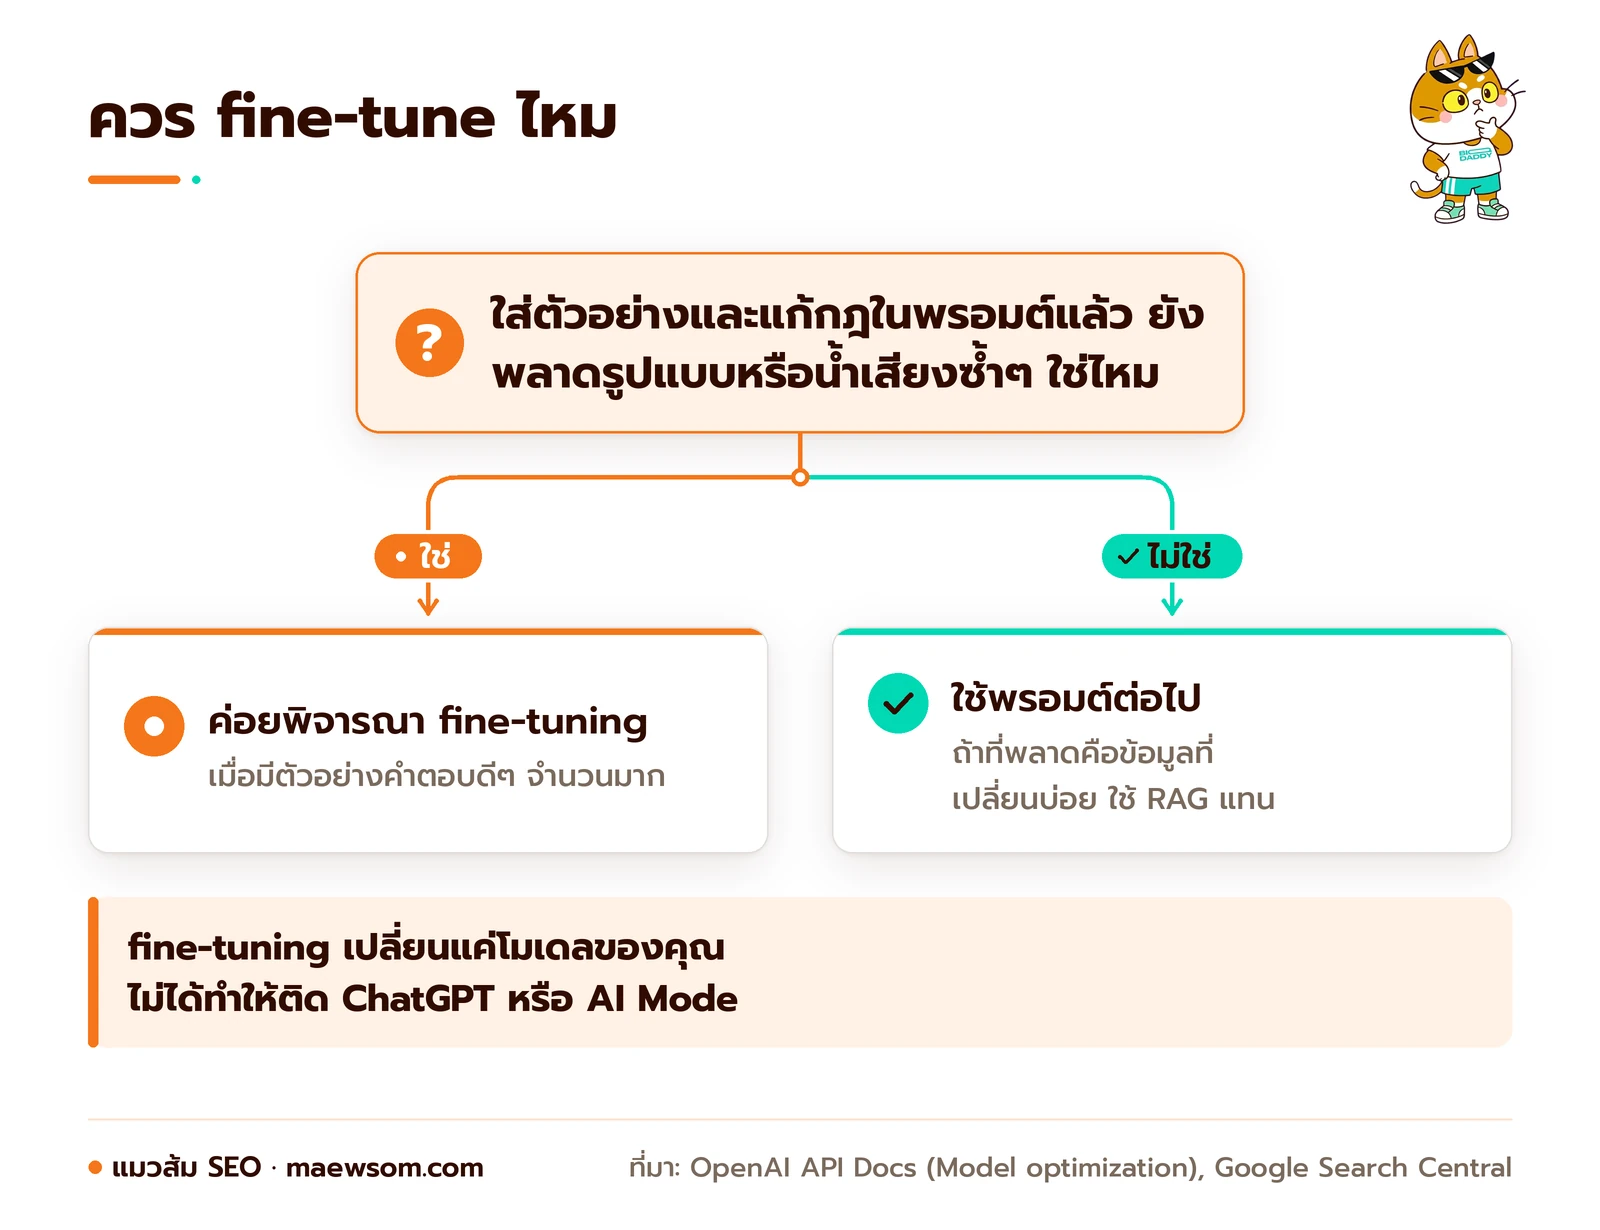
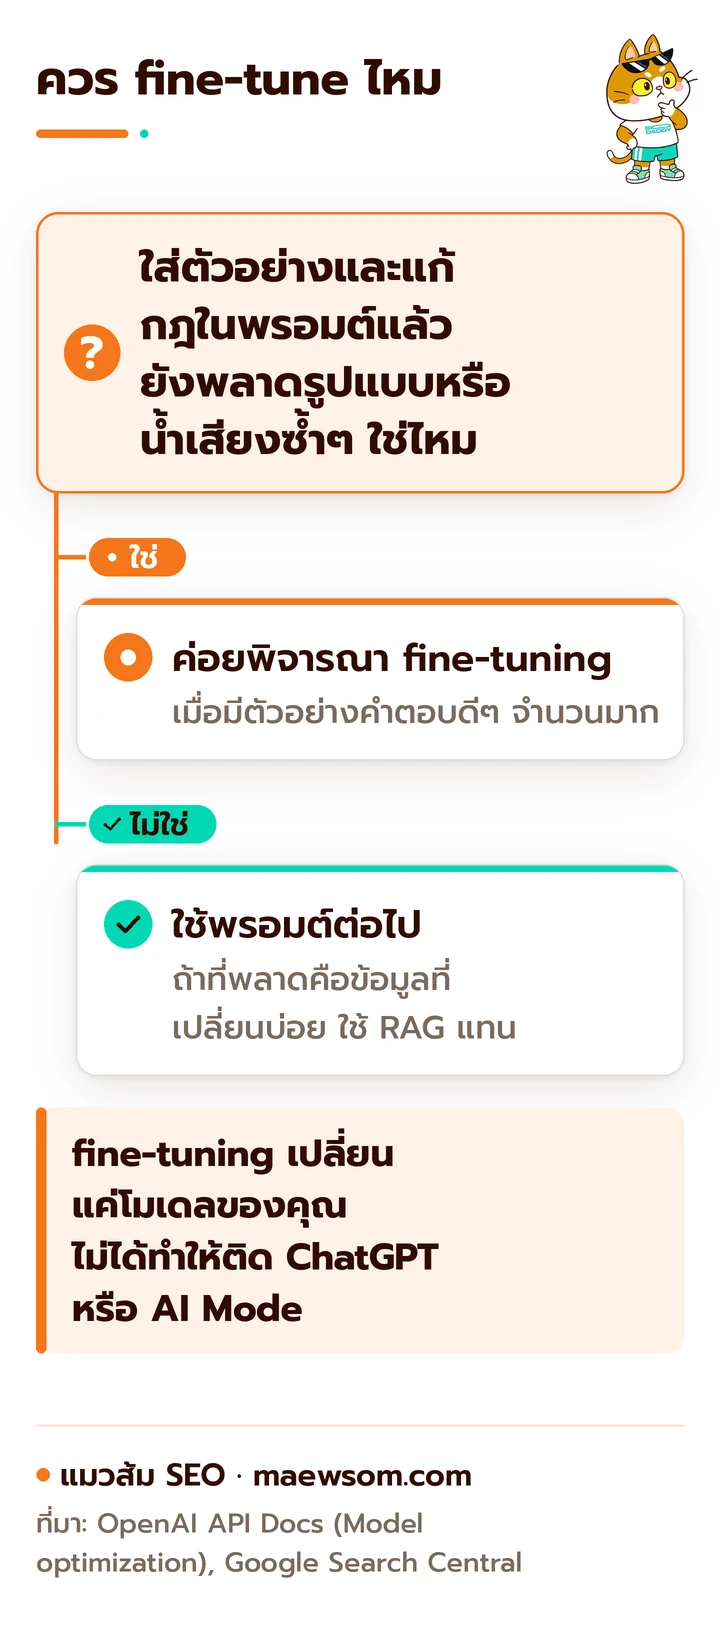
- ถ้าได้คะแนนดีเกือบทุกชิ้น คุณไม่ต้อง fine-tune ถ้าพลาดซ้ำจุดเดิม ให้แก้กฎในพรอมต์ก่อน ถ้าแก้กฎแล้วยังพลาดเรื่องรูปแบบหรือน้ำเสียงซ้ำๆ และมีตัวอย่างคำตอบดีๆ จำนวนมาก ตอนนั้นค่อยพิจารณา fine-tuning แต่ถ้าที่พลาดคือข้อมูลสินค้าที่เปลี่ยนบ่อย ทางแก้คือ RAG (ให้ AI ค้นข้อมูลล่าสุดก่อนตอบ) ไม่ใช่ fine-tuning
คำถามที่พบบ่อย
คำที่เกี่ยวข้อง
- RAG หรือ Retrieval-Augmented Generation
- Prompt Engineering ศิลปะการสั่งงาน AI
- Large Language Model (LLM) โมเดลที่ถูก fine-tune
- Grounding การยึดคำตอบไว้กับข้อมูลจริง
- อ่านต่อแบบเต็ม Prompt SEO ใช้ได้จริง สำหรับ ChatGPT Claude และ Gemini และ AI Search ทำงานยังไง
แหล่งอ้างอิง
- Deprecations: Update to OpenAI’s self-serve fine-tuning (OpenAI API Docs, ประกาศ 7 พ.ค. 2026)
- Model optimization (OpenAI API Docs, ตรวจ 20 ต.ค. 2026)
- About supervised fine-tuning for Gemini models (Google Cloud Documentation, ตรวจ 20 ต.ค. 2026)
- Optimizing your website for generative AI features on Google Search (Google Search Central, อัปเดต 10 ก.ค. 2026)
เขียนโดย
แมวส้มคือมาสคอตของทีม BIQDADDY เอเจนซี SEO และ AISO ในไทย เล่าเรื่อง AI SEO, GEO และ AEO แบบเข้าใจง่าย บทความเขียนด้วยระบบ AI ตามมาตรฐานของทีม ตรวจข้อเท็จจริงกับแหล่งต้นทาง และผ่านผู้ตรวจ AI อิสระก่อนเผยแพร่ ทีม BIQDADDY เป็นผู้ดูแลเว็บและแก้ไขเมื่อมีผู้แจ้งข้อผิดพลาด อ่านนโยบายการเขียน
เรียบเรียงเนื้อหาโดย วุฒิภัทร อุณหะกะ Co-Founder และ COO ของ BIQDADDY
อ่านต่อกับแมวส้ม
Reasoning Model คืออะไร AI ที่คิดก่อนตอบ เปลี่ยนวิธีค้นเว็บยังไง
ChatGPT Ads คืออะไร เปิดในไทยแล้ว ใครเห็น คิดเงินยังไง กระทบ SEO ไหม
Claude Desktop คืออะไร ดาวน์โหลดและติดตั้งบน Windows และ Mac ทำอะไรได้มากกว่าเว็บ