สารบัญ
Source Reconciliation คืออะไร AI ทำยังไงเมื่อแหล่งข้อมูลพูดไม่ตรงกัน
สวัสดีครับ วันนี้แมวส้มขอพาไปดูว่า AI ทำยังไง เวลาเว็บสองเว็บพูดไม่ตรงกัน
Source reconciliation คือขั้นตอนที่ระบบ AI เอาข้อมูลจากหลายแหล่งที่ค้นมาได้มาเทียบกัน แล้วตัดสินว่าจะรวมเข้าด้วยกัน เลือกเชื่อแหล่งไหน หรือบอกผู้ใช้ตรงๆ ว่าแหล่งเห็นไม่ตรงกัน ก่อนเขียนออกมาเป็นคำตอบเดียว ภาษาไทยเรียกได้ว่า “การกระทบยอดแหล่งข้อมูล” หรือ “การชั่งน้ำหนักแหล่งที่ขัดกัน”
บอกกันตรงๆ ก่อนนะ คำนี้ไม่ใช่ศัพท์ทางการที่ Google หรือ OpenAI ประกาศใช้ เป็นคำที่คนในวงการ SEO และ GEO ใช้เรียกกัน ส่วนฝั่งงานวิจัยจะเรียกปัญหาเดียวกันนี้ว่า knowledge conflicts หรือ “ข้อมูลขัดกัน”
Source reconciliation เปรียบง่ายๆ เหมือนอะไร
ลองนึกภาพคุณถามเพื่อนสามคนในแชตกลุ่มห้องว่า “ร้านข้าวมันไก่หน้าโรงเรียนเปิดกี่โมง” คนแรกบอก 6 โมง คนที่สองบอก 7 โมง คนที่สามส่งรูปป้ายหน้าร้านที่เพิ่งถ่ายเมื่อวาน เขียนว่า 6 โมงครึ่ง คุณจะเชื่อใคร ส่วนใหญ่ก็เชื่อรูปป้ายล่าสุดใช่ไหม การนั่งชั่งแบบนี้แหละคือ source reconciliation แค่ AI ทำกับหน้าเว็บเป็นสิบหน้าภายในไม่กี่วินาที
ทำไม source reconciliation สำคัญกับ SEO, AEO และ GEO
มันสำคัญเพราะถ้าข้อมูลของคุณบนเว็บต่างๆ ขัดกันเอง AI อาจเลือกเวอร์ชันที่ผิด หรือตัดคุณทิ้งไปใช้แหล่งอื่นที่ข้อมูลนิ่งกว่า งานวิจัยสองชิ้นนี้ช่วยให้เห็นภาพว่า AI ชั่งน้ำหนักยังไง
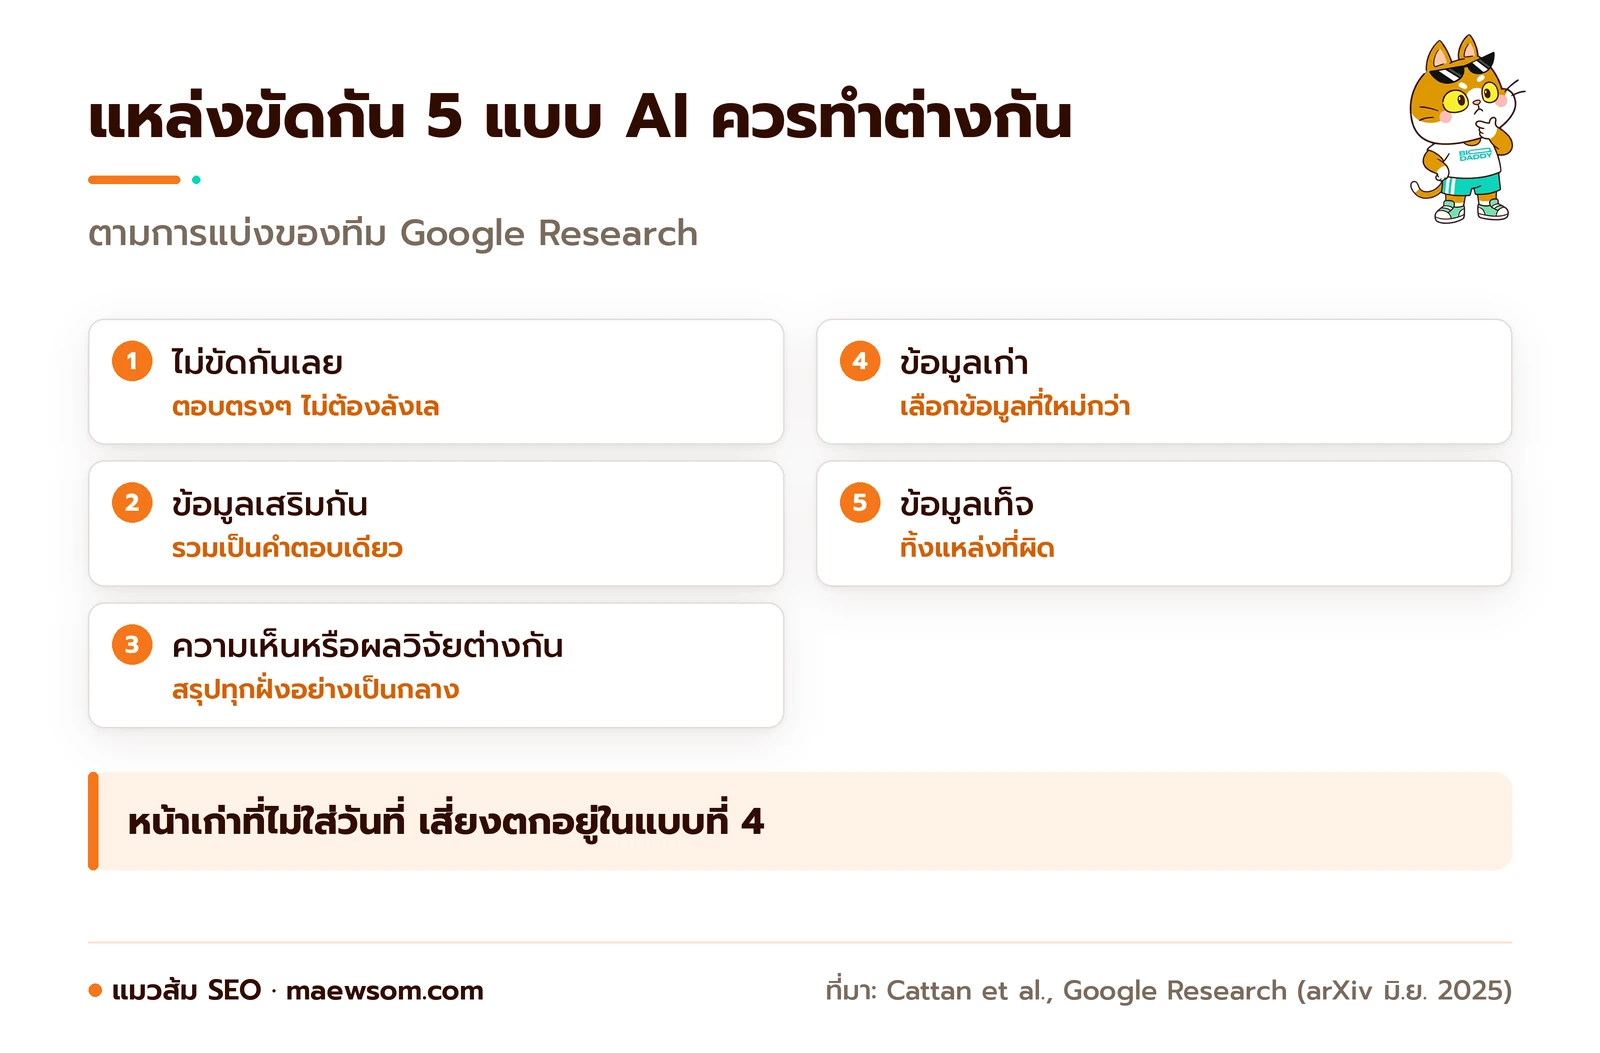
- ทีม Google Research แบ่งข้อมูลขัดกันเป็น 5 แบบ ในงาน DRAGged into Conflicts (Cattan et al., arXiv มิ.ย. 2025) คือ ไม่ขัดกันเลย ข้อมูลเสริมกัน ความเห็นหรือผลวิจัยต่างกัน ข้อมูลเก่า และข้อมูลเท็จ แต่ละแบบมีพฤติกรรมที่ควรเป็นต่างกัน คือ ไม่ขัดกันก็ตอบตรงๆ ข้อมูลเสริมกันควรรวมเป็นคำตอบเดียว ความเห็นต่างควรสรุปทุกฝั่งอย่างเป็นกลาง ข้อมูลเก่าควรเลือกข้อมูลใหม่กว่า และข้อมูลเท็จควรทิ้งแหล่งที่ผิด งานนี้พบว่า LLM ยังจัดการเรื่องนี้ได้ไม่ดีนัก
- LLM ชอบข้อมูลที่สถาบันยืนยัน แต่โดนการพูดซ้ำหลอกได้ งาน Whose Facts Win? (Schuster et al., ACL ก.ค. 2026) ทดสอบ LLM แบบ open-weight 13 ตัว พบว่าโมเดลเชื่อแหล่งอย่างหน่วยงานรัฐหรือหนังสือพิมพ์มากกว่าโพสต์โซเชียลของบุคคล แต่ถ้าแหล่งที่น่าเชื่อน้อยกว่าพูดข้อมูลเดิมซ้ำๆ ความชอบนี้กลับข้างได้
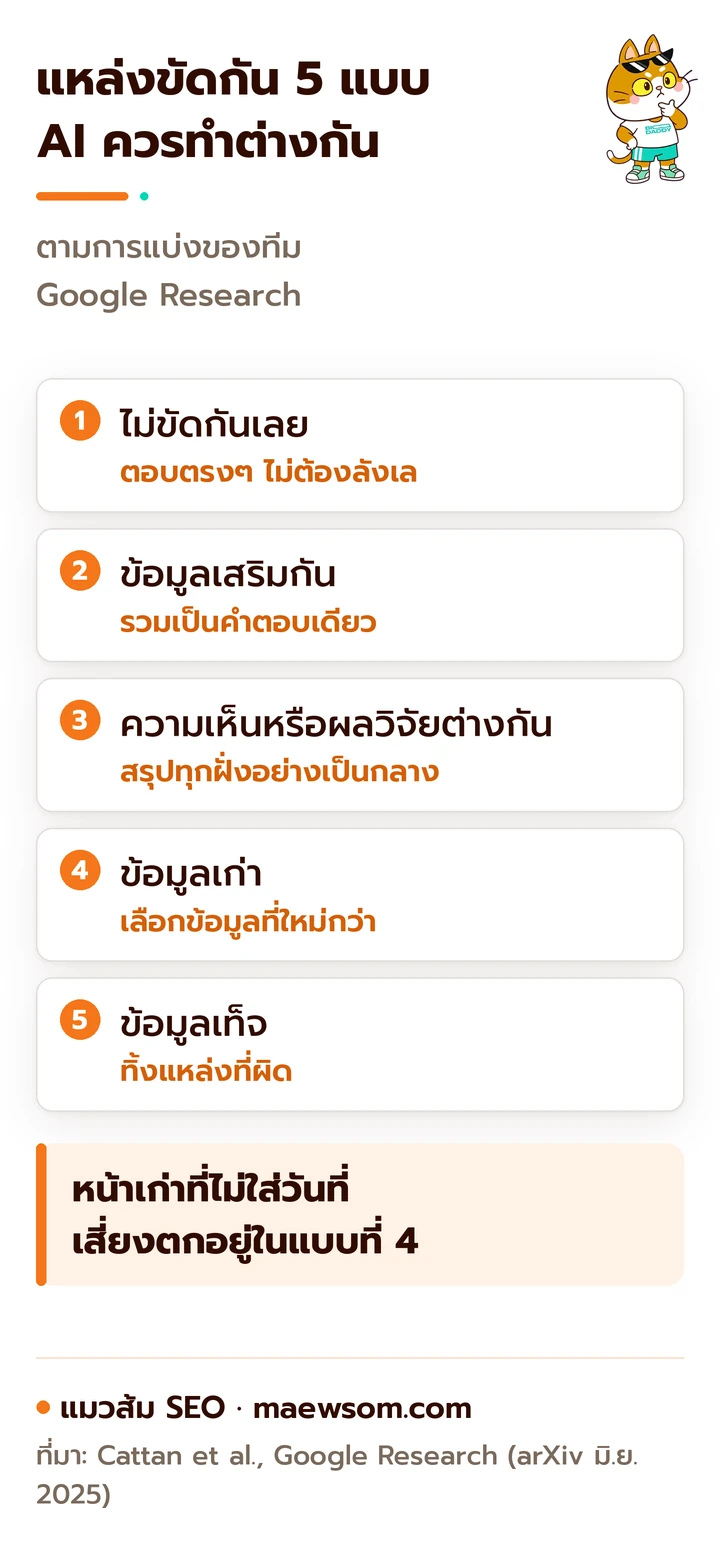
แปลเป็นงานที่ทำได้จริงคือ ข้อมูลสำคัญของธุรกิจ ทั้งราคา เวลาเปิด ที่อยู่ และสเปกสินค้า ต้องตรงกันทุกที่ และหน้าเก่าที่มีตัวเลขหมดอายุต้องแก้หรือบอกวันที่ให้ชัด เรื่องนี้เป็นพื้นฐานเดียวกับที่แมวส้มเล่าไว้ในคู่มือ AI SEO
ตัวอย่างจริงและวิธีทดสอบเองวันนี้
สมมติร้านกาแฟชื่อ “บ้านแมวส้มคาเฟ่” ขึ้นราคาลาเต้เป็น 75 บาท แก้ในเว็บแล้ว แต่โพสต์ Facebook เก่ากับเว็บรีวิวยังเขียน 65 บาท พอมีคนถาม AI ว่า “ลาเต้บ้านแมวส้มคาเฟ่ราคาเท่าไร” AI อาจตอบ 65 อาจตอบ 75 หรืออาจตอบว่า “ราคาอยู่ระหว่าง 65 ถึง 75 บาท” ซึ่งไม่ผิดในสายตา AI แต่ทำให้ลูกค้างง ลองเช็กของคุณเองตาม 4 ขั้นนี้
- เลือกข้อมูล 3 อย่างที่ลูกค้าถามบ่อย เช่น ราคา เวลาเปิด และเงื่อนไขส่งฟรี
- ถาม ChatGPT, Perplexity และ Google AI Mode ด้วยประโยคที่ลูกค้าพิมพ์จริง แล้วจดคำตอบกับลิงก์ที่มันอ้าง
- เปิดลิงก์ที่ AI อ้างทีละอัน ดูว่าคำตอบมาจากหน้าไหนของใคร และหน้านั้นอัปเดตล่าสุดเมื่อไร
- แก้ทุกจุดที่ข้อมูลไม่ตรง เริ่มจากเว็บของคุณเอง ตามด้วยโปรไฟล์ธุรกิจบน Google และโซเชียล แล้วใส่วันที่อัปเดตไว้บนหน้า
Source reconciliation ต่างจาก corroboration และ grounding ยังไง
สามคำนี้มักเจอในบทความเดียวกัน แต่ทำหน้าที่คนละช่วงของการตอบ ตารางนี้สรุปให้
| คำ | ตอบคำถามว่า | เกิดตอนไหน |
|---|---|---|
| Grounding | จะเอาข้อมูลจากไหนมาตอบ | ตอนดึงหน้าเว็บมาเป็นวัตถุดิบ |
| Corroboration | มีแหล่งอื่นยืนยันตรงกันไหม | ตอนตรวจว่าข้อเท็จจริงมีหลายแหล่งพูดเหมือนกัน |
| Source reconciliation | ถ้าแหล่งพูดไม่ตรงกัน จะเอายังไง | ตอนชั่งแหล่งที่ขัดกันก่อนเขียนคำตอบ |
คำถามที่พบบ่อย
คำที่เกี่ยวข้อง
- Corroboration การยืนยันข้อมูลจากหลายแหล่ง
- Grounding การให้ AI ตอบจากแหล่งข้อมูลจริง
- Factual accuracy ความถูกต้องของข้อเท็จจริง
- Hallucination อาการ AI แต่งคำตอบ
- Entities สิ่งที่ Google และ AI จำเป็นตัวตน
- อ่านต่อแบบเต็ม AI Search ทำงานยังไง เปิดเบื้องหลัง LLM, RAG และ Query Fan-out
- อ่านต่อแบบเต็ม Entity SEO ทำให้ Google และ AI รู้ว่าแบรนด์คุณคือใคร
แหล่งอ้างอิง
- DRAGged into Conflicts: Detecting and Addressing Conflicting Sources in Search-Augmented LLMs (Cattan et al., Google Research, arXiv, มิ.ย. 2025)
- Whose Facts Win? LLM Source Preferences under Knowledge Conflicts (Schuster, Gautam และ Markert, ACL 2026, ก.ค. 2026)
- Spam policies for Google web search (Google Search Central, อัปเดต 28 ส.ค. 2026)
- Reconciliation (Kalicube)
เขียนโดย
แมวส้มคือมาสคอตของทีม BIQDADDY เอเจนซี SEO และ AISO ในไทย เล่าเรื่อง AI SEO, GEO และ AEO แบบเข้าใจง่าย บทความเขียนด้วยระบบ AI ตามมาตรฐานของทีม ตรวจข้อเท็จจริงกับแหล่งต้นทาง และผ่านผู้ตรวจ AI อิสระก่อนเผยแพร่ ทีม BIQDADDY เป็นผู้ดูแลเว็บและแก้ไขเมื่อมีผู้แจ้งข้อผิดพลาด อ่านนโยบายการเขียน
เรียบเรียงเนื้อหาโดย วุฒิภัทร อุณหะกะ Co-Founder และ COO ของ BIQDADDY
อ่านต่อกับแมวส้ม
Zero-Click Search คืออะไร เมื่อคนค้นแล้วไม่คลิกเข้าเว็บ ต้องวัดผลยังไง
Vector Search คืออะไร การค้นหาด้วยความหมายที่อยู่เบื้องหลัง AI Search
Transformer Model คืออะไร ตัว T ใน GPT ที่ทำให้ AI เข้าใจภาษา