สารบัญ
robots.txt คืออะไร ไฟล์กฎที่บอกบอท Google และ AI ว่าเข้าตรงไหนได้
สวัสดีครับ แมวส้มเองครับ หน้าประตูเว็บคุณแปะป้ายใบเล็ก ๆ ไว้ได้หนึ่งใบ คนแทบไม่เคยเปิดดู แต่บอทของ Google และ AI อ่านก่อนเริ่มเก็บหน้าเว็บ ป้ายนั้นชื่อ robots.txt อ่านจบแล้วคุณจะอ่านป้ายของตัวเองออก และรู้ว่ามันกันอะไรได้บ้าง
robots.txt คือไฟล์ข้อความธรรมดาที่วางไว้ชั้นนอกสุดของเว็บ เช่น example.com/robots.txt ใช้บอกบอท (โปรแกรมที่วิ่งเข้าเว็บไปเก็บหน้าเว็บอัตโนมัติ) ว่าส่วนไหนของเว็บเข้าได้ ส่วนไหนขอไม่ให้เข้า ภาษาไทยอาจเรียกว่า “ไฟล์กฎสำหรับบอท” กติกาการเขียนไฟล์นี้เป็นมาตรฐานกลางชื่อ RFC 9309 ออกเมื่อ ก.ย. 2022
หรือจะพูดแบบภาษาบ้าน ๆ ก็คือ ป้ายหน้าบ้านสำหรับบอท นั่นเอง robots แปลว่า หุ่นยนต์ ในที่นี้คือบอท ส่วน txt มาจาก text แปลว่า ข้อความ
บอทของ Google, Bing และบริษัท AI อย่าง OpenAI จะเปิดอ่านไฟล์นี้ก่อนเริ่มเก็บหน้าเว็บ แต่เป็นเหมือนคำขอร้อง บอทที่สุภาพจะทำตาม บอทที่ไม่สุภาพอาจไม่สนใจเลย
robots.txt เปรียบง่ายๆ เหมือนอะไร
robots.txt เหมือนป้ายแปะหน้าบ้านว่า “แขกเข้าห้องรับแขกได้ ห้องเก็บของขอไม่ให้เข้า” แขกที่มีมารยาทจะเดินตามป้าย แต่ป้ายไม่ใช่กุญแจ ใครตั้งใจจะเข้าก็เปิดประตูได้อยู่ดี
อีกเรื่องที่คนมักลืมคือ ป้ายนั้นไม่ได้ซ่อนว่ามีห้องเก็บของอยู่ ถ้ามีคนอื่นพูดถึงห้องนั้น ชื่อห้องก็ยังเป็นที่รู้จักได้ หน้าเว็บก็เหมือนกัน
แมวส้มชอบภาพนี้ เพราะจำง่ายว่า robots.txt แค่ “ขอ” ไม่ได้ “ล็อก” แล้วถามว่า.. ป้ายเล็กแค่นี้ ทำไมคนทำ SEO ต้องสนใจ ไปดูกันต่อ
ทำไม robots.txt สำคัญกับ SEO, AEO และ GEO
robots.txt สำคัญเพราะมันตัดสินว่าบอทของ Google และของ AI จะเข้ามาอ่านเนื้อหาคุณได้ไหม ถ้าอ่านไม่ได้ ก็ยากที่จะได้ไปอยู่ในผลค้นหา (SEO) ในคำตอบสั้นๆ ที่ระบบหยิบไปตอบ (AEO) หรือในคำตอบของ AI อย่าง ChatGPT และ Gemini (GEO)
ถ้าถามว่า.. ต้องรู้อะไรบ้าง แมวส้มสรุปจาก Google ไว้ 3 เรื่อง
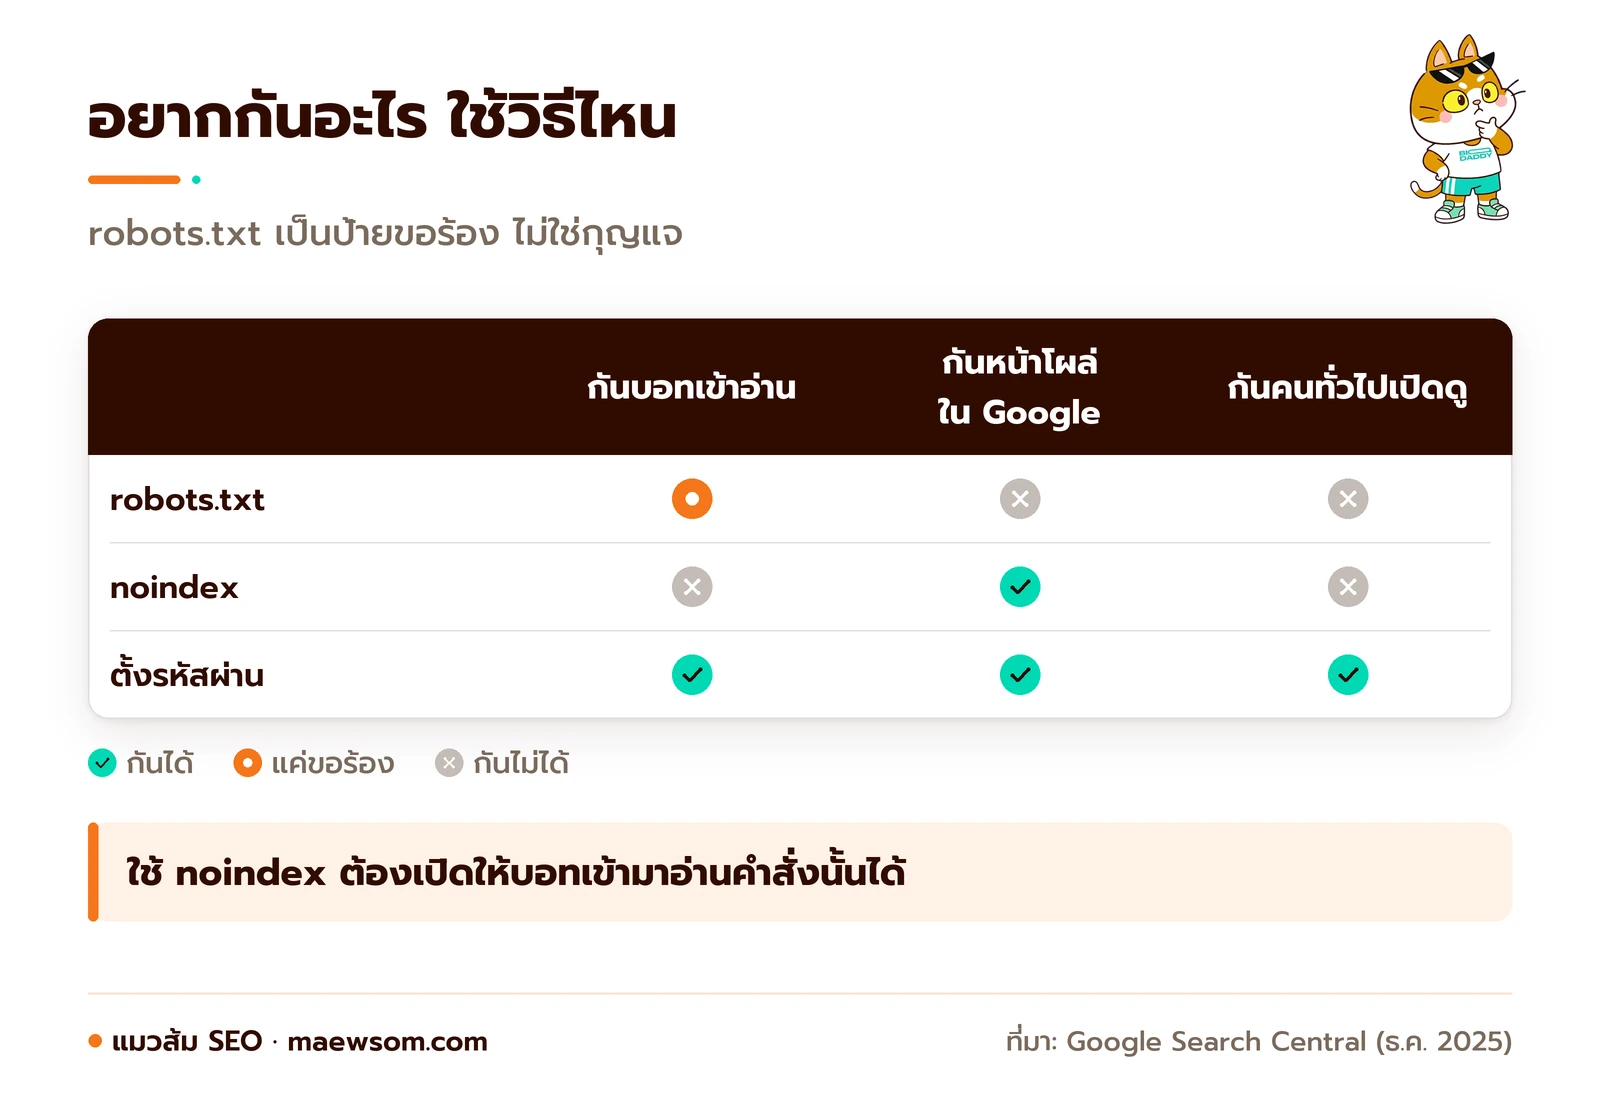
- ไม่ใช่วิธีซ่อนหน้าจาก Google Google (อัปเดต 10 ธ.ค. 2025) เขียนชัดว่า robots.txt มีไว้คุมปริมาณบอทที่เข้าเว็บ ไม่ใช่วิธีกันหน้าเว็บออกจาก Google ถ้าไม่อยากให้หน้าโผล่ ให้ใช้ noindex (คำสั่งในหน้าเว็บที่บอกว่าอย่าเก็บหน้านี้ไว้ในผลค้นหา) หรือตั้งรหัสผ่าน
- มีขนาดและเวลาที่ต้องรู้ Google (อัปเดต 23 ต.ค. 2026) อ่านไฟล์แค่ 500 KiB แรก (ราว 500 กิโลไบต์) และมักจำไฟล์ไว้นานสุด 24 ชั่วโมง แก้ไฟล์แล้วจึงอาจต้องรอราวหนึ่งวัน
- บอท AI แยกชื่อกัน แต่ละบริษัทตั้งชื่อบอทของตัวเอง เช่น GPTBot ของ OpenAI สำหรับเก็บข้อมูลไปฝึก AI ส่วน Google-Extended ใช้คุมว่าจะให้ Google เอาเนื้อหาไปฝึกและใช้ตอบใน Gemini ไหม Google ยืนยัน (อัปเดต 30 ต.ค. 2026) ว่า Google-Extended ไม่มีผลกับการติดอันดับใน Google Search
แมวส้มมองว่าข้อแรกสำคัญที่สุด เพราะจะใช้ noindex ได้ บอทต้องเข้ามาอ่านคำสั่งนั้นก่อน ถ้าบล็อกไว้ใน robots.txt บอทก็ไม่เห็นคำสั่งเลย
ข่าวดีคือเว็บส่วนใหญ่ไม่ต้องเขียนอะไรซับซ้อน ถ้า Google เปิดไฟล์ไม่เจอเลย (เซิร์ฟเวอร์ตอบรหัสกลุ่ม 4xx เช่น 404 ที่แปลว่าไม่พบไฟล์ ยกเว้นรหัส 429 ที่แปลว่าขอถี่เกินไป) Google จะถือว่าเข้าได้ทุกหน้า
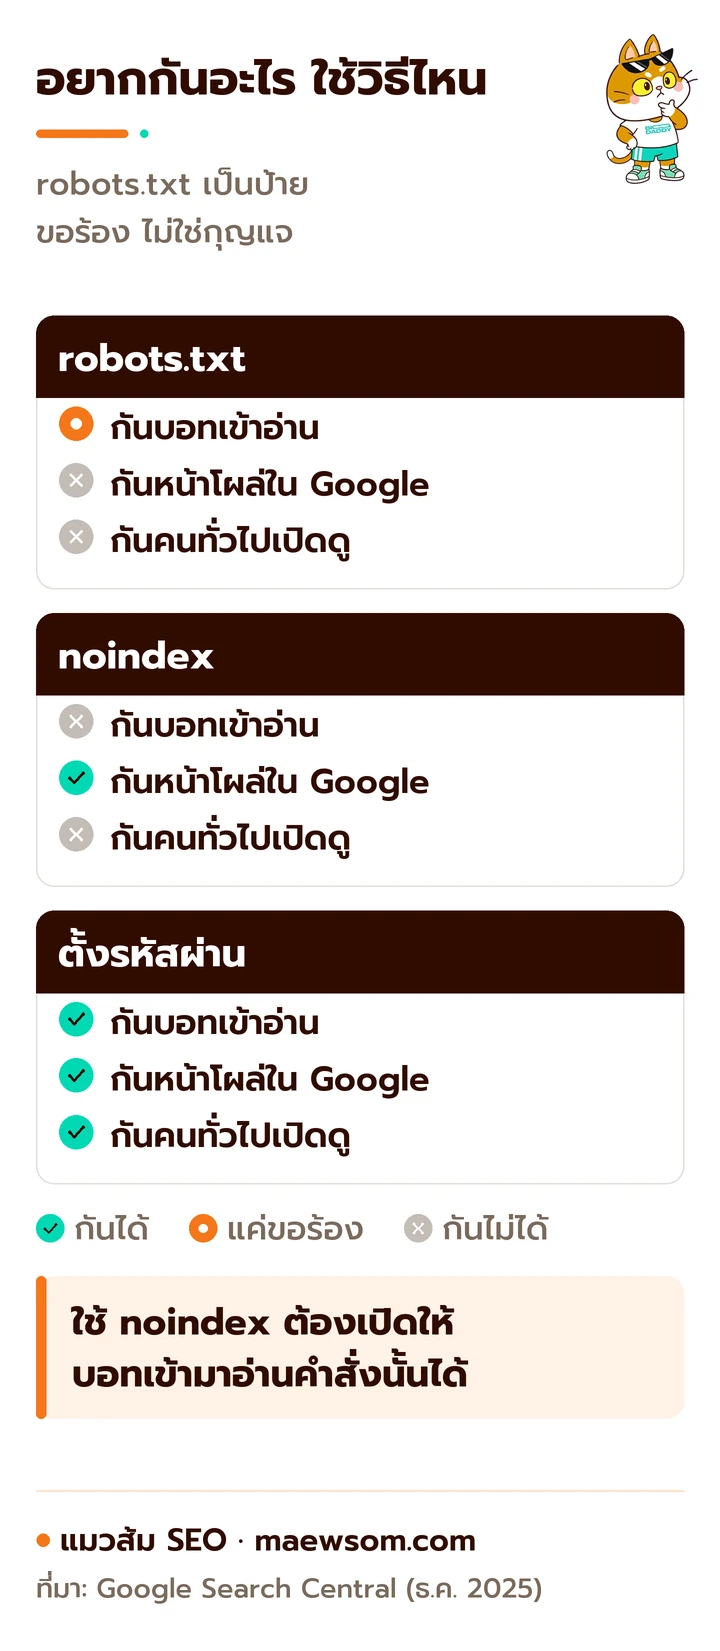
ทีนี้มาลองอ่านป้ายของจริงกันทีละบรรทัด
อ่านไฟล์ robots.txt จริงทีละบรรทัด
ไฟล์ robots.txt ใช้คำสั่งหลักแค่ไม่กี่คำ คือ User-agent, Disallow, Allow และ Sitemap ลองดูไฟล์จริงของ maewsom.com ที่แมวส้มเปิดดูเมื่อ 23 ต.ค. 2026 แมวส้มตัดบรรทัดหมายเหตุที่ขึ้นต้นด้วย # ซึ่ง Yoast ใส่ไว้ออก เหลือแต่คำสั่งจริง
User-agent: *
Disallow:

Sitemap: https://maewsom.com/sitemap_index.xml| คำสั่ง | แปลว่า | ในไฟล์ตัวอย่าง |
|---|---|---|
| User-agent | กฎกลุ่มนี้ใช้กับบอทชื่ออะไร | เครื่องหมาย * แปลว่าบอททุกตัว |
| Disallow | โฟลเดอร์หรือหน้าที่ขอไม่ให้เข้า | เว้นว่างไว้ แปลว่าไม่ได้ห้ามอะไรเลย |
| Allow | ข้อยกเว้นที่อนุญาตในโฟลเดอร์ที่ถูกห้าม | ไม่ได้ใช้ |
| Sitemap | ที่อยู่ของ sitemap (ไฟล์รายชื่อหน้าทั้งหมดในเว็บ) | ชี้ไปที่ sitemap_index.xml |
แมวส้มอยากให้สังเกตบรรทัด Disallow ที่เว้นว่าง มันต่างจาก Disallow: / แค่เครื่องหมายเดียว แต่ความหมายตรงข้ามกัน ตรงนี้พลาดแล้วเจ็บนะครับ
ถ้าอยากกันเฉพาะบอทตัวเดียว ก็เขียนกลุ่มใหม่ เช่น User-agent: GPTBot ตามด้วย Disallow: / (เครื่องหมาย / แปลว่าทั้งเว็บ) แต่ก่อนบล็อกบอท AI ตัวไหน ควรรู้ก่อนว่ามันทำหน้าที่อะไร ภาพข้างล่างคือไฟล์จริงของ BBC ที่เขียนกลุ่มแบบนี้ไว้
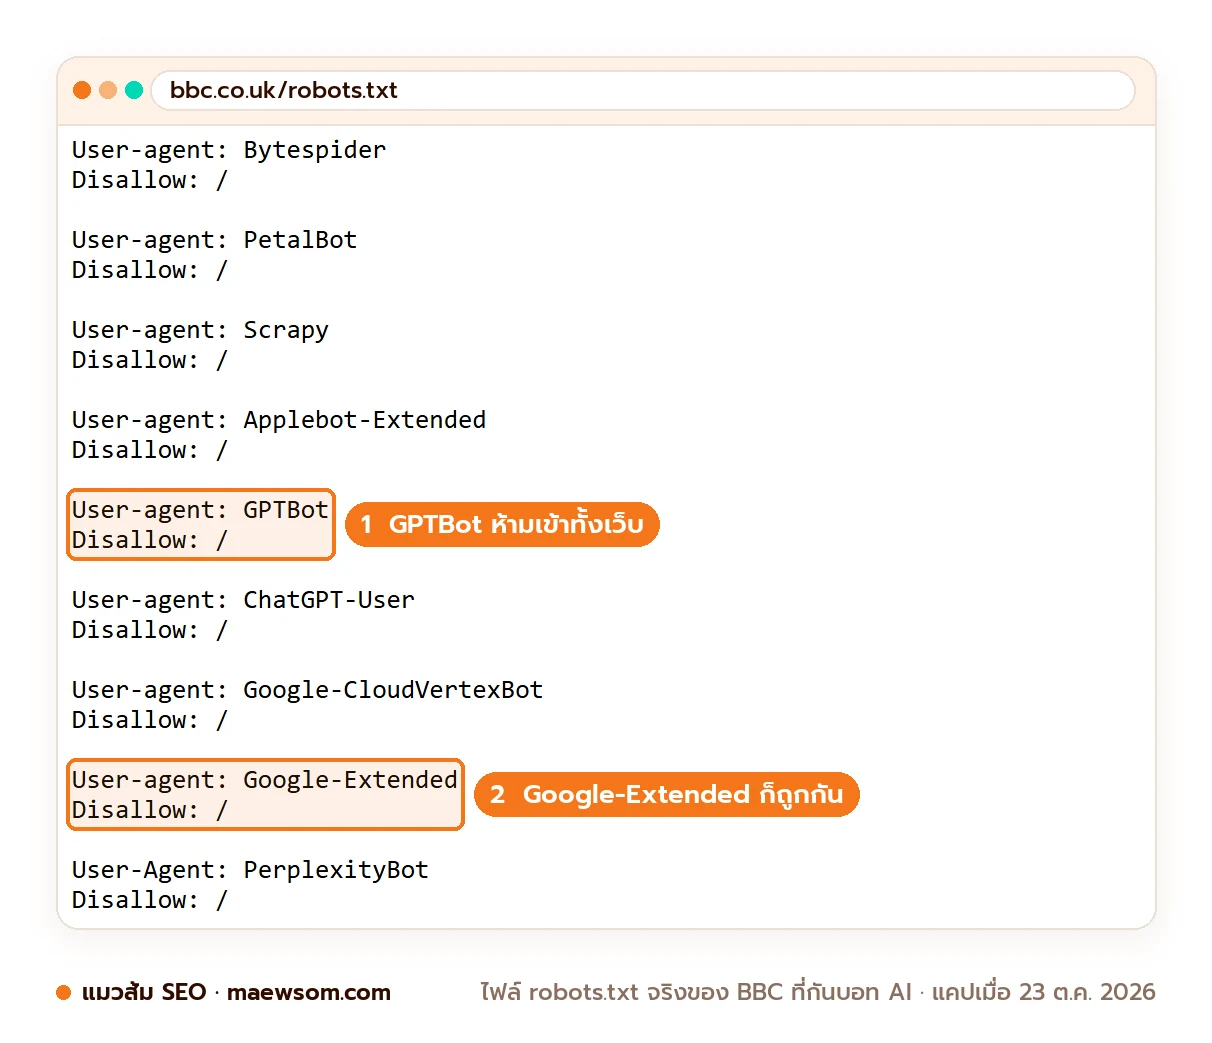
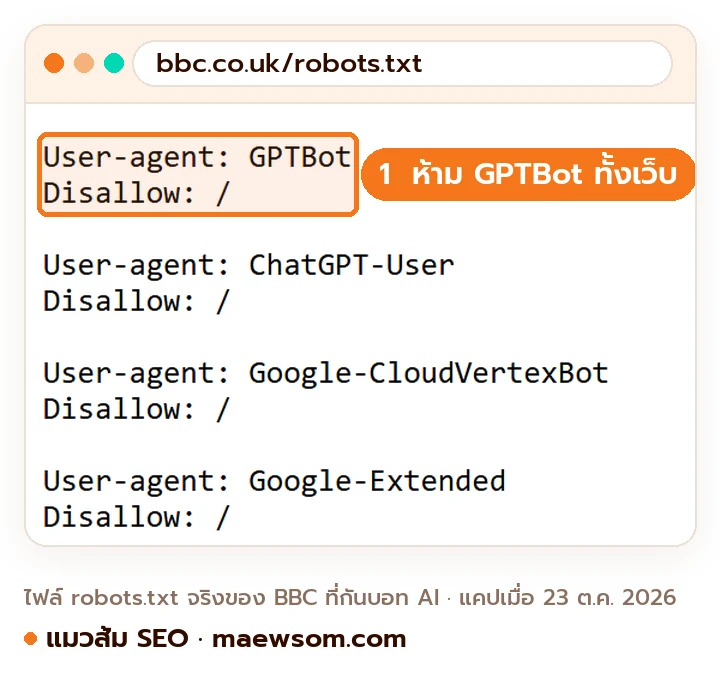
แมวส้มชอบตัวอย่างนี้ เพราะ BBC แยกกลุ่มทีละชื่อ หนึ่งในนั้นคือ Google-Extended ซึ่งไม่ใช่บอทแยกตัว แต่เป็นชื่อที่ Google ใช้รับคำสั่งเรื่องฝึกและใช้ตอบใน Gemini และ Google ยืนยันแล้วว่าไม่มีผลกับอันดับใน Google Search
เอาจริง ๆ อีกเรื่องที่สับสนบ่อยคือ robots.txt กับ llms.txt เป็นคนละไฟล์กัน robots.txt บอกว่าบอทเข้าตรงไหนได้ ส่วน llms.txt เป็นไฟล์สรุปเนื้อหาเว็บให้ AI อ่านง่าย ไม่ได้ห้ามใครเข้า ทีนี้ถึงตาเว็บคุณบ้าง
ลองเช็ก robots.txt ของคุณเองวันนี้
คุณเช็กได้ในไม่กี่นาที ไม่ต้องติดตั้งอะไร ทำตาม 3 ขั้นนี้ได้เลย
- พิมพ์ชื่อเว็บคุณตามด้วย /robots.txt ในเบราว์เซอร์ เช่น เว็บคุณ.com/robots.txt แล้วดูว่ามีบรรทัด Disallow: / อยู่ใต้ User-agent: * ไหม ถ้ามี แปลว่าคุณขอให้บอททุกตัวห้ามเข้าทั้งเว็บ
- ก๊อปเนื้อหาทั้งไฟล์ไปวางในเครื่องมือเช็กบอท AI ของแมวส้ม ดูผลว่า GPTBot, ClaudeBot และ PerplexityBot เข้าได้หรือถูกกัน
- ถ้าเจอว่าบล็อกบอทที่ไม่ได้ตั้งใจ ให้คุยกับคนดูแลเว็บ ต้นเหตุที่พบได้คือปลั๊กอินหรือการตั้งค่าตอนเว็บยังทำไม่เสร็จที่ลืมเอาออก
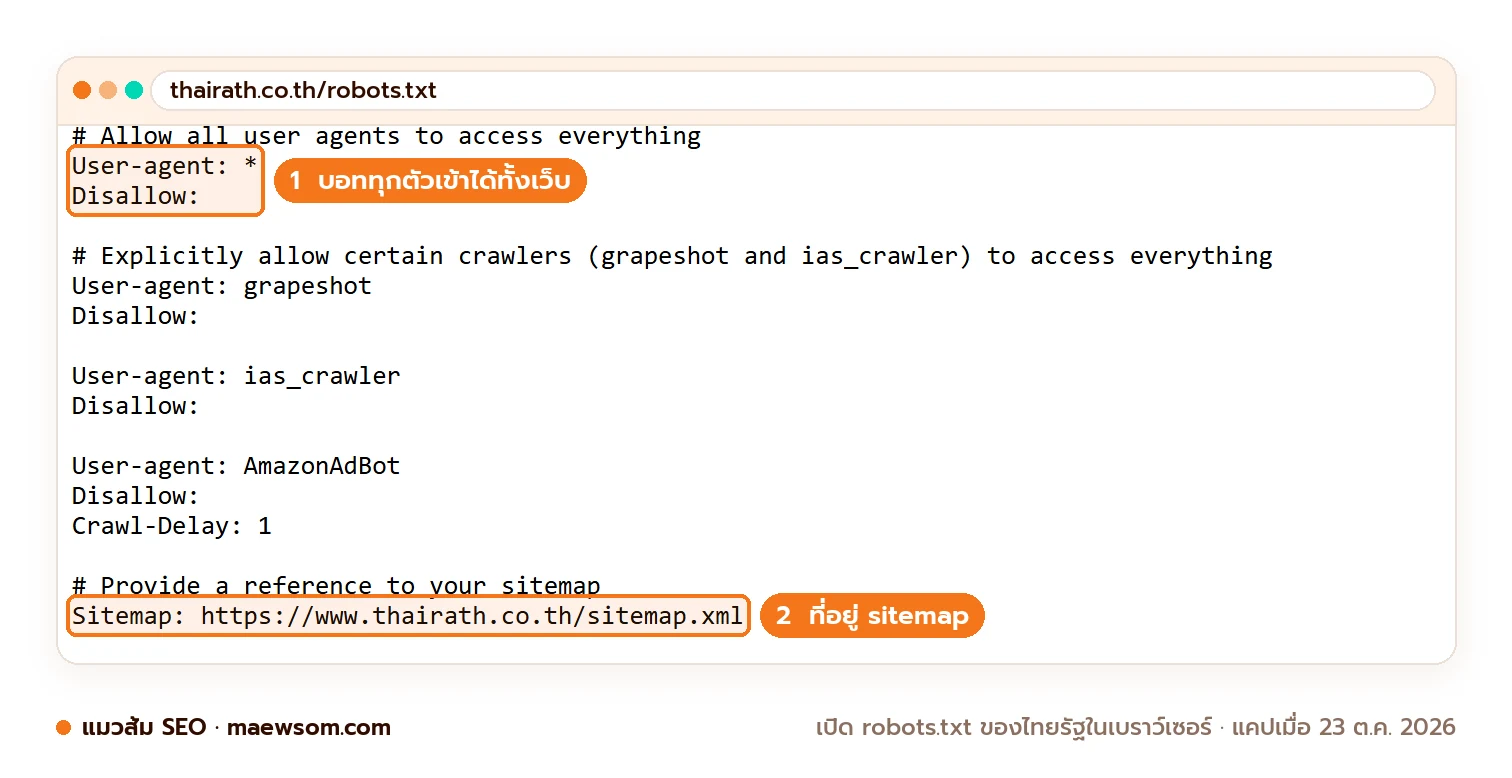
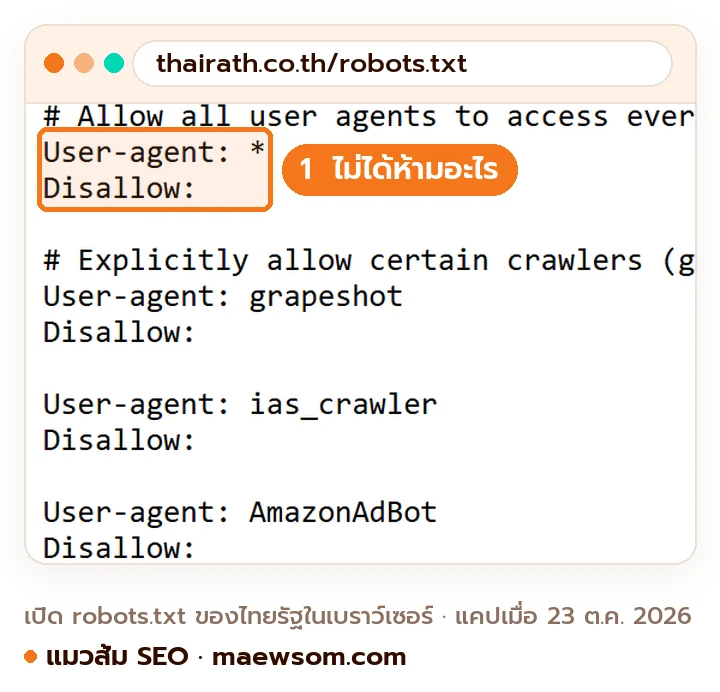
ถ้าให้แมวส้มเลือกขั้นเดียว แมวส้มเลือกขั้นที่ 1 เพราะใช้แค่เบราว์เซอร์ก็เห็นทันทีว่าป้ายคุณเขียนว่าอะไร ไฟล์ของ Thairath ในภาพคือหน้าตาของป้ายที่เปิดให้บอททุกตัวเข้า
ยังมีคำถามค้างอีกนิด แมวส้มรวบไว้ข้างล่างแล้ว
คำถามที่พบบ่อย
คำที่เกี่ยวข้อง
ถ้าให้แมวส้มเลือกอ่านต่อหน้าเดียว แมวส้มเลือกหน้า AI Crawler เพราะตอบต่อตรงที่สุดว่าควรบล็อก GPTBot ไหม
- GPTBot บอทของ OpenAI
- OAI-SearchBot บอทค้นหาของ ChatGPT
- IndexNow บอกเครื่องมือค้นหาว่ามีหน้าใหม่
- Rich Results ผลค้นหาแบบมีรายละเอียด
- อ่านต่อแบบเต็ม AI Crawler คืออะไร ควรบล็อก GPTBot ไหม และ AI Crawlability ทำให้บอท AI อ่านเว็บได้ครบ
แหล่งอ้างอิง
- Introduction to robots.txt (Google Search Central, อัปเดต 10 ธ.ค. 2025)
- How Google interprets the robots.txt specification (Google, อัปเดต 23 ต.ค. 2026)
- Google’s common crawlers (Google, อัปเดต 30 ต.ค. 2026)
- RFC 9309 Robots Exclusion Protocol (IETF, ก.ย. 2022)
เขียนโดย
แมวส้มคือมาสคอตของทีม BIQDADDY เอเจนซี SEO และ AISO ในไทย เล่าเรื่อง AI SEO, GEO และ AEO แบบเข้าใจง่าย บทความเขียนด้วยระบบ AI ตามมาตรฐานของทีม ตรวจข้อเท็จจริงกับแหล่งต้นทาง และผ่านผู้ตรวจ AI อิสระก่อนเผยแพร่ ทีม BIQDADDY เป็นผู้ดูแลเว็บและแก้ไขเมื่อมีผู้แจ้งข้อผิดพลาด อ่านนโยบายการเขียน
เรียบเรียงเนื้อหาโดย วุฒิภัทร อุณหะกะ Co-Founder และ COO ของ BIQDADDY
อ่านต่อกับแมวส้ม
robots.txt คืออะไร ไฟล์กฎที่บอกบอท Google และ AI ว่าเข้าตรงไหนได้
Digital PR คืออะไร พีอาร์ออนไลน์ที่ทำให้สื่อและ AI พูดถึงแบรนด์